VeRL-Omni v0.3.0 发布 支持异步多模态强化学习训练
VeRL-Omni 发布 v0.3.0,将异步执行扩展到更多多模态强化学习负载,并把 V1 训练器设为默认。该版本统一了生成、奖励评估、策略更新与权重同步的流水线,覆盖图像、视频、音频与多模态理解后训练,并提供 MiniMax H3 与 MiniCPM-o 4.5 两套端到端配方。
报道正文
本文目录8 个章节
VeRL-Omni v0.3.0:异步训练与更广泛的多模态后训练
继我们8 月的 v0.2.0 版本之后,VeRL-Omni v0.3.0 扩展了你在单一统一技术栈中可以用强化学习训练的内容。本次发布将异步执行引入更多多模态 RL 工作负载,使 V1 训练器成为所有人的默认选择,并扩大了在图像、视频、音频和多模态理解方面的后训练覆盖范围。在 v0.2.0 的 rollout 批处理与可复用模型适配器的基础上,本次的重点是让整条流水线协同工作:生成、奖励评估、策略更新和权重同步。
两个端到端配方展示了这在实践中意味着什么:使用 DiffusionNFT 进行 MiniMax H3 音视频后训练,以及采用共置同步或分离异步执行的 MiniCPM-o 4.5 GSPO。它们共同展示了一个重要的设计原则:正确的执行模式取决于你的工作负载。只有当 rollout 与训练的重叠能够抵偿分配给各角色的资源时,这种重叠才有帮助——而现在你拥有了精确衡量这一点的工具。
发布:v0.3.0 发布说明 · 代码:verl-omni · 上一版本:v0.2.0 博客
1. 异步与解耦的 RL 执行
多模态 RL 包含若干昂贵的阶段,每个阶段的资源需求各不相同。自回归模型可能花费很长时间生成响应;扩散模型要运行反复的去噪步骤;音视频奖励还会额外增加解码和评分器推理。严格交替的循环会让一个角色在另一个角色工作时处于空闲状态。v0.3.0 通过更丰富的执行路径集合打破了这一瓶颈:
- 完全异步 rollout 现将 Qwen3-Omni 训练扩展至文本和音频输入工作负载,使用发布说明中确认支持的 FSDP 配方。
- 分离异步 Omni 训练 将 actor 和 rollout 引擎置于独立的 GPU 池上。回放缓冲区连接生成与训练,而可配置的同步间隔控制 rollout worker 接收策略更新的频率。
- 分离异步扩散训练 受益于权重同步和动态混合 rollout 切换。当回放缓冲区不足时,共置的 actor 副本可借给 rollout 使用,并按需回收用于训练。
- 扩散在线策略蒸馏(OPD) 获得异步教师调度和独立教师路由,因此教师执行可以独立于 actor 进行管理。
这些变更的重点在于选择,而非一刀切的方案。下面的 MiniCPM-o 案例研究展示了为什么 GPU 分区、生成长度和训练器的关键路径应始终一起衡量。
2. 共享的 V1 训练基础
围绕 TransferQueue 和 ReplayBuffer 构建的 V1 训练器现已成为默认选项。v0.3.0 将 V1 同步配方扩展至扩散模型,同时加强了 rollout 与训练之间的交接:分组轨迹一起写入,减少不必要的数据读取,调度和批次排序获得额外验证。
Rollout 栈迁移至 vLLM 0.30.0 和 vLLM-Omni 0.30.0(12e9280)。生命周期变更使请求取消和策略更新更加明确:请求在暂停前被中止,睡眠/唤醒转换需要确认,权重更新失败会传播给调用方。当生成、内存回收和权重同步反复跨越执行边界时,这一点至关重要。
对于扩散工作负载,提示嵌入缓存避免了重复编码,rollout 序列并行和 VAE 并行暴露了额外的扩展控制。命名媒体产物使图像、视频、音频和潜在输出变得明确,因此奖励和导出器消费声明的输出,而不是从张量形状推断模态。
3. 配方与训练结果
3.1 MiniMax H3:联合音视频后训练
MiniMax H3 联合生成视频与音频,其后训练流水线必须在生成、奖励评估、actor 更新和导出各环节中同时保留这两种模态。v0.3.0 新增了基于 FlowGRPO 和 DiffusionNFT 的 H3 训练支持——这里我们重点介绍 DiffusionNFT 的 T2VA 和 FL2VA 案例研究。
T2VA 从文本生成音视频。FL2VA 默认是首帧图像到音视频。frame_mode / FRAME_INDICES 约定还支持 last 和 first_last;本案例研究使用 FRAME_INDICES='[0]'(仅首帧)。两者均使用 vLLM-Omni 进行 rollout,使用 Diffusers/FSDP2 进行 actor 训练,并使用 VeRL-Omni 进行编排、奖励计算和策略同步。在 FL2VA 中,条件帧的 latent 保持固定,而目标函数训练生成的内容。
DiffusionNFT 通过前向过程的训练目标应用奖励引导的优化,从而避免为每个反向去噪步骤保留转移对数概率。本案例研究使用 CLAP 进行文本-音频对齐评分,并使用 ImageBind 奖励(遵循 CC-BY-NC-SA 许可)进行音视频对应性评分。
该流水线将两条路径分开。vLLM-Omni rollout 引擎根据提示词生成音视频——对于本 FL2VA 案例研究,还会加上固定的首帧 latent——并将解码后的媒体路由到奖励评分器(CLAP 用于文本-音频对齐,ImageBind 用于音视频对应性)。与此同时,干净的 latent 和条件元数据流向 Diffusers/FSDP2 actor 进行训练。
T2VA 示例脚本将其默认值设为 ROLLOUT_TP=2 和 ROLLOUT_N=16。FL2VA 示例脚本使用 rollout ROLLOUT_TP=4 和 ROLLOUT_N=16。下表报告的是启动器默认值;它们描述的是该案例研究的配置,而非不同发布版本之间的性能对比。两个 DiffusionNFT 启动器都传入 trainer.use_v1=false:H3 FlowGRPO 在 v0.3.0 中已有 V1 同步配方,但这些 DiffusionNFT 启动器仍处于旧版 V0 路径,尚未迁移,因此下面的数字不应被解读为 V1 结果。一旦该迁移落地,V1 DiffusionNFT H3 配方便是顺理成章的后续工作。
| 设置 | T2VA | FL2VA |
|---|---|---|
| GPU 数量 / rollout 张量并行度 | 8 / TP=2 | 8 / TP=4 |
| 每个提示的样本数 | 16 | 16 |
| 训练 / 验证分辨率 | 256×384 / 512×768 | 288×448 / 576×928 |
| 帧数 | 121 | 请求 96;vLLM-Omni 对齐到下一个 17n+5 边界(107) |
| Rollout / 验证去噪步数 | 10 / 40 | 10 / 40 |
| LoRA rank / alpha | 64 / 128 | 64 / 128 |
| 奖励 | CLAP + ImageBind | CLAP + ImageBind |
在报告的 T2VA 运行中,critic/rewards/mean 从接近 0.27 开始,在大约 60 步内上升至接近 0.4。
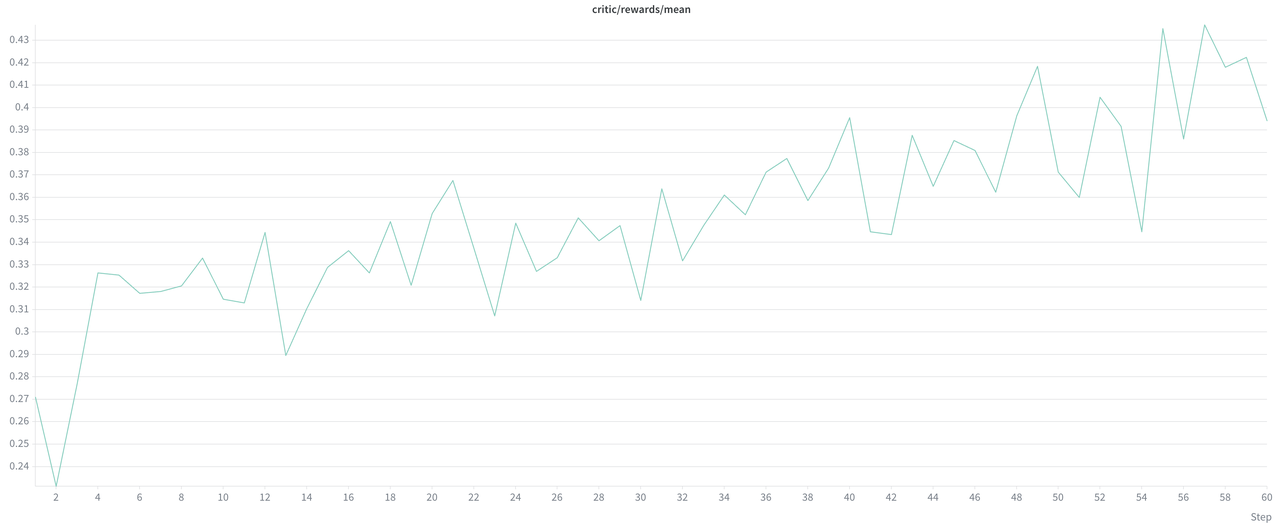
MiniMax H3 DiffusionNFT 训练奖励 报告的 T2VA 训练奖励。
注意: 奖励上升趋势表明所选奖励信号得到了优化;但这本身并不能证明视觉质量或时间一致性获得了普遍提升。下方的组件级验证奖励和固定样本输出提供了补充性检查。
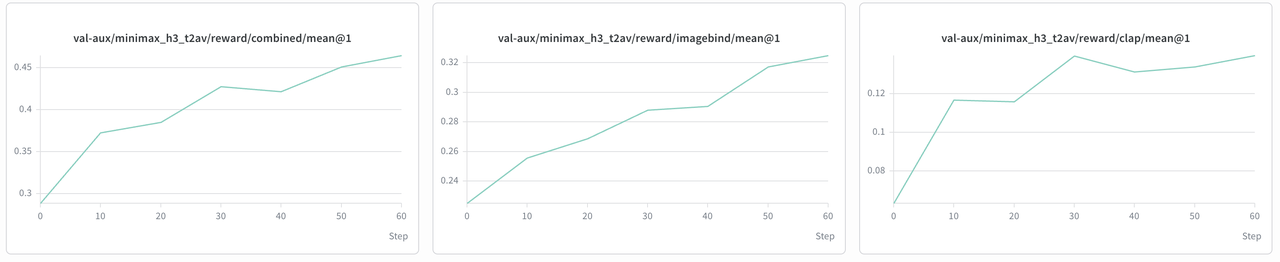
MiniMax H3 验证奖励组件 应将 CLAP、ImageBind 和组合验证奖励结合起来解读,而不是将聚合值视为完整的质量评估。
该案例研究使用相同的提示词、随机种子和推理设置,对比基础模型与训练后模型的输出。其中一个示例使用的提示词是:“17th century sailing ship making a path through the waves during a storm.”
左:MiniMax H3 基础模型。右:MiniMax H3 + DiffusionNFT。
定性示例转载自参考文章,并非全面的基准测试。这些预览为无声视频,无法展示音频质量或音画同步效果。
该集成还凸显了为何训练-推理一致性需要显式验证。H3 的训练引擎和 rollout 引擎使用不同的权重布局,需要将 LoRA 映射到融合后的推理投影中。其时间步和速度约定需要针对模型进行专门处理。此外,音频必须同时送达奖励模型和导出的输出。仅凭损失或奖励曲线的变化无法同时确立这三点。
你可以从 v0.3.0 H3 DiffusionNFT 配方 开始。
3.2 MiniCPM-o 4.5:GSPO,同步 vs. 分离异步
MiniCPM-o 4.5 Thinker 训练将组序列策略优化(GSPO)引入音视频问答(AVQA)。分离异步配方将 FSDP actor 和 vLLM-Omni rollout worker 放置在专用资源池上,并通过回放缓冲区让生成过程提前运行。
训练质量。 PR #629 报告了早期收敛情况高度接近:第 13 步的得分为 separate-async 0.764 对 colocated sync 0.762,第 10 步的验证奖励 两者均为 0.747。所附曲线显示,在两者重叠的训练窗口内,行为表现相似。
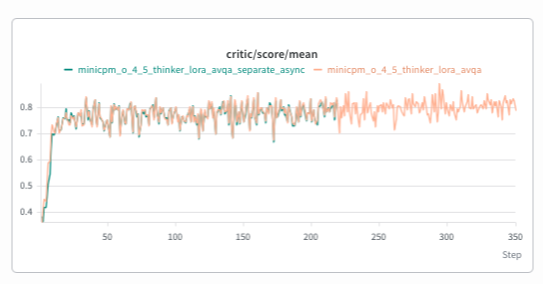
MiniCPM-o 4.5 AVQA GSPO 训练得分:separate-async 对 sync 训练平均得分随训练步数的变化。青色:separate-async;橙色:colocated sync。sync 运行在所示 async 运行结束后仍继续。
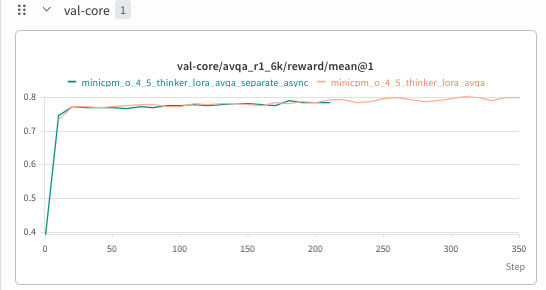
MiniCPM-o 4.5 AVQA GSPO 验证奖励:separate-async 对 sync 验证奖励随训练步数的变化。这些曲线支持在共享窗口内具有可比的学习行为;它们并不衡量达到目标质量所需的时间。
执行效率。 一项后续实验通过固定响应长度来探究放置决策。在单节点 4 × H800 80 GB 上,在恒定学习率下,它比较了 train_batch_size=128 的 colocated 4+0 (2×TP2) 与 train_batch_size=120、ppo_mini_batch_size=15 的 separate-async 3+1 (1×TP1)(每步八个 mini-batch:120 = 8 × 15)。两组无法共用 batch size 128:在 rollout.n=16 时,colocated 每步产生 128 × 16 = 2048 条轨迹,该数量不能被 3 个 FSDP rank 整除,而 120 × 16 = 1920 可以。由于 prompt 数量不同,表中同时报告了秒/步和秒/prompt;放置决策采用按 prompt 的视角。
| 平均响应长度(tokens) | 同机部署 4+0(2×TP2),batch 128 | 分离异步 3+1(1×TP1),batch 120 |
|---|---|---|
| ~101(自然) | 194.8 s/step · 1.522 s/prompt | 199.5 s/step · 1.663 s/prompt · 约慢 9% |
| 512(强制) | 259.7 s/step · 2.029 s/prompt | 244.7 s/step · 2.039 s/prompt · 大致持平 |
| 1024(强制) | 360.1 s/step · 2.813 s/prompt | 314.9 s/step · 2.624 s/prompt · 约快 6.7% |
稳态指单次运行中连续 20 步(第 3–22 步)的平均值——是连续步,而非独立试验。长度档位通过 rollout.ignore_eos=True + max_response_length=N 强制设定。每 prompt 数值为每秒/步除以该实验组的 train_batch_size。
在简短、自然的回答上,separate-async 3+1 每 prompt 约慢 9%。在 512 token 时,各实验组按每 prompt 计算大致持平。separate-async 在 512 token 与 1024 token 档位之间反超 colocated,在 1024 token 时达到每 prompt 约快 6.7%。原始每秒/步数据更早且以更大差距偏向 separate-async,但该比较夸大了收益,因为 async 组每步处理的 prompt 更少。
实用建议源自每 prompt 视角。对于回答简短、受训练器限制的工作负载,colocated sync 仍是合适的默认选择;当回答长到足以让生成占主导,且模型允许 TP1 rollout 副本时,3+1 式 separate-async 拆分可以胜出,且其优势随长度增长。
带标签的 separate-async 启动器默认使用 2 个训练器 + 2 个 rollout GPU,train_batch_size=128。在按配方文档所述准备好模型和 AVQA 数据后,要复现 3+1 / 120 实验:
bash examples/gspo_trainer/minicpm/run_minicpmo_4_5_thinker_gspo_lora_avqa_separate_async_v1.sh \
  data.train_batch_size=120 \
  actor_rollout_ref.actor.ppo_mini_batch_size=15 \
  trainer.n_gpus_per_node=3 \
  actor_rollout_ref.rollout.n_gpus_per_node=1
4. 模型与算法扩展
本次发布同时扩展了新的集成和现有模型系列。每一行标明具体的新增内容;现有模型获得新配方不计为新模型。
| 模型 / 范围 | v0.3.0 新增内容 | 参考 |
|---|---|---|
| MiniMax H3 | 用于文本、关键帧和参考条件音视频生成的 FlowGRPO 和 DiffusionNFT;GPU 和昇腾 NPU 配方 | FlowGRPO #368、DiffusionNFT #383 |
| BOOGU-Image | 用于文生图和编辑的 FlowGRPO;DiffusionNFT,包括一个无 CFG 的 Pick-a-Pic 配方 | #332、#765 |
| MiniCPM-o 4.5 | Thinker AVQA GSPO、分离异步 GSPO,以及针对纯图像/纯音频偏好批次的离线 DPO | #572、#629、#550 |
| Qwen3-TTS | GRPO、一个印地语 SFT-LoRA/GRPO 配方,以及一个通用 Talker RL 接口 | #428、#590 |
| FLUX.1-dev | DanceGRPO 训练 | #532 |
| LTX-2.3 | V1 同步 FlowGRPO 配方,以及昇腾 NPU 上的 T2AV OmniNFT LoRA | #574、#750 |
| Qwen3-Omni | 扩展了异步、DAPO、OPD、NPU GSPO 和 Megatron 配方的覆盖范围;支持的异步路径使用 FSDP | 发布支持详情 |
| SD3.5 | 直接组偏好优化(DGPO),附带一个 V1 OCR LoRA 配方 | #733 |
| 扩散蒸馏 | 独立的 DMD2 损失和配置 | #545 |
| 扩散 OPD | 异步教师调度和独立教师路由 | #427、#495 |
| Qwen-Image / Qwen-Image-Edit / Wan2.2 | 为现有算法提供更广泛的 V1 同步配方覆盖 | 发布配方列表 |
硬件覆盖范围也在扩大:统一的 Ascend Dockerfile 覆盖 A2、A3 和 A5,并新增了 AMD ROCm Dockerfile 和安装指南。可用性仍因 recipe 而异。VeOmni 后端集成进一步为 Qwen-Image 和 Qwen3-Omni 增加了 actor 训练选项。
5. 快速上手与升级说明
请根据你的模型、任务和硬件选择对应的 v0.3.0 recipe,然后按照匹配的安装说明进行操作。如果你要复用旧的启动器,请先检查以下变更:
- Trainer: V1 现在是默认选项(
trainer.use_v1=true);旧版 V0 已弃用。旧版入口点需要显式设置trainer.use_v1=false;在可用的情况下,请使用已迁移的 recipe。 - 离线 DPO 仍使用 v0: 它继续运行在 v0 trainer 上(#650),因此同样需要显式设置
trainer.use_v1=false——包括上表中的 MiniCPM-o 4.5 离线 DPO recipe,而不仅仅是尚未迁移的旧版脚本。 - 具名 diffusion 媒体产物: 未加标签的 diffusion rollout 张量现在会被拒绝(#557)。读取旧原始 payload 的自定义 rollout 适配器和 reward 客户端必须迁移到具名产物契约(
media_artifact__<name>和metadata.media_artifacts)。 - 注意力后端采用失败即报错策略: 缺少 FlashAttention kernel 时会在启动阶段报错,而不是静默回退到原生/SDPA 注意力(#530)。请安装缺失的 kernel 依赖,或显式选择受支持的注意力后端。
- 依赖项: 请使用 vLLM 0.30.0、vLLM-Omni 0.30.0(
12e9280)、Python 3.11+、Diffusers 0.40.0+,以及本发行版的 CUDA 13.0+ 技术栈。此前 v0.3.0rc1 的引擎版本锁定不再受支持。Ascend 用户应遵循更新后的固定环境。 - Qwen3-Omni 启动器: 请使用
verl_omni.trainer.main_omni和当前 recipe。旧的verl.trainer.main_ppo启动器和旧版 monkey-patch 已被移除。