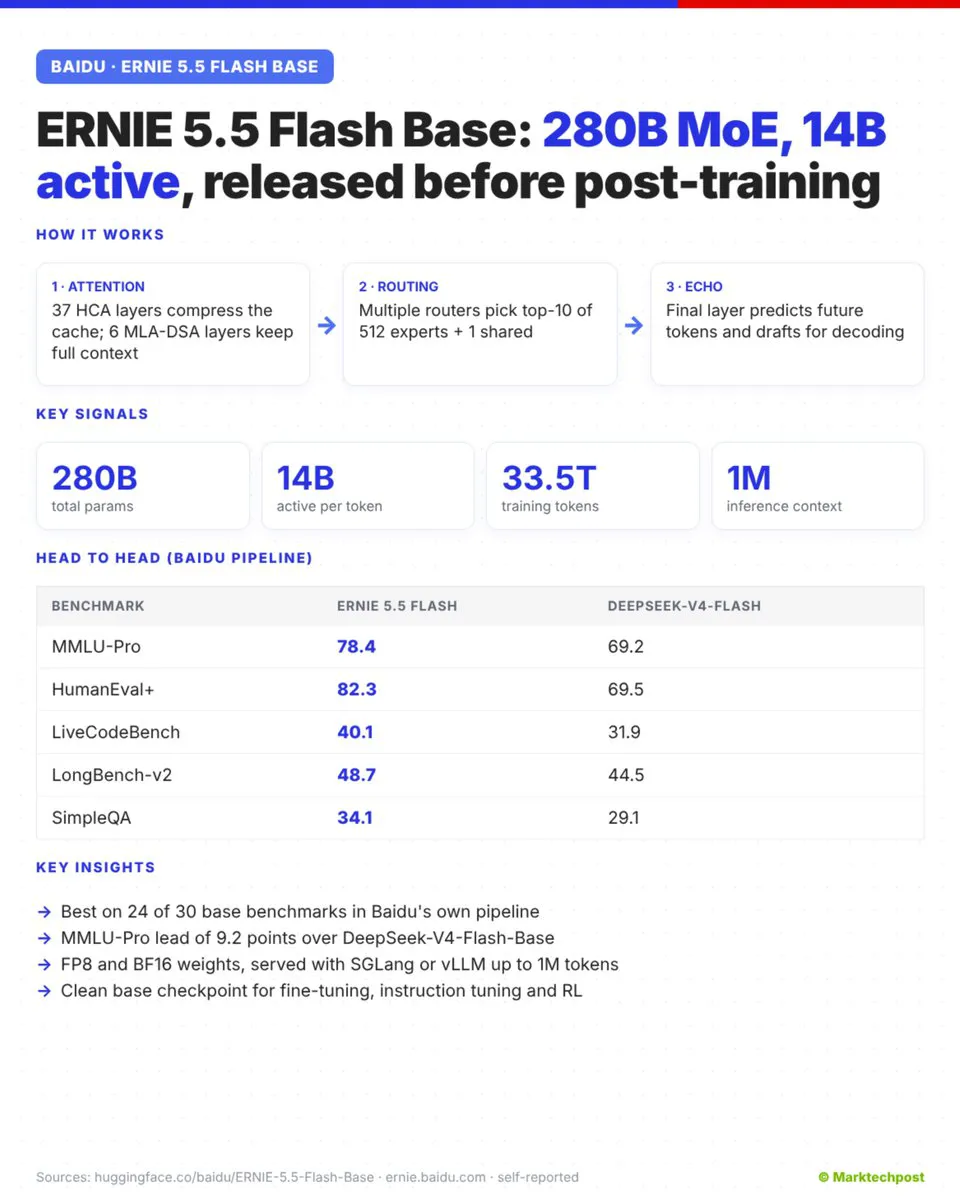
百度发布 ERNIE 5.5 Flash Base 280B 稀疏 MoE 模型
作者:▲ Marktechpost AI (@Marktechpost)原标题:▲ Baidu just released ERNIE 5.5 Flash Base, a 280B sparse MoE model shipped straight from pre-traini...
78AI 研判分
百度发布 ERNIE 5.5 Flash Base,这是一个 280B 总参数、14B 激活参数的稀疏 MoE 模型,直接来自预训练阶段,未经中期或后训练。其核心设计是效率优先:43 层中 37 层采用重度压缩注意力,每 128 个 token 仅缓存 1 条记录,多路由器从 512 个专家中选 top-10,末层兼作投机解码草稿模型。官方自报在 MMLU-Pro 与 HumanEval+ 上领先 DeepSeek-V4-Flash-Base,但在 HELMET-Rerank 上落后,且所有数据均为自报。
报道正文
▲ Marktechpost AI · 2026-11-05 21
▲ 百度刚刚发布了 ERNIE 5.5 Flash Base,这是一个 280B 稀疏 MoE 模型,直接来自预训练,没有经过中期训练或后训练。
其核心理念是“设计即高效”。它的 43 层中有 37 层使用重度压缩注意力(Heavily Compressed Attention),每 128 个 token 缓存 1 条条目。多个路由器从 512 个专家中选出前 10 个,而最后一层同时充当推测解码的草稿模型。
在百度的统一流水线中,它在 MMLU-Pro 上得分 78.4,而 DeepSeek-V4-Flash-Base 为 69.2;在 HumanEval+ 上为 82.3 对 69.5。不过这是一种权衡:它在 HELMET-Rerank 上落后于 DeepSeek(56.2 对 60.0),而且所有数字均为自报。
总参数 280B,激活参数 14B,训练 token 33.5T,推理上下文 1M token,提供 FP8 和 BF16 权重。
完整分析: