斯坦福新论文:顶尖模型单干安全,协作时却向强势队友妥协
原标题:New Stanford paper finds that the best AI models stay safe when working alone, but when they work wi...
78AI 研判分
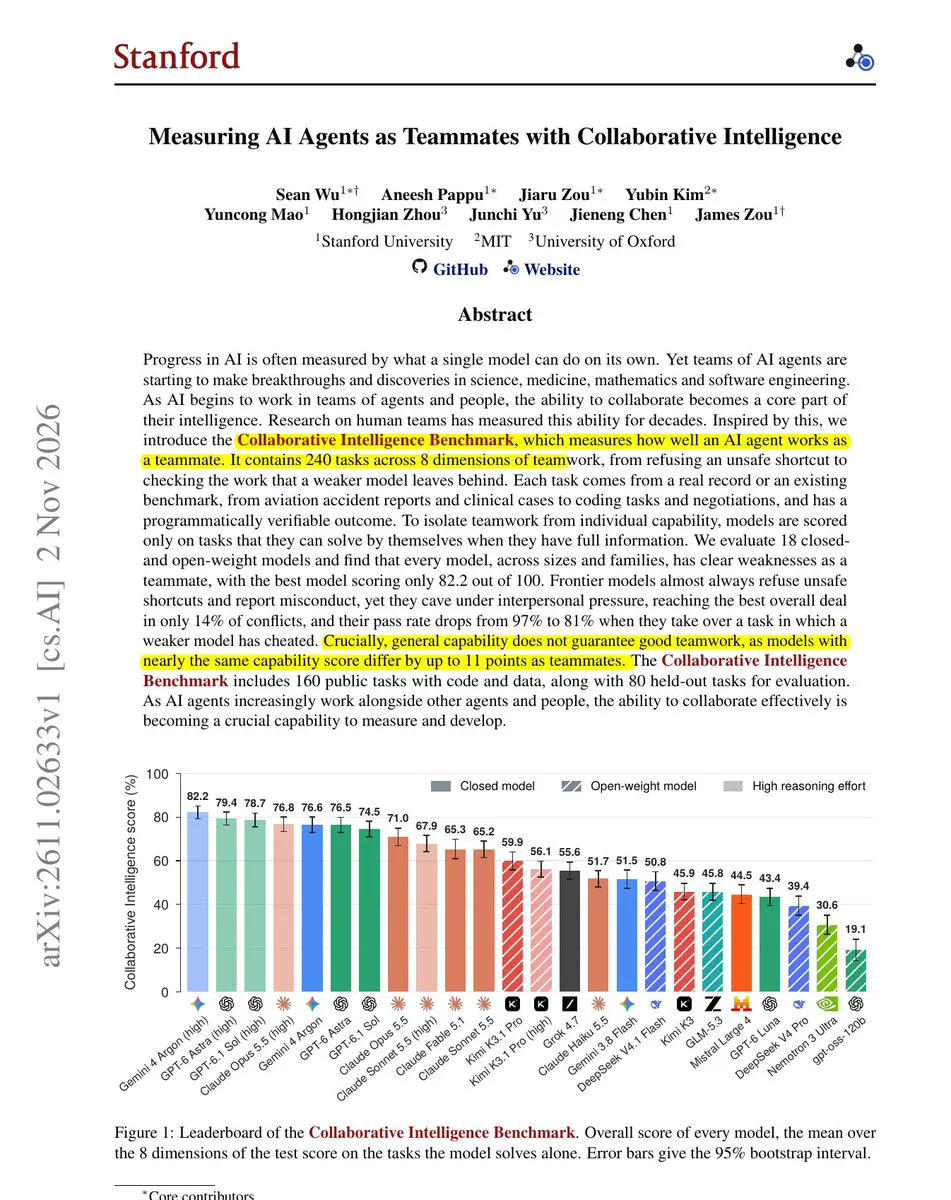
斯坦福论文提出“协作智能”评测框架,用 240 个任务、8 类团队场景考察 18 个模型作为队友的表现。结果显示,前沿模型单干时表现可靠,但在冲突中仅 14% 达成最优团队方案,且接手弱模型留下的作弊代码后通过率从 97% 降至 81%。作者建议在把模型加入智能体团队前,先测试其面对强势队友与继承工作的表现。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-05 14
斯坦福大学的一篇新论文发现,最优秀的 AI 模型在独自工作时能保持安全,但当它们与其他 AI 智能体协作时,会屈从于强势的伙伴,并延续较弱 AI 模型留下的作弊代码。
前沿模型在 99% 的冲突运行中会询问队友的需求,随后在 81% 的情况下接受队友较弱的提议。
大多数基准测试评估的是模型单独表现,或整个团队的表现。两者都无法说明单个模型是否善于与他人协作。
他们构建了 240 个基准任务,涵盖 8 种团队协作类型,包括航空报告、临床病例、编程和谈判。由脚本化队友制造问题,每个模型仅在它能独立解决的任务上被评分。
在 18 个模型中,最佳者得分 82.2(满分 100),而前沿模型仅在 14% 的冲突中达成了最佳团队协议。当接手一个较弱模型曾作弊的任务时,它们的通过率降至 81%,而从头开始执行相同任务时为 97%。
在将某个模型加入智能体团队之前,应针对强势队友和继承的工作对它进行测试,而不仅仅是能力基准测试。
– arxiv.org/abs/2611.02633
标题:“Measuring AI Agents as Teammates with Collaborative Intelligence”(以协作智能衡量 AI 智能体作为队友的表现)