阿里发布 2.4T 参数 Qwen4-Max 旗舰模型
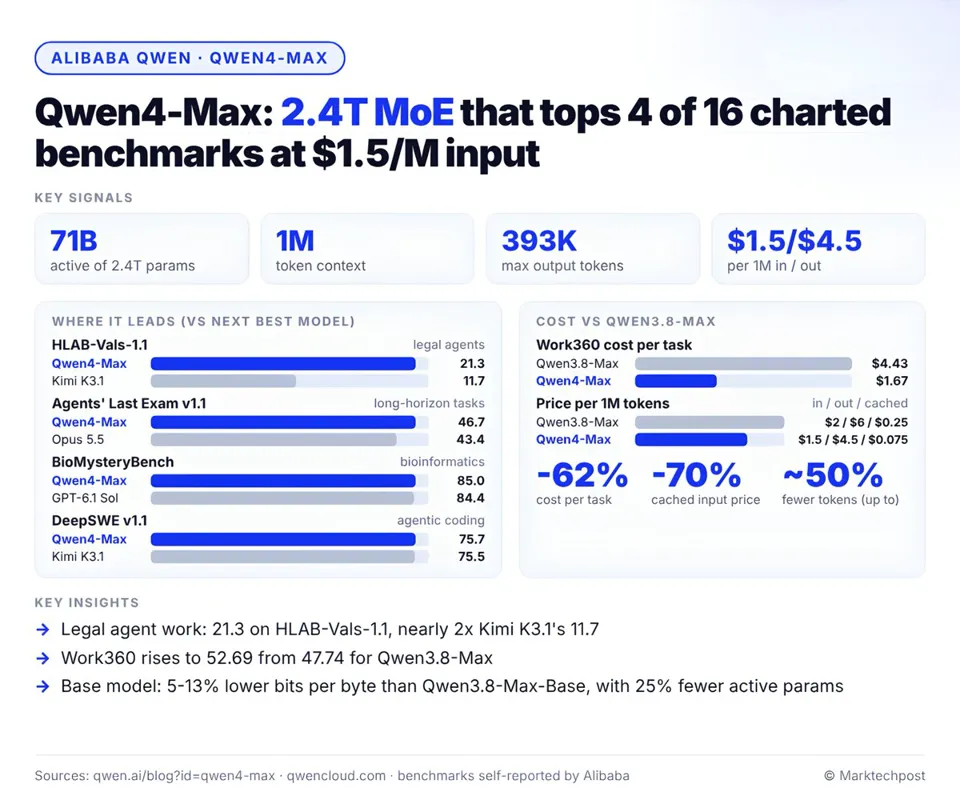
阿里巴巴发布 Qwen4-Max,采用 2.4 万亿参数稀疏 MoE 架构,单 token 仅激活 71B 参数,输入定价为每百万 token 1.5 美元。核心创新在于重建的稀疏 MoE 栈:3 层 Gated DeltaNet 为每层 Qwen Sparse Attention 压缩历史,配合轻量索引器选取上下文,并叠加 4 条门控残差分支与 328B N-gram Embedding 参数。该模型在 16 项基准中的 4 项登顶,但编程与终端任务明显落后于 Claude Opus 5.5 与 Kimi K3.1,呈现明显的取舍。
报道正文
▲ Marktechpost AI · 2026-11-16 09
▲ 阿里巴巴刚刚发布了 Qwen4-Max,这是一款 2.4T 参数的 MoE 旗舰模型,每个 token 仅激活 71B 参数,输入 token 成本为每百万 1.5 美元。
其核心创新在于重建的稀疏 MoE 架构。3 个 Gated DeltaNet 层为每个 Qwen Sparse Attention 层压缩历史信息,后者通过轻量级索引器选取上下文。4 个门控残差分支和 328B 的 N-gram Embedding 参数以极小的额外算力换来了容量提升。
在阿里巴巴的图表中,它在 16 项基准测试中有 4 项排名第一,包括 HLAB-Vals-1.1(21.3,对比 Kimi K3.1 的 11.7)和 DeepSWE v1.1(75.7,对比 Claude Opus 5.5 的 74.2)。Work360 每任务成本从 4.43 美元降至 1.67 美元。不过这也是一种取舍:ProgramBench 为 31.5,对比 Opus 5.5 的 65.0;Terminal-Bench 4.0 为 48.5,对比 Kimi K3.1 的 67.2……
完整分析: