语言模型用代码生成 3D 场景挑战视频模型
原标题:Can language models make better videos than video models?
72AI 研判分
Artificial Analysis 发起对比测试,让 OpenAI GPT-6.2 Astra 以 three.js 代码构建悉尼歌剧院、机械表爆炸图与巨龙袭击中世纪城镇三个 3D 场景,并用浏览器脚本相机以 15 秒 1080p 24fps 输出视频;字节跳动 Dreamina Seedance 2.5 以相同相机路径和参考图作为文本提示生成对照视频。测试意在检验语言模型能否在动态影像生成上与专用视频模型竞争。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-11-20 00
语言模型能做出比视频模型更好的视频吗?
LLM 如今可以制作动态图形、以代码方式剪辑视频,还能驱动 Blender 搭建 3D 场景。那么,LLM 能否与视频生成模型一较高下?
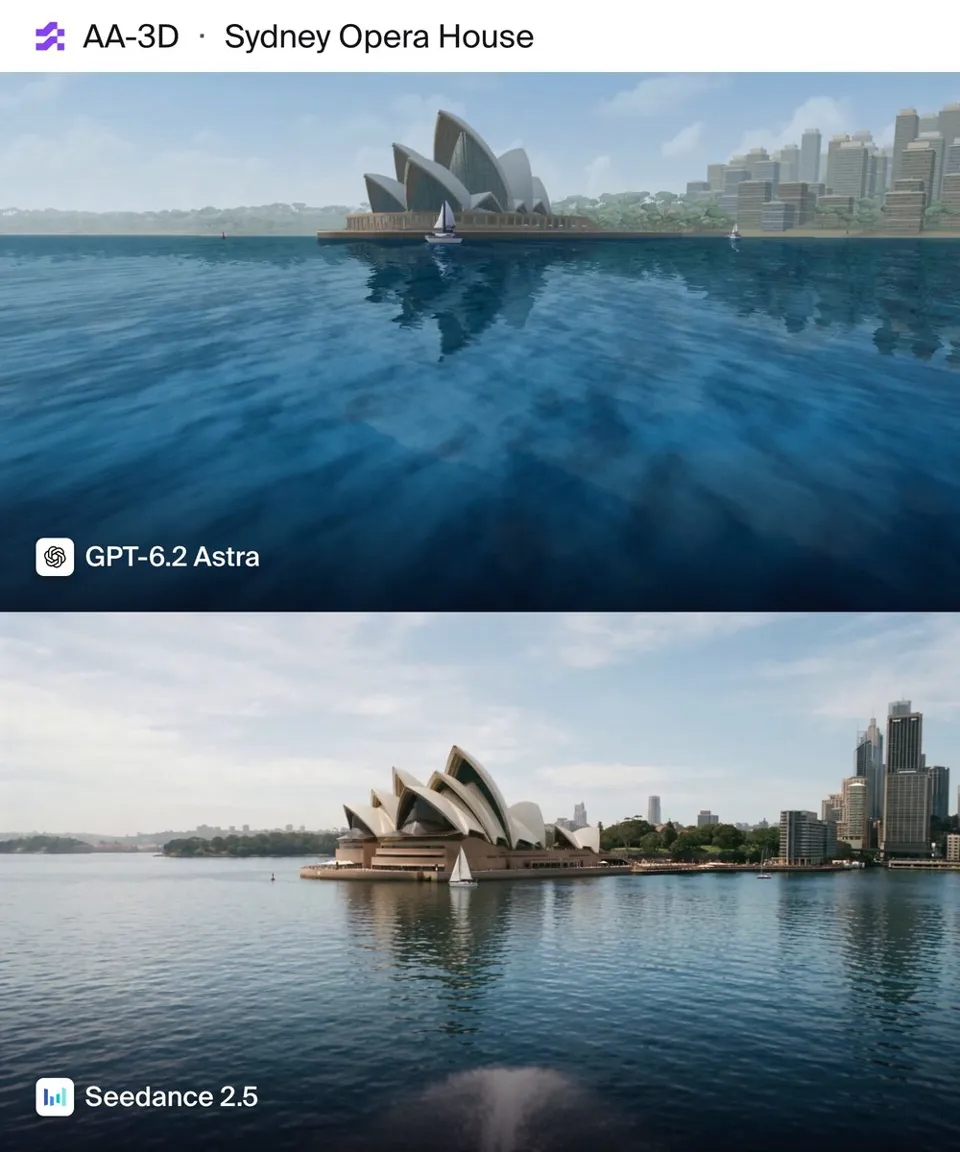
我们用来自 @OpenAI 的 GPT-6.2 Astra——当前 AA-3D 榜单排名第一——进行了测试,让它以 three.js 代码构建悉尼歌剧院、一枚爆炸视图的机械腕表,以及一条袭击中世纪小镇的巨龙。我们在浏览器中让一台按脚本运动的摄像机穿过每个场景:15 秒、1080p、24 fps。
来自 @ByteDanceSeed_ 的 Dreamina Seedance 2.5 则以文本提示加路线参考图像的方式,在相同设置下获得了相同的摄像机路径。
➤ 上:GPT-6.2 Astra(LLM,AA-3D)
➤ 下:Dreamina Seedance 2.5(视频模型,AA-Video-T2V)