Artificial Analysis (@ArtificialAnlys) · 2026/10/24 07:19:42
Meta Muse Spark Open 实测:42B 激活参数实现高能效推理
Artificial Analysis 发布 Meta 新开源模型 Muse Spark Open 的基准测试结果。该 MoE 架构模型(总参 816B,激活 42B)在 NVIDIA GB300/B300 上展现出极高的每瓦吞吐率,且通过滑动窗口注意力机制大幅降低长上下文 KV 缓存需求。
报道全文原始报道全文
Artificial Analysis (@ArtificialAnlys) · 2026-10-23 23
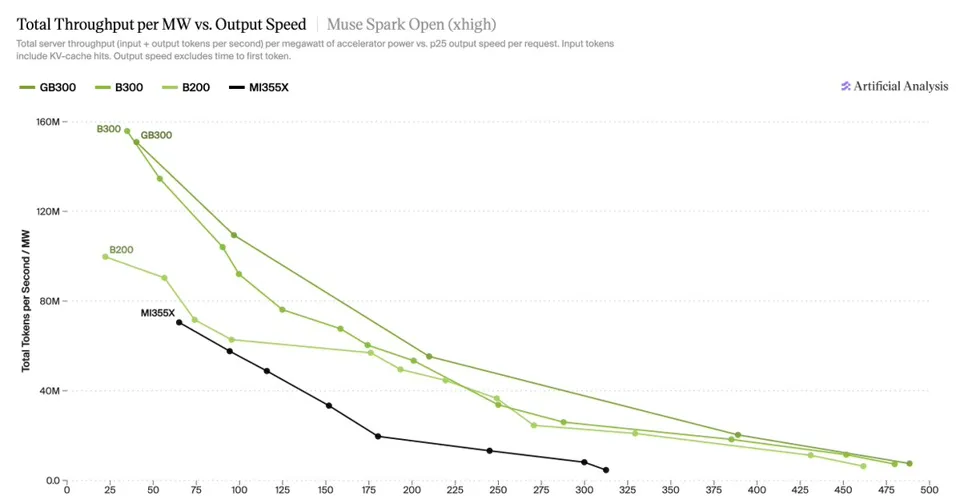
Meta 最新发布的 816B(激活参数 42B)开源权重模型 Muse Spark Open 在 AA-AgentPerf 上的测试结果现已上线。在我们的初步测试中,该模型在 4x NVIDIA GB300 或 B300 GPU 上,每兆瓦功耗的吞吐量最高可达约 1.5 亿 tokens/s。
Muse Spark Open 在 Artificial Analysis 智能指数中得分为 39。它是一个 MoE 模型,共有 62 层,其中 46 层采用 2,048-token 滑动窗口注意力机制,相比全注意力机制,在 1M 上下文长度下将 KV Cache 需求降低了约 75%。Meta 发布了 NVFP4 检查点,AMD 发布了 MXFP4 检查点,我们分别将其用于 NVIDIA 和 AMD 硬件的测试。
初步结果:
➤ NVIDIA B300 和 GB300 领先,在面向高吞吐量(较低单用户速度)的配置下,两者均达到每兆瓦约 1.5 亿 tokens/s 的吞吐量。在较高输出速度下(100 tok/s),GB300 表现更优(约 1.08 亿 vs 约 9200 万),但截至目前两者仅在聚合服务配置下进行了测试,我们预计随着多节点分离式配置的引入,GB300 对 B300 的优势将进一步扩大。
➤ 服务配置正在快速优化。在同一 B300 节点上,NVIDIA 调优后的 SGLang 配置在 50-100 tok/s 速率下,每兆瓦吞吐量约为发布周 cookbook 配置的 1.6-1.8 倍。这些增益来自 TP4 部署以及针对并发量调优的预填充-解码间隔,代价是首 token 延迟时间变长。
➤ AMD MI355X 在 65 tok/s 时达到每兆瓦 7000 万 tokens/s 的吞吐量,在 65 到 100 tok/s 区间内约为 B200 的 0.9 倍。AMD 于 10 月 22 日更新的配方(包括预填充-解码和调度器间隔、更多 tokenizer 工作进程、为全注意力层分配更多 KV Cache)使其每兆瓦性能较早期配方提升了约 1.7 倍。
我们将继续测试 Muse Spark Open 的服务配置,包括多节点分离式架构,并每周更新排行榜,展示目前发现的最佳结果和配置。此外,我们还将发布关于 Muse Spark Open 在内核、推理引擎及配置优化方面进展的深度评测。