DeepX 流片二代边缘 AI 芯片 5 W 内跑 100B 模型
韩国边缘 AI 芯片初创公司 DeepX 已流片第二代 AI 加速器 DX-M2,借助三星定制的存内计算(PIM)技术,在低于 5 W 的功耗预算内实现最高 1000 亿参数模型的端侧推理,输出速度 10-30 tokens/s。相比已量产的视觉向一代芯片 DX-M1,DX-M2 的核心跃升在于内存带宽提升至三倍,目标市场为机器人、无人机等生成式 AI 边缘设备。
报道正文
本文目录5 个章节
DeepX 瞄准包括机器人在内的边缘市场,其第二代 AI 加速器可在 5 W 以下功耗下于设备端运行大型 LLM。
作者:Sally Ward-Foxton 2026年11月9日 0
韩国边缘 AI 芯片初创公司 DeepX 已流片其第二代 AI 加速器,该加速器采用了三星的定制存内计算(PIM)技术。DX-M2 旨在将生成式 AI 引入机器人、无人机及其他边缘设备,能够在低于 5 W 的功耗下对多达 1000 亿参数的模型进行推理。
DeepX 的第一代芯片 DX-M1 目前已进入量产阶段,面向视觉应用。新近流片的 DX-M2 旨在使本地 AI 成为功耗和散热预算紧张设备的实用选择。该芯片设计用于以每秒 10 至 30 个 token 的速度运行 200 亿至 1000 亿参数的模型(约 30 亿至 200 亿活跃参数),具体取决于模型。这是在与 M1 相同的功耗预算——仅 5 W——内实现的。
“(M1 与 M2 之间)最重要的变化是内存带宽,”DeepX 创始人兼 CEO Lokwon Kim 对《EE Times》表示。
内存带宽从 50 GB/s 提升至 150 GB/s,增长了两倍,但还有其他多项效率提升。DeepX 表示,得益于设计改进,其 NPU 的能效翻了一番,而迁移至 2 纳米工艺节点又使其再翻一番。现在可实现 80 TOPS。
合作伙伴内容 查看全部  推进集成光学:Celestica 与 Broadcom 在 OCP 全球峰会上的访谈
 为 AI 数据中心供电:为下一波 AI 增长重新思考能源基础设施
 Infineon 高管 Andreas Urschitz 和 Maher Matta 谈 OktoberTech 十年历程
“这一点很重要,因为凭借 5 W 的功耗,我们可以将其应用到任何地方,无论是无人机还是其他任何电池供电设备,”Kim 表示。“我们的目标是让复杂 AI 能够在所有设备中部署。”
M2 能够处理大型混合专家(MoE)LLM,并支持包括推测解码和 TurboQuant 在内的新技术。
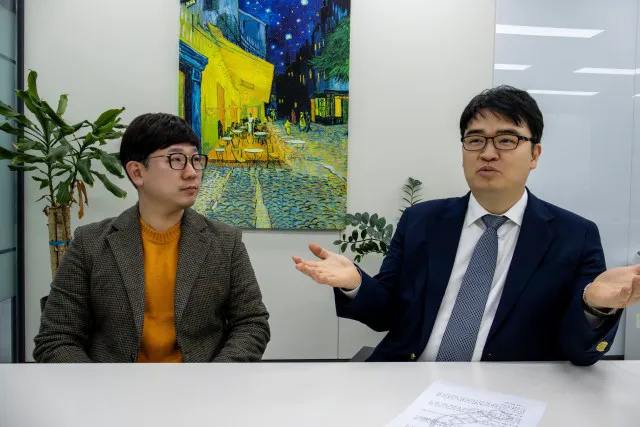
DeepX 的 Tim Park(左)和 Lokwon Kim(来源:DeepX)
存内处理器
大多数类型的 AI 推理操作都受限于在内存与计算单元之间搬运权重,尤其是 GEMV(通用矩阵-向量乘法),该过程需要随机内存访问,从而拖慢计算速度。内存厂商提出了 PIM 方案,使得诸如 GEMV 这类受内存限制的操作可以在内存芯片内部完成计算。在内存内执行操作可提高有效内存带宽,并减少耗时的内存访问时间。
PIM 即将成为 LPDDR6 的 JEDEC 标准。然而,DeepX 一直在与三星合作,将 DX-M2 与三星的 LPDDR5x-PIM 进行集成。
“我们在这项技术上花了一年半的时间,与三星内存合作,因为他们已经有针对 LPDDR5x 的定制 PIM,”Kim 说。“我们已经收到了 LPDDR5x PIM 样品,正在内部测试其运行和性能。”
DeepX 的模拟显示,将 GEMV 运算从 DX-M2 卸载到 LPDDR5x-PIM 中,与仅使用 DX-M2 相比,Llama3.1-8B 的每秒 token 数将提升 6.7 倍。
“搭载 LPDDR5x-PIM 的 DX-M2 已接近最优,”Kim 说。“但我们的下一代产品 DX-M3 将支持官方的 LPDDR6 PIM 技术;届时我们就能获得完整的理论性能提升,即 5 到 8 倍的性能提升。”
Kim 解释说,唯一的缺点是额外的算力并非没有代价——6.7 倍的性能需要整体 2.7 倍的功耗。尽管如此,DeepX 认为它可以在与非 PIM 运行相同的功耗范围内实现 2 倍的性能提升。
Kim 表示,编译器需要“大量的手动工作”来支持这种运行模式,并指出 DeepX 目前有一个基于启用 PIM 的 LPDDR5x 模拟的原型编译器在运行。“我们现在正在制作硬件模块,以便可以在物理环境中进行测试,所以编译器尚未完成,但我们正在积极开发中。”
 根据 DeepX 的说法,将 GEMV 运算卸载到内存中将以功耗为代价,将每秒 token 数提升 6.7 倍(基于 Llama3.1-8B)。(来源:DeepX)
关键市场
DX-M2 将瞄准多个关键领域。DeepX 正与台湾 OEM 厂商合作,为 AI PC(包括笔记本电脑和工作站)寻找合适的切入点。DeepX 战略营销总监 Tim Park 对《EE Times》表示,机器人公司目前基于 Nvidia Thor 等 GPU 进行原型开发,但希望获得更低功耗和更强的端侧算力;汽车公司则在寻找能够在车内运行智能体的低功耗芯片。在 IoT 设备方面,DeepX 已与三星合作开发下一代智能中枢。该公司还加入了 AWS IoT 生态,以便利用 Greengrass 支持远程模型更新。
Park 表示,机器人客户通常从 GPU 开始开发,但出于散热和功耗方面的考虑,不得不寻找替代方案。DeepX 正努力推动客户从 Nvidia Isaac 机器人平台迁移到其自研的等效平台 Newton。
“机器人客户会询问我们的硬件,也会问如何从 Nvidia 迁移到 DeepX,”他说。“这就是答案——客户将 API 改为调用 Newton 而非 Isaac,然后就能在 DeepX 系统上运行完全相同的流水线。”
Park 表示,DeepX 已有 17 个兼容库投入运行。该公司已演示了基于 M1 的机器人,其源代码与基于 Nvidia Jetson 的机器人相同,只是改为调用 DeepX 的库。
“对客户而言,实际结果是,从 Nvidia 切换到 DeepX 后,他们可以享受 20 倍的电池续航提升以及[更低的成本],”Kim 说。“同时,切换时间可以在一秒以内。他们只需将 API 名称从 Isaac 改为 Newton。就这样。”
面向 DeepX 硬件的完整机器人技术栈目前正在开发中。
DeepX 正在与美国、中国、越南和韩国的机器人客户接洽,而现代汽车集团机器人实验室已在其机器人平台中使用 DX-M1。
与此同时,该公司正在构建其生态系统,吸纳台湾 OEM 厂商、各市场的垂直领域领军企业,并且最近还与英特尔展开了合作。
DeepX 正与英特尔合作,将 OpenVINO 与 DeepX SDK 集成,以触达英特尔的 x86 客户群。DX-M1 可以补充英特尔 Core Ultra CPU 中集成的 NPU,并为其他没有 NPU 的英特尔边缘 CPU 提供 AI 能力,分担部分或全部 AI 工作负载。
Kim表示,公司近期与AMD会面,讨论联合开发一款基于DeepX加速器并结合AMD Kria参考板的机器人平台,尤其面向韩国生态系统。这是DeepX推动与其他异构生态系统合作的一部分,包括Raspberry Pi和百度的PaddlePaddle生态系统。
 DeepX以DX-Newton为名开发了面向机器人技术的软件库。(来源:DeepX)
商业进展
Kim表示,迄今为止,DX-M1已获得100多份采购订单,来自全球所有主要市场,覆盖所有物理AI行业(包括无人机、机器人、智能工厂、监控摄像头、航空航天与国防、医疗健康以及物联网)。M1目前已进入量产阶段。
Kim表示,物理AI最活跃的市场此前是中国,但日本今年已崛起为主要市场,展现出强烈的人形机器人开拓意愿。
“所有日本大型公司都在评估我们的芯片,目前日本有10多家领先企业,他们的反馈非常令人鼓舞,”他说。“与此同时,美国市场[也很强劲];我们在那里有几家知名企业,他们的反馈确实很好。”
DeepX还在韩国、越南和新加坡参与智慧城市项目。
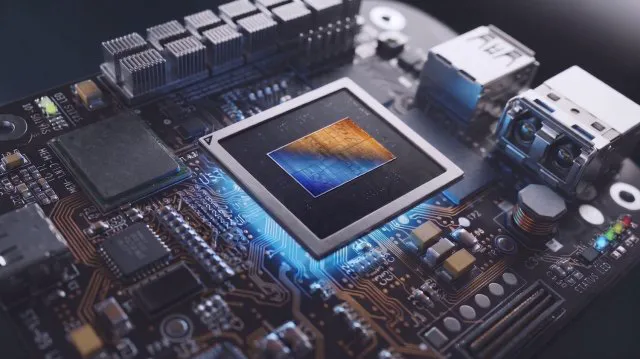
最终DX-M2芯片的艺术效果图,该芯片刚刚完成流片。(来源:DeepX)
“我们的长期观点是,随着效率提升,AI计算将变得更加分布式,”Park说。“PC和智能手机时代展示了计算如何扩展到众多产品中。AI将沿着自己的路径发展,但当应用需要即时访问传感器数据或在没有持续连接的情况下运行时,本地推理具有明确的价值。”
Park表示,DeepX认为边缘AI对其芯片而言是一个重大机遇,尤其是在可用于新建数据中心的电力有限之际。
Kim的看法是,正如当今CPU市场只有四分之一位于数据中心,AI处理器市场在未来五到十年也将向边缘转移。
在许多 AI 数据中心项目纷纷延期的当下,仅靠投资无法解决 AI 算力问题,他补充道。功耗仅 5 W 的 AI 芯片就能让 AI 迁移到设备端。
“如果我们在设备端部署高达 1000 亿参数的模型,就能将 AI 数据中心的流量减少 80% 以上,”Kim 表示。“这意味着我们可以在不增加任何 AI 服务器的情况下,拥有五倍规模的基础设施。这就是我们的愿景。”
 DeepX 的第三代产品将基于 chiplet。(来源:DeepX)
DeepX 第三代产品路线图上的是 DX-M3,将于 2028 年推出。M3 将基于 chiplet,并采用 LPDDR6-PIM,目标达到 1 ePOPS(INT8)。其主要目标市场是汽车 OEM 和人形机器人公司,这些市场的需求将要求多 chiplet 设计。
与此同时,M2 的样品预计于 2027 年 3 月推出,量产目标定于 2027 年秋季。
另请阅读:
Sally Ward-Foxton 为 EETimes.com 和 EETimes Europe 杂志报道 AI 领域。过去 18 年,Sally 一直在伦敦撰写有关电子行业的文章。她曾为 Electronic Design、ECN、Electronic Specifier: Design、Components in Electronics 以及许多其他新闻出版物撰稿。她拥有剑桥大学电气与电子工程硕士学位。 在 LinkedIn 上关注 Sally