美光发布至 2030 年路线图:垂直 HBM 与 AI 驱动芯片设计提速
美光披露了直至2030年的存储技术规划,重点包括2028年推出的“垂直HBM”架构以缩短数据路径并提升能效。同时,公司利用AI智能体辅助芯片逻辑编写与固件开发,使SSD控制器设计周期缩短50%,显著加速产品上市流程。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-24 10
美光(Micron)在其最新报告中详细阐述了计划于 2030 年前推向市场的存储与内存芯片。
以下是演示文稿中的一些关键披露:
单个 HBM4 内存堆栈的传输速率达 2.8 TB/s,因此大约 13 颗顶级 AI GPU(每颗配备 8 个堆栈)内部的总内存带宽,相当于全球国际互联网总容量约 282 TB/s。(参见幻灯片 12,“HBM4 与全球互联网带宽对比”。)
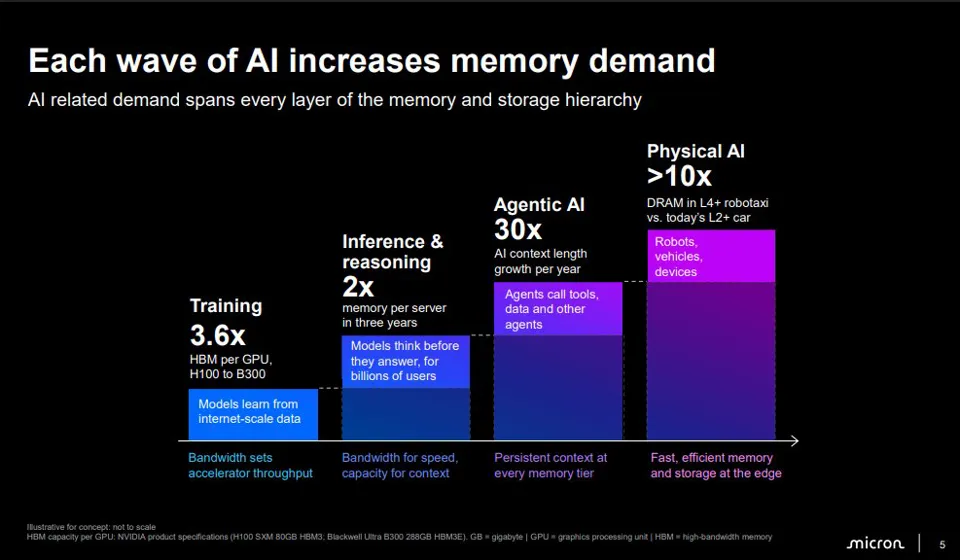
Nvidia GPU 的单卡内存容量从 H100 的 80GB 增长至 B300 的 288GB,增幅达 3.6 倍;美光估计 AI 上下文长度正以每年 30 倍的速度增长。Robotaxi(自动驾驶出租车)所需的内存量是当前辅助驾驶汽车的 10 倍以上。(参见幻灯片 5,“每一波 AI 浪潮都在推高内存需求”。)
美光计划在 2028 年推出“垂直 HBM”技术,将内存直接堆叠在 GPU 上方而非侧边,从而缩短数据路径并提高每瓦特的 AI 产出效率;美光称这些日期为目标节点。(简单图示参见幻灯片 20,2026 至 2030 年路线图参见幻灯片 22。)
基于两个内部项目,能够编写和验证芯片逻辑的 AI Agent 以及由 AI 编写的固件,使美光完成 SSD 控制器设计的时间缩短了 50%,并将 SSD 交付客户就绪状态的时间缩短了 60%。(参见幻灯片 27,“AI 让美光速度翻倍”。)
经过 20 多年研究一种名为 4F² 的高密度 DRAM 单元布局后,美光因成本过高且工艺复杂而放弃该技术,这与正在推进该技术的 SK 海力士和三星分道扬镳,转而通过 3D 结构向上构建 DRAM。(参见幻灯片 16,“DRAM 路线图”。)
美光正在设计一种闪存存储方案,允许 GPU 以小粒度块直接读取,并在加速器旁采用类似 HBM 的堆叠式闪存,用于存放模型权重及长对话 AI 的工作内存,目标每秒操作数(OPS)为 2500 万至 1 亿次。(参见幻灯片 24,“AI 级 NAND”。)
美光在一根宽度仅 50 µm 的人类头发丝上容纳了超过 1,500 个内存电容;历经 22 代制造工艺演进,如今每张 DRAM 晶圆所承载的比特数是 1995 年的 400 多倍。(参见幻灯片 9;幻灯片 11 中的保时捷类比可作为补充参考。)