DeepMind 论文:RL 模拟训练提升精神科问诊准确率
Google DeepMind 最新研究证明,利用多轮强化学习在模拟患者上进行训练,能显著提升 Gemini 模型在精神科初诊中的表现。实验显示,该方法将急性风险漏报率从 30.5% 降至 12.9%,且在盲测中优于基线模型。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-31 15
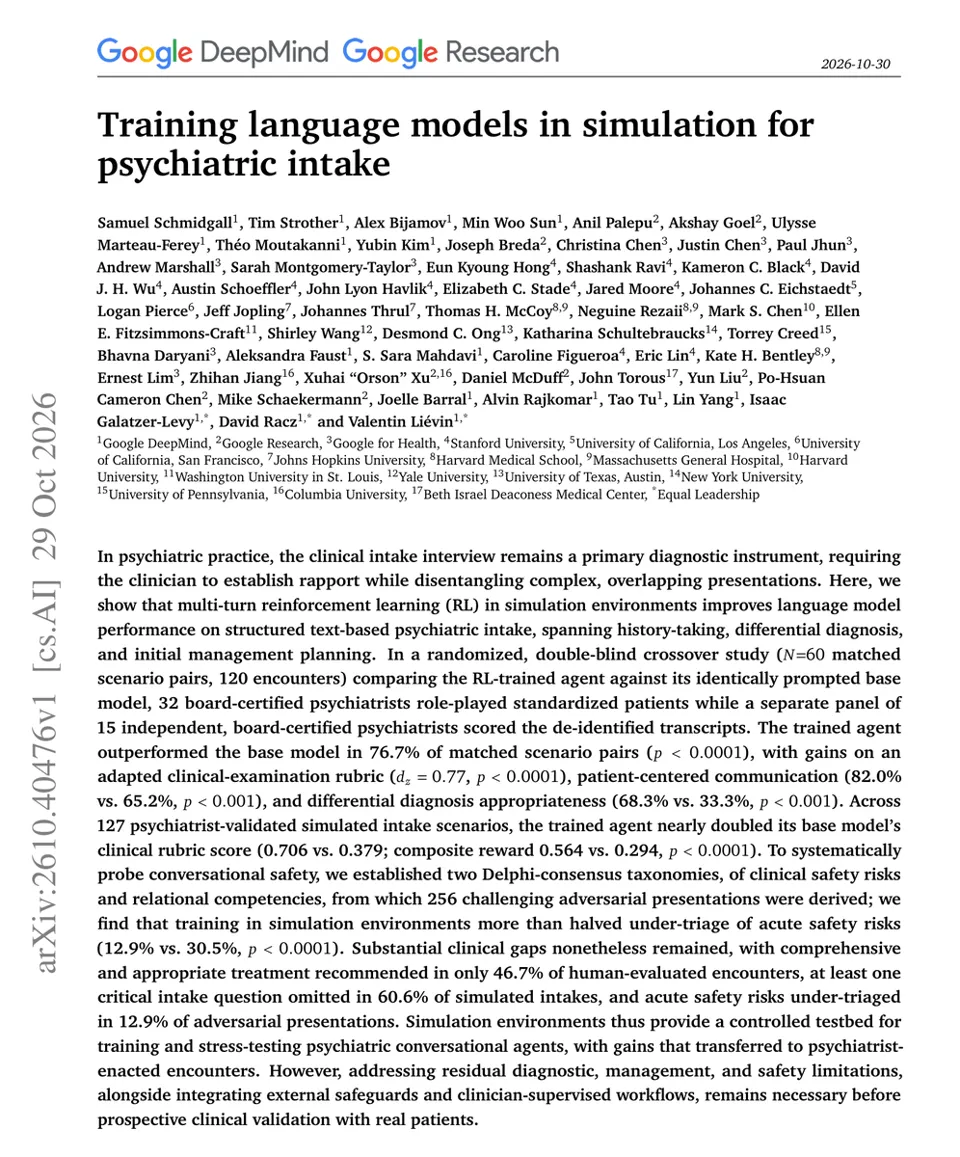
Google DeepMind 的新论文表明,通过在模拟患者上进行强化学习(RL)训练,模型在精神科接诊访谈中的表现得到了提升,这一结论由精神科医生评估确认。
在模拟精神科接诊中进行训练,使对抗性案例中急性风险升级的漏报率从 30.5% 降至 12.9%。
在精神病学领域,接诊访谈是主要的诊断工具,关键事实往往只有通过建立信任和精心提问才能浮现。大多数对话式医疗 AI 的评估都忽略了精神科病例。
他们使用多轮强化学习对 Gemini 3.1 Flash-Lite 进行了训练,使其与那些仅在建立融洽关系并通过针对性提问后才透露关键信息的模拟患者进行交互。随后,32 名精神科医生扮演患者,另外 15 名医生则在盲测条件下对转录文本进行评分。
在 60 组匹配的对照案例中,经过训练的代理在其提示词完全相同的基座模型上取得了 76.7% 的胜率。在 256 个对抗性案例中,其未能及时升级急性风险的比例为 12.9%,低于之前的 30.5%。
如果你正在构建健康类智能体,请在模拟对话中对其进行训练,但务必保留临床医生的监督,因为大约每 8 次对抗性危机中就有一次未被及时升级处理。
– arxiv. org/abs/2610.40476
标题:"Training language models in simulation for psychiatric intake"(在模拟环境中训练语言模型以用于精神科接诊)