Artificial Analysis (@ArtificialAnlys) · 2026/10/22 10:04:56
医疗基准对比:Anthropic 模型更完整,OpenAI 更精准简洁
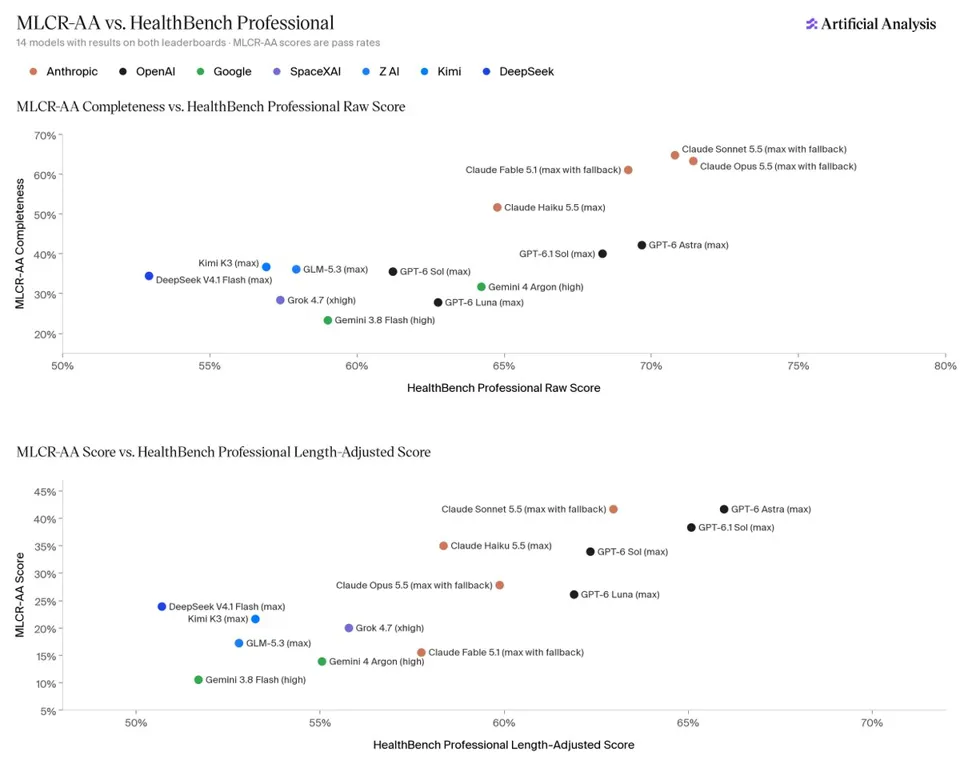
Artificial Analysis 对比了 MLCR-AA 和 HealthBench Professional 两个医疗基准。结果显示,Claude 系列在回答完整性上领先,而 GPT-6 Astra 在准确性与简洁性上表现更佳。若采用兼顾两者的综合评分,GPT-6 Astra 与 Claude Sonnet 5.5 并列第一。
报道全文原始报道全文
Artificial Analysis (@ArtificialAnlys) · 2026-10-22 02
在 MLCR-AA 和 HealthBench Professional 上,Anthropic 模型给出的答案最为全面,但 OpenAI 模型更准确且简洁
我们对比了 14 款模型,这些模型同时在 MLCR-AA(我们针对 @wisedocsai 的“医疗长上下文推理”基准测试设立的排行榜)和 @OpenAI 的 HealthBench Professional 上有测试结果。MLCR-AA 从完整性(涵盖专家答案中的每一个关键点)和准确性(没有与病历记录相矛盾的说法)两个维度对关于长篇医疗记录的回答进行评分,其最终得分要求两者兼备。HealthBench Professional 则依据医生编写的评分标准来评估给临床医生的回复:原始分数是获得的评分点占比,而经过长度调整的分数会对较长的回答进行惩罚。
主要结论:
➤ Anthropic 模型在完整性和原始分数上领先:来自 @AnthropicAI 的 Claude Sonnet 5.5、Opus 5.5 和 Fable 5.1(均为最大配置并启用回退机制)占据了 MLCR-AA 完整性得分的前三名,比表现最好的 OpenAI 模型高出约 19-23 分;此外,Opus 和 Sonnet 在 HealthBench Professional 上的原始得分最高(分别为 71.4% 和 70.8%),略微领先于 GPT-6 Astra(69.7%)。
➤ OpenAI 模型在准确性和简洁性上领先:OpenAI 模型保持着最高的 MLCR-AA 准确性得分。回答越长,被判定为准确的概率越低,因为每增加一个说法就多了一次可能与病历记录产生矛盾的机会:Anthropic 模型每个回答的平均字数约为 OpenAI 模型的 4-6 倍,但其准确性得分为 19-61%,而 OpenAI 模型为 89-97%。
➤ 在兼顾两者的得分指标上,差距缩小:GPT-6 Astra(最大配置)在 MLCR-AA 上与 Claude Sonnet 5.5 并列第一,并在 HealthBench Professional 的长度调整得分上以微弱优势领先;与此同时,Claude Opus 5.5 在原始得分上排名第一,但在长度调整得分上跌至第六名。