Artificial Analysis (@ArtificialAnlys) · 2026/10/20 07:03:30
Artificial Analysis 上线 HealthBench 医疗对话评测榜
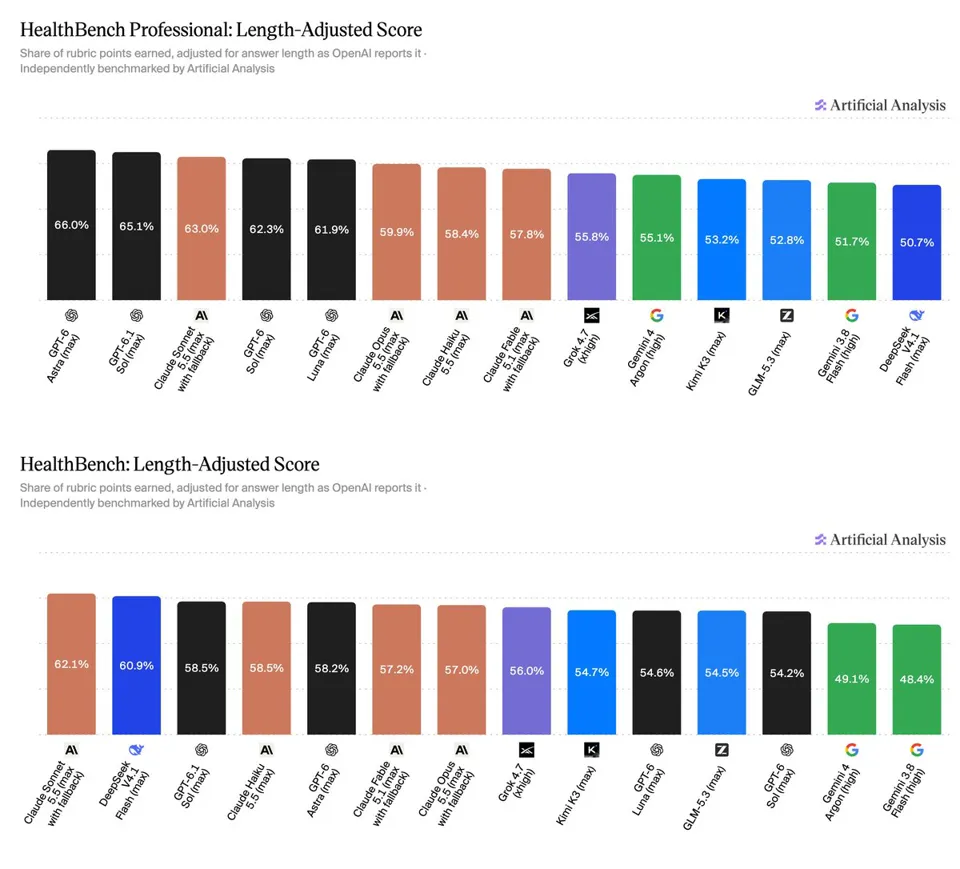
Artificial Analysis 正式推出针对 OpenAI HealthBench 和 HealthBench Professional 的公开排行榜。该基准通过医生制定的评分标准,评估 AI 模型在真实医疗对话中的表现,涵盖准确性、完整性及沟通质量等五个维度。初步数据显示,GPT-6 Sol 在沟通质量上领先但完整性较弱,而 Claude Sonnet 5.5 则在完整性方面表现最佳。
报道全文原始报道全文
Artificial Analysis (@ArtificialAnlys) · 2026-10-19 23
我们即将推出 HealthBench 和 HealthBench Professional 排行榜,这两个基准测试旨在评估 AI 模型在真实健康对话场景中的响应表现。
HealthBench 和 HealthBench Professional 是由 @OpenAI 推出的基准测试,它们依据医生制定的评分标准(rubrics),对模型在真实健康对话中的回复进行打分。
HealthBench 测试模型与日常用户及医护人员进行的 5,000 次健康对话。这些对话涵盖从紧急转诊到全球健康的七大主题,且每个评分标准均归属于五个维度之一:准确性、完整性、沟通质量、上下文感知能力和指令遵循能力。HealthBench Professional 是一个规模较小的数据集,包含 525 次对话,与 HealthBench 不同的是,其对话对象均为临床医生。这些对话涵盖咨询、写作和研究任务,并包含旨在挑战模型的对抗性及高难度对话。
我们同时报告原始得分(获得的评分标准分数占比)以及 OpenAI 报告的长度调整得分。长度调整得分会降低超过 2,000 字符的回复得分,并提高较短回复的得分。与 OpenAI 的原始实现一致,HealthBench Professional 的回复由 GPT-5.4 (low) 进行评分,而 HealthBench 的回复则由 GPT-4.1 进行评分。
HealthBench Professional 的关键结果:
➤ GPT-6 Astra 和 GPT-6.1 Sol 位居榜首:GPT-6 Astra (max) 的长度调整得分为 66.0%,与 GPT-6.1 Sol (max, 65.1%) 相当,并领先于 Claude Sonnet 5.5 (max with fallback, 63.0%)。
➤ OpenAI 模型构成了“得分 vs. 单任务成本”帕累托前沿的全部:帕累托前沿包括从 GPT-6 Luna (max, 61.9%, 0.036) 和 GPT-6.1 Sol (max, 65.1%, 0.27)。GPT-6 Luna (max) 的得分比 GPT-6 Astra (max) 低 4 分,但成本不到后者的 2%。
➤ Claude Opus 5.5 和 Claude Fable 5.1 受到最大的长度惩罚:两者的平均回答长度约为 5,900 字符,几乎是 2,000 字符阈值的 3 倍,调整后得分损失超过 11 分。Claude Opus 5.5 (max with fallback) 拥有最高的原始得分 (71.4%),但调整后降至第六名 (59.9%)。GPT-6 Sol (max) 是唯一一个平均长度低于 2,000 字符 (~1,600) 的模型,也是唯一一个得分因调整而上升的模型。
HealthBench 的关键结果:
➤ Claude Sonnet 5.5 在 HealthBench 上登顶:Claude Sonnet 5.5(最大配置并启用回退机制)在长度调整后的得分中达到 62.1%,领先于 DeepSeek V4.1 Flash(最大配置,60.9%)和 GPT-6.1 Sol(最大配置,58.5%)
➤ GPT-6 Luna、DeepSeek V4.1 Flash 和 Claude Sonnet 5.5 构成了“得分 vs. 单任务成本”的帕累托前沿:GPT-6 Luna(最大配置)以每任务 0.005 的成本获得 60.9% 的得分。Claude Sonnet 5.5(最大配置并启用回退机制)的平均单任务成本为 $0.08,比 DeepSeek V4.1 Flash 高出约 16 倍,但得分仅提升约 1 个百分点
➤ 更短的回答以完整性换取沟通质量:HealthBench 中的每一项评分标准都归属于五个维度之一。“完整性”检查回复是否包含所有重要信息,而“沟通质量”则评估其是否清晰、结构良好,且长度与细节层级适中。GPT-6 Sol(最大配置)生成的回答最短(约 1,000 字符),拥有最高的原始“沟通质量”得分(81%),但“完整性”得分最低(34%)。Claude Sonnet 5.5(最大配置并启用回退机制)在“完整性”方面领先(63%)