The Decoder · 2026/10/13 02:48:29
Meta 发布 Muse Wonder 前沿模型:智能指数跃升至 56 分,代理任务性能大幅突破
Meta 正式推出新一代前沿大模型 Muse Wonder 及其增强版 Full,在 Artificial Analysis 智能指数上分别斩获 52 和 56 分,显著超越前代并跻身全球第一梯队。该模型在 Terminal-Bench 等代理能力基准测试中表现强劲,得分从 33% 跃升至 57%,同时引入“主动记忆”机制并优化了输出 Token 效率。
报道全文原始报道全文
本文目录2 个章节
Meta 发布了其前沿模型 Muse Wonder 的两个版本,两者均跻身当前最佳 AI 模型之列。
Muse Wonder Full 在 Artificial Analysis Intelligence Index v4.3 上得分为 56 分,而 Muse Wonder 得分为 52 分。其前代产品 Muse Spark 1.3 的得分为 48 分,这意味着从原本的中端模型实现了显著跃升。
最大的提升体现在 agentic(智能体)评估中,这类测试衡量的是 AI 模型独立处理复杂任务的能力。在 Terminal-Bench 4.0 上,性能从 33% 跃升至 57%。Muse Wonder Full 在十项基准测试中有六项位列前三,对于 Meta 而言这是一个强劲的结果,此前其开源 Llama 模型经历了一段表现较弱的时期,如今似乎已重回正轨。
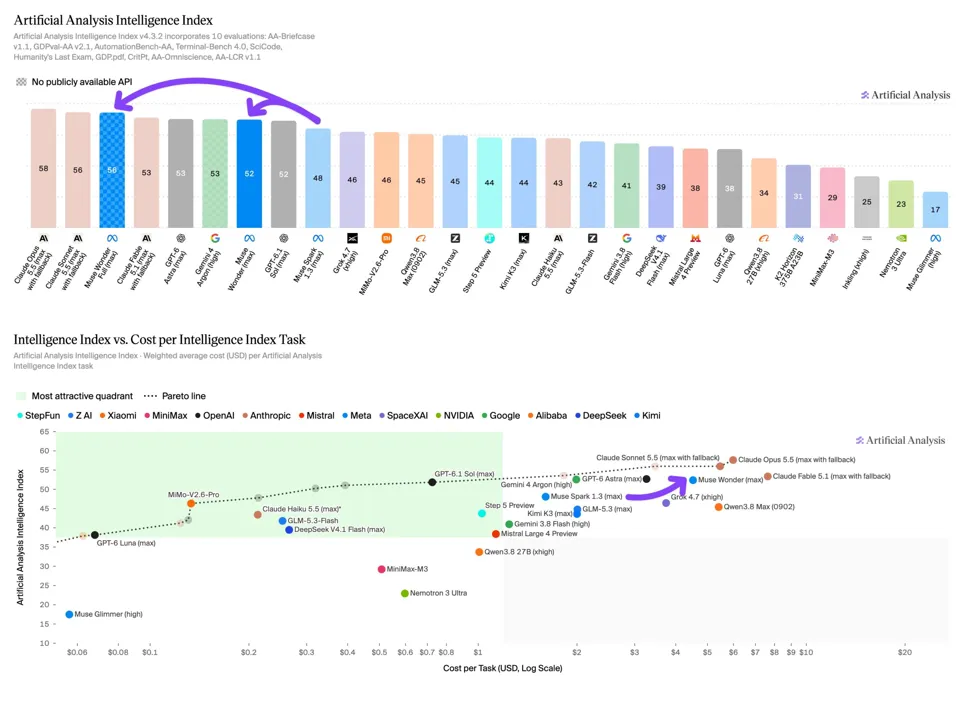
Muse Wonder Full 在 Artificial Analysis Intelligence Index 上得分为 56,跻身顶级前沿模型行列。| 图片来源:Artificial Analysis
Meta 重点介绍了两项新功能。“Active Memory”(主动记忆)使模型能够跨对话记住关键信息并在需要时调用。“Active Focus”(主动聚焦)则是模型坚持处理困难任务、尝试替代方案以及在遇到不明确之处时提出后续问题的能力。这两项功能都是 Meta 打造个人 AI 智能体主张的核心,该智能体旨在访问日历、消息和文档。
两款模型均支持一百万 token 的上下文窗口,并接受文本、图像、视频和音频作为输入。Muse Wonder 可通过 Meta API 和 Muse Code 获取,而 Muse Wonder Full 目前仅限 Muse Code 用户使用。Muse Wonder 也将很快为 Muse app 提供支持,首先面向付费订阅用户开放。随着时间推移,Meta 计划基于它构建面向所有用户的专用模型。
编码能力大幅提升,但事实性知识仍显滞后
两款模型在编码方面均显示出巨大改进。Muse Wonder Full 在 Coding Agents Index 上得分为 68,与搭载 Sonnet 5.5 的 Claude Code 持平。Muse Wonder 得分为 63,较前代的 54 分有所提升。
事实性知识仍是一个薄弱环节。在 AA-Omniscience 知识测试中,Muse Wonder Full 仅得 30 分,而 Muse Wonder 得 25 分。这远远落后于 Claude Opus 5.5(46 分)、GPT-6 Astra(43 分)和 Gemini 4 Argon(42 分),这表明 Wonder 系列基于比竞争对手更小的基础模型构建。较低的幻觉率有助于弥补这一差距。与上一代产品相比,Muse Wonder Full 将幻觉率从 33% 降至 23%,在所有指数得分至少为 45 分的模型中排名第二低。只有 Gemini 4 Argon(15%) 的幻觉频率更低。
Meta 在其博客文章中回应了一个常见的批评,即 Muse 模型针对基准测试进行了调优,但在实际应用中表现不佳。该公司表示,Muse Wonder Full 在未参与训练优化的陌生任务上表现优于预期,并将此归功于更强的基础模型。
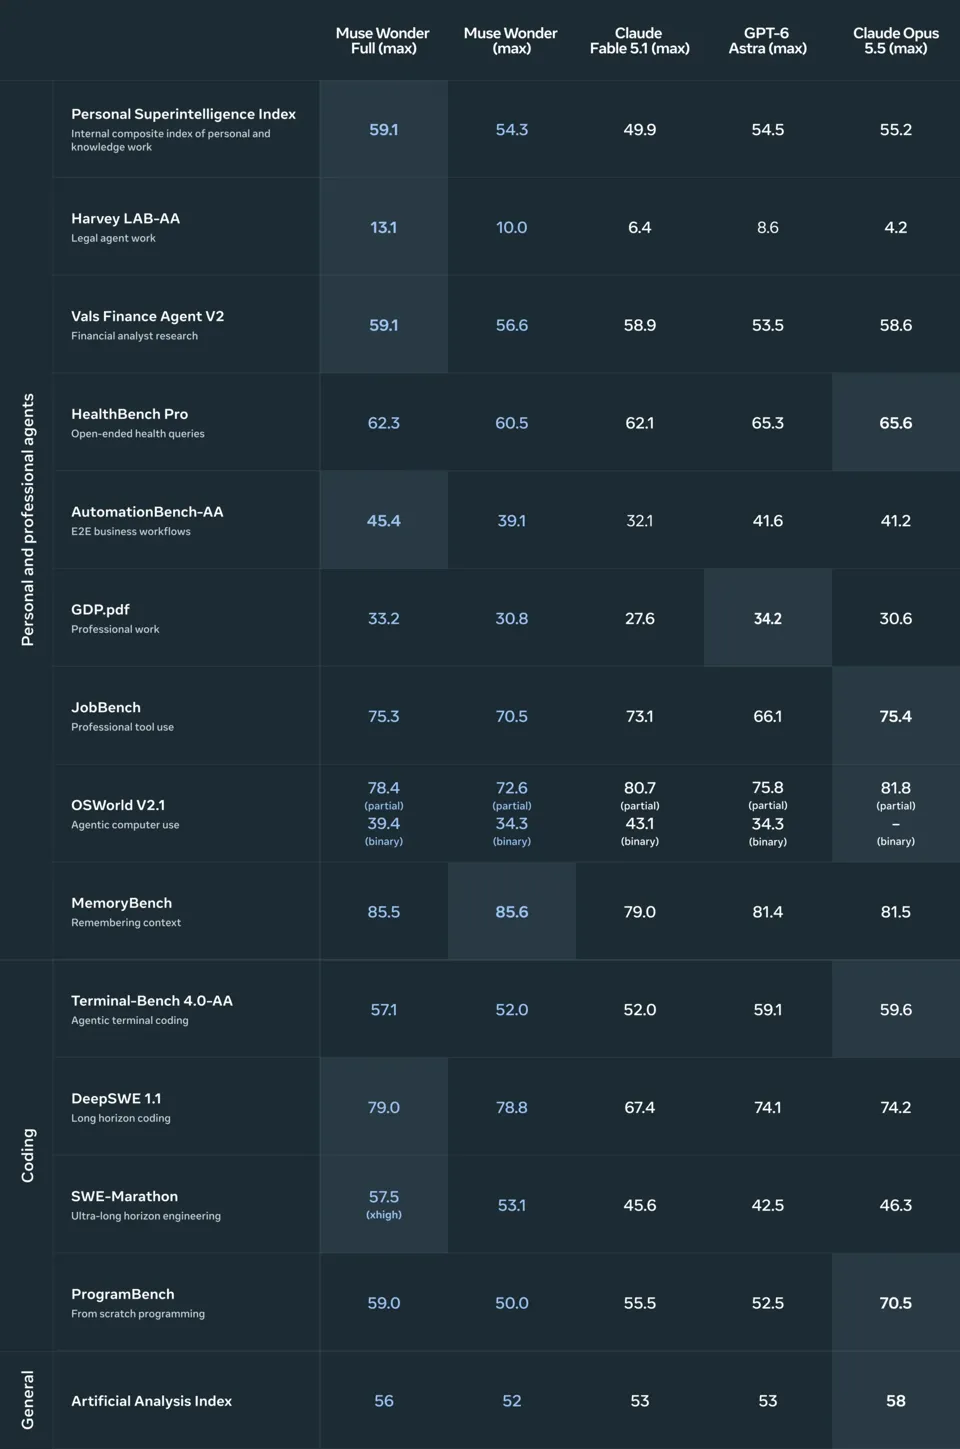
Meta 的官方基准测试结果显示,这家在线广告公司已追平领先的尖端模型。| 图片:Meta
根据 Vals AI 的数据,在 Vals AI Index 上,Muse Wonder Full (Max) 首次亮相便位列第五,并超越了所有 OpenAI 模型。目前仅有 Anthropic 的模型得分更高。Muse Wonder 则排名第十。
最大的改进来自编程和数学领域。在用于数学证明的私有基准测试 ProofBench 上,Muse Wonder Full 解决了 100 个问题中的 94 个,较其前代产品的 58 个有显著提升。这使其仅落后于顶尖模型(99 至 100 分)五到六分。在 Terminal-Bench 4 上,Muse Wonder Full 的得分翻倍,同时输出 token 数量减少了 30%。金融和法律任务的表现保持在前代水平,但分数下降了最多两分。
性能提升伴随着高昂成本
根据 Artificial Analysis 的数据,Muse Wonder 在 Intelligence Index 上的每任务运行成本为 4.52 美元,几乎是 Muse Spark 1.3(1.60 美元)的三倍。Token 定价也有所上涨,输入 token 每百万收费 4 美元,输出 token 每百万收费 20 美元,而前代产品分别为 1.25 美元和 4.25 美元。此外,Muse Wonder 每个任务的输入 token 使用量增加了 28%,这些输入 token 占总成本的 76%。
这使得 Muse Wonder 的定价低于 Claude Fable 5.1(7.63 美元)和 Claude Opus 5.5(5.98 美元),但高于 GPT-6 Astra(3.26 美元)、Gemini 4 Argon(1.99 美元)以及 GPT-6.1 Sol(0.72 美元)。Muse Wonder Full 目前尚未公布 token 定价。两款模型的输出 token 数量均比前代产品减少约 10%。
Meta 表示,这些模型是在其内部的 Prometheus 数据中心以吉瓦级规模进行训练的。更多细节请参阅模型卡。