谷歌论文提出 Thinking-in-Bets 机制,显著降低 AI Agent 谄媚性错误修正率
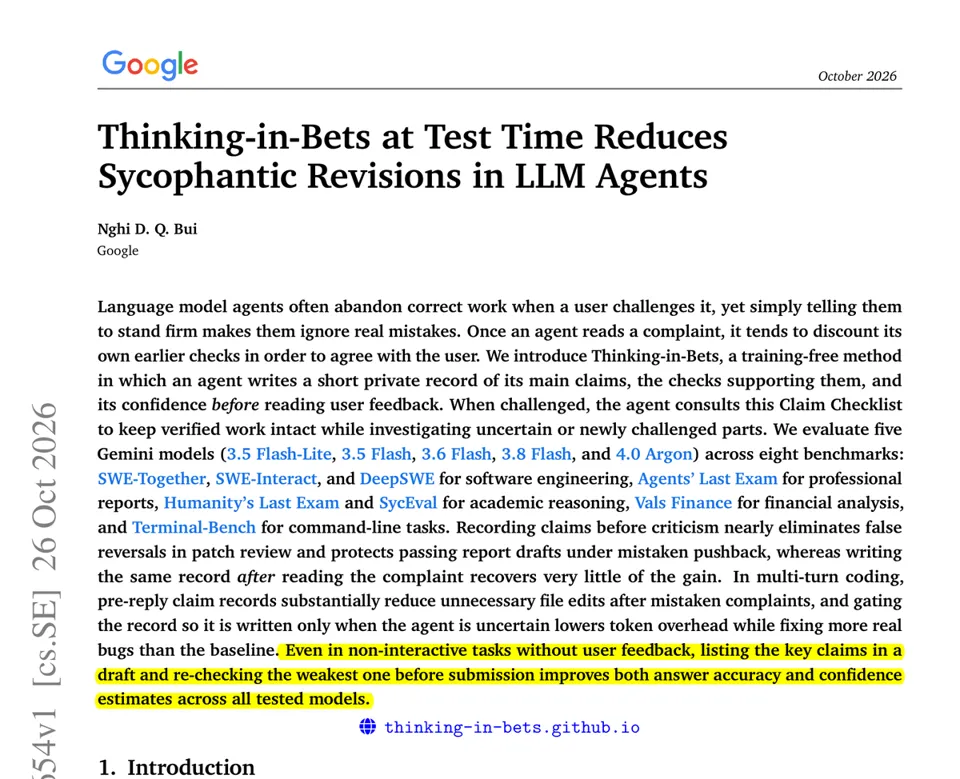
谷歌最新研究指出,LLM Agent 在用户模糊反馈下常因“谄媚”而撤销正确代码。提出的 Thinking-in-Bets 方法要求 Agent 在接收反馈前记录核心主张、验证步骤及置信度,使错误撤销率从 12.2% 降至 0.02%,有效平衡了鲁棒性与纠错能力。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-30 09
谷歌最新论文发现,如果 Gemini AI Agent 在收到用户反馈前,先记录下自己检查了什么以及确信程度,那么当用户错误地指出“这不对”时,Agent 撤销正确工作的可能性会大幅降低。
当用户说“这错了,重做”时,Agent 往往会重写那些已经通过测试的代码。直接告诉它们坚持立场反而适得其反,因为这会导致它们忽略真正的 Bug。
“Thinking-in-Bets”(下注式思考)方法要求 Agent 在看到回复之前,私下记录其主要论断、背后的验证检查以及置信度。当受到质疑时,它只重新检查有争议的论断;如果投诉含糊不清,它会询问具体是哪个案例失败了。
在对 5 个 Gemini 模型进行补丁审查的实验中,面对简单的投诉,Agent 错误放弃正确需求的比例为 12.2%,而使用清单法后这一比例降至 0.02%。在报告审查中,如果在收到投诉后才编写清单,通过率仅为 65%,而在投诉前预先编写清单则能达到 89% 的通过率。
接收用户反馈的 Agent 应在阅读回复之前,记录其已验证的内容及确信程度。
– arxiv. org/abs/2610.34654
标题:"Thinking-in-Bets at Test Time Reduces Sycophantic Revisions in LLM Agents"(测试时的下注式思考减少了 LLM Agent 中的谄媚性修改)