OpenAI 发布 LifeVal 基准 GPT-6 日常任务得分达 80.6%
原标题:OpenAI has released LifeVal, a benchmark testing whether AI models can finish everyday errands for p...
78AI 研判分
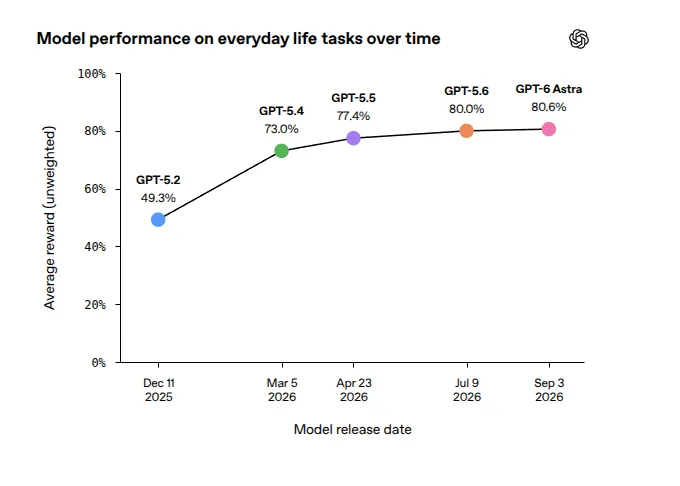
OpenAI 推出名为 LifeVal 的新基准,旨在评估 AI 模型处理日常生活琐事(如育儿、财务、购物)的能力。该基准基于数千名 ChatGPT 用户反馈构建,测试结果显示 GPT-6 Astra 在任务完成度上达到 80.6%,较九个月前的 GPT-5.2 (49.3%) 有显著提升。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-02 18
OpenAI 发布了 LifeVal,这是一个测试 AI 模型能否帮人们完成日常琐事的基准。
GPT-6 Astra 在日常任务上的得分为 80.6%,相比不到 9 个月前 GPT-5.2 的 49.3% 有了显著提升。
LifeVal 的任务涵盖照护、健康、教育、金融、购物和家庭管理等领域,从预约车辆年检到在预算内订购清真食品杂货等。
↳ 引用 @OpenAI (OpenAI): 为了让 AGI 惠及全人类,它应该帮助人们处理对他们最重要的日常事务。因此,我们构建了 LifeVal,这是一个新的基准,其设计基于数千名 ChatGPT 用户的反馈,反映了他们最希望个人助理提供协助的领域——从寻找托儿服务到获取政府服务,再到管理个人财务。
在过去一年中,我们利用 LifeVal 来衡量并改进我们的模型在处理这些日常任务方面的表现。