Hugging Face Blog · 2026/10/20 08:00:00
Hugging Face 集成 TorchTPU 原生支持 PyTorch 运行 TPU
Hugging Face 宣布通过 TorchTPU 实现 PyTorch 对 Google TPU 的原生支持,无需再依赖 torch_xla 或 JAX。开发者可直接在 Transformers、Diffusers 等库中将模型发送至 'tpu' 设备运行,显著降低了使用 TPU 进行 AI 开发的门槛。
报道全文原始报道全文
本文目录10 个章节
Hugging Face ❤️ TorchTPU:原生支持 TPU
Alvaro Moran tengomucho Jingya Huang Jingya Simon Pagezy pagezyhf Jeff Boudier jeffboudier Régis Pierrard regisss
如果你曾尝试在 TPU 上运行 PyTorch,你可能不得不将代码移植到 torch_xla,或者最终被迫学习 JAX。借助 TorchTPU——一个原生的 PyTorch 后端,TPU 现在只是另一种设备。这为 Hugging Face 生态系统中的 TPU 原生支持打开了大门。Transformers、Diffusers 和 Kernels 均可在 TPU 上原生运行。从 Hub 中选择一个模型,将其发送到 "tpu",即可大功告成。
等等,什么是 TPU?🤔
TPU 代表 Tensor Processing Unit(张量处理单元)。TPU 是 Google 自研的 AI 加速器。这些芯片专为一项任务而构建:神经网络大部分时间都在进行的矩阵运算。Google 已经设计了大约十年,并使用它们来训练和服务其自有模型,包括 Gemini。
TPU 可在 Google Cloud 上使用,从单芯片到包含数千个芯片的 Pod 集群均有提供。当你需要大量算力进行训练或大规模服务时,TPU 表现出色。
一直以来的痛点在于软件。TPU 技术栈主要围绕 TensorFlow 和 JAX 发展而来,PyTorch 用户必须付出更多努力才能接入。
旧的方式
直到现在,在 TPU 上运行 PyTorch 仍需通过 PyTorch/XLA (torch_xla)。虽然可行,但它存在一些怪异之处。张量是惰性执行的(指张量本身,而不是你),因此你的代码并不总是在你认为它运行的时候运行。微小的更改可能会触发图重新编译,而且调试起来很难理清头绪。
为了让生活更轻松,我们构建了 Optimum TPU。它为 Hugging Face 模型提供了在 TPU 上的推理和训练支持。既然 TorchTPU 带来了原生支持,使用 Transformers 和 Diffusers 运行 Hugging Face 模型时不再需要 Optimum TPU。
TorchTPU 登场 🚀
TorchTPU 为 PyTorch 添加了 TPU 作为新的后端。你只需编写常规的 PyTorch 代码即可。它内置了针对 TPU 调优的 Pallas kernels,支持分布式训练,并在需要更高速度时提供 torch.compile 集成。在 TPU VM 上安装它只需一条命令:
额外的索引会为你提供 torch 的 CPU 版本。如果没有它,pip 会拉取体积大得多的 CUDA 版本,而在 TPU 上并不需要该版本。
你喜爱的库,现已支持 TPU
Transformers
Transformers v5 围绕一个核心理念构建:成为模型定义的权威来源(source of truth),从而使其可以在任何地方运行。“任何地方”现在也包括了 TPU。要在 TPU 上加载模型,只需传入 device_map="tpu"。就这么简单。
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3.5-9B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="tpu",
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
inputs = tokenizer("The future of AI is", return_tensors="pt").to("tpu")
out = model.generate(**inputs, max_new_tokens=64)
print(tokenizer.decode(out[0], skip_special_tokens=True))
模型默认以 eager mode(即时执行模式)运行。你也可以使用 torch.compile 以获得更好的性能,或在分布式环境中运行。
图像?视频?Diffusers 在 TPU 上生成它们 🎨
TPU 现在是 Diffusers 中的一等公民设备(first-class device)。对于原型开发或调试,eager mode 只需要 pipe.to("tpu")。对于部署,compiled mode 只需增加一个 compile 调用。你的 pipelines 和代码保持不变,且无需维护单独的 TPU 分支。
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3.5-medium", dtype=torch.bfloat16
)
pipe.to("tpu")

pipe.transformer.compile(backend="tpu", fullgraph=True, dynamic=False)

image = pipe("a corgi astronaut planting a flag on a pizza moon").images[0]
首次调用时会进行编译,之后每次使用相同图像尺寸的调用都会复用计算图。
模型太大,单芯片放不下?向 from_pretrained 传入 TensorParallelConfig,transformer 会在加载过程中跨芯片分片,因此整个模型无需完全容纳在单一位置。许多流行的 pipelines 开箱即用地支持此功能,而不支持的也仅需配置 tp_plan 即可实现。完整的操作指南请参阅 Diffusers TPU guide。
以下是一些在 Cloud TPU v6e-4 上运行的示例:
TP=4(每个模型拆分到四颗芯片上)· bf16 · batch 1
| MiniMax-H3(视频 + 音频) | Qwen-Image-2.1 |
|---|---|
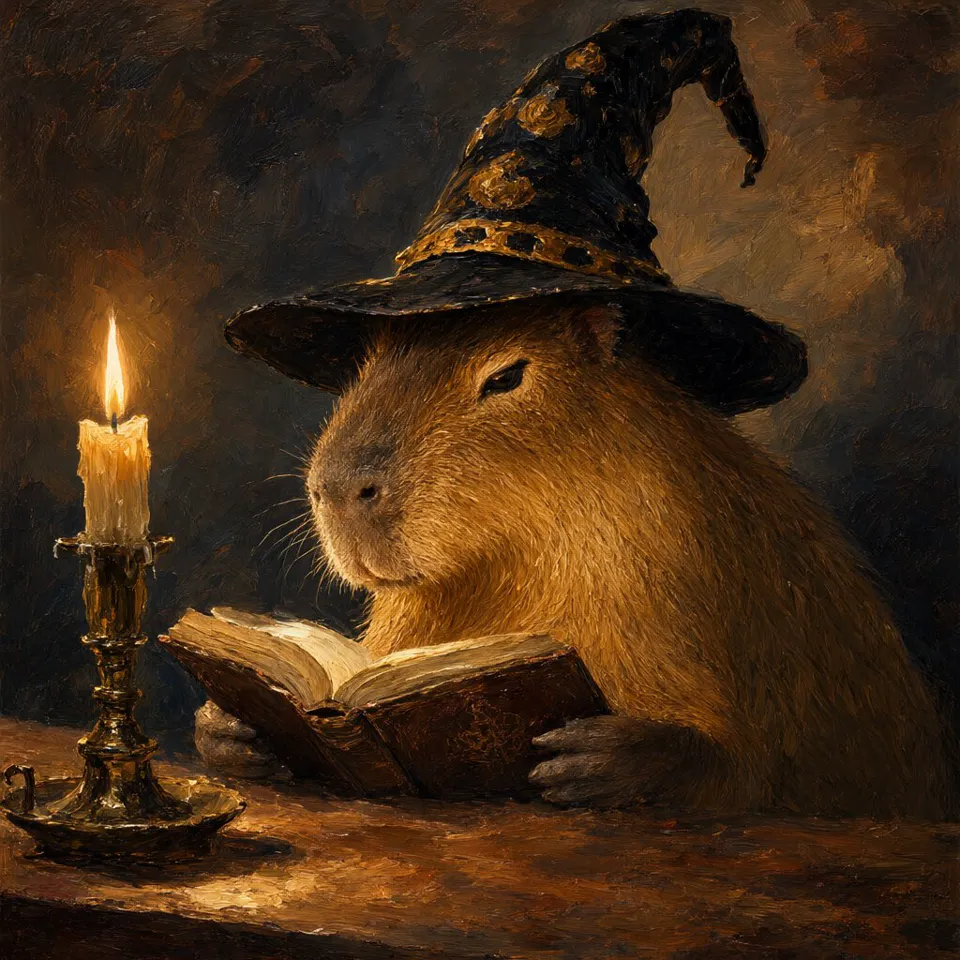 | |
| "图片中那只毛茸茸的 Hugging Face 吉祥物,一个圆圆的黄色笑脸,脸颊泛红,两只小手张开,站在一艘古希腊三列桨战船的船头 […] 海浪拍击声、木材吱呀声、索具中的风声、远处海鸥的叫声,以及低沉宏大的管弦乐渐强。" · 1344×768, 5.2 s, 49 steps · 编译耗时 188 s,eager 模式耗时 262 s | "一只戴着巫师帽的水豚,在烛光下读书,油画风格" · 1024×1024, 40 steps · 编译耗时 3.5 s,eager 模式耗时 8.0 s |
Kernels
Kernels Hub 提供了开箱即用的 TPU kernels。通过 Kernels 库加载其中一个,即可为你的模型提速。
TPU kernels 使用 Pallas 编写,它让你对硬件拥有底层控制能力。你也可以引入来自 Tokamax 库的 kernels。下面是一个将 Tokamax 中的 ragged-dot kernel 接入 Mixture-of-Experts 模型的示例:
from kernels import get_kernel
from transformers import AutoModelForCausalLM
from transformers.integrations.moe import ALL_EXPERTS_FUNCTIONS

repo_id = "tengomucho/ragged-dot-tpu"
kernel = get_kernel(repo_id, version=1, trust_remote_code=[repo_id])
ALL_EXPERTS_FUNCTIONS.register("tokamax_ragged_dot", kernel.experts_forward)
model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen3-30B-A3B-Instruct-2507",
    experts_implementation="tokamax_ragged_dot",
)
batch size 越大,收益越显著。在 batch size 为 64 时,Qwen3-30B-A3B 的解码速度提升了 21.5 倍,Gemma 4 26B-A4B 的解码速度提升了 12.8 倍。
 在 TPU v6e-8 上的解码吞吐量:Hub kernel 与默认实现对比。
我们替你测试好了 🧪
我们正通过运行库的测试套件,持续改进 transformers 对 TPU 的支持。我们正在努力添加针对 TPU 的夜间 CI(持续集成),并将结果展示在 transformers dashboard 上。
 Transformers CI 仪表盘,TPU 测试结果与其他加速器并列显示。仍在进行中!
目前并非所有测试都通过,但这没关系。在 TPU 上运行的测试中,96.5% 已通过。我们发现每一个失败案例都会转化为一个小型复现脚本,并在 TorchTPU 仓库中提交 issue。截至目前,我们已报告了 34 个 issue,其中 19 个已修复。在 TPU 上的运行还发现了 Transformers 本身的一些 bug,例如 StaticCache 和 Qwen3 张量并行方案中的问题。我们已在上游修复了这些问题。
如果 TPU 上出现任何问题,我们希望在你发现之前就能知晓。
开始使用
对于 PyTorch 用户来说,TPU 不再是一个边缘任务。安装 TorchTPU,从 Hub 获取模型,并将其发送到 "tpu" 设备即可。
我们迫不及待想看到你们构建的成果 🤗。如果你遇到问题,请提交 issue 并告诉我们。