Prime Intellect 发布 Mega MoE 训练内核,提速 55%
作者:▲ Marktechpost AI (@Marktechpost)原标题:▲ Prime Intellect just released Prime Mega MoE, which makes DeepSeek's fused Mega MoE kernel usable ...
78AI 研判分
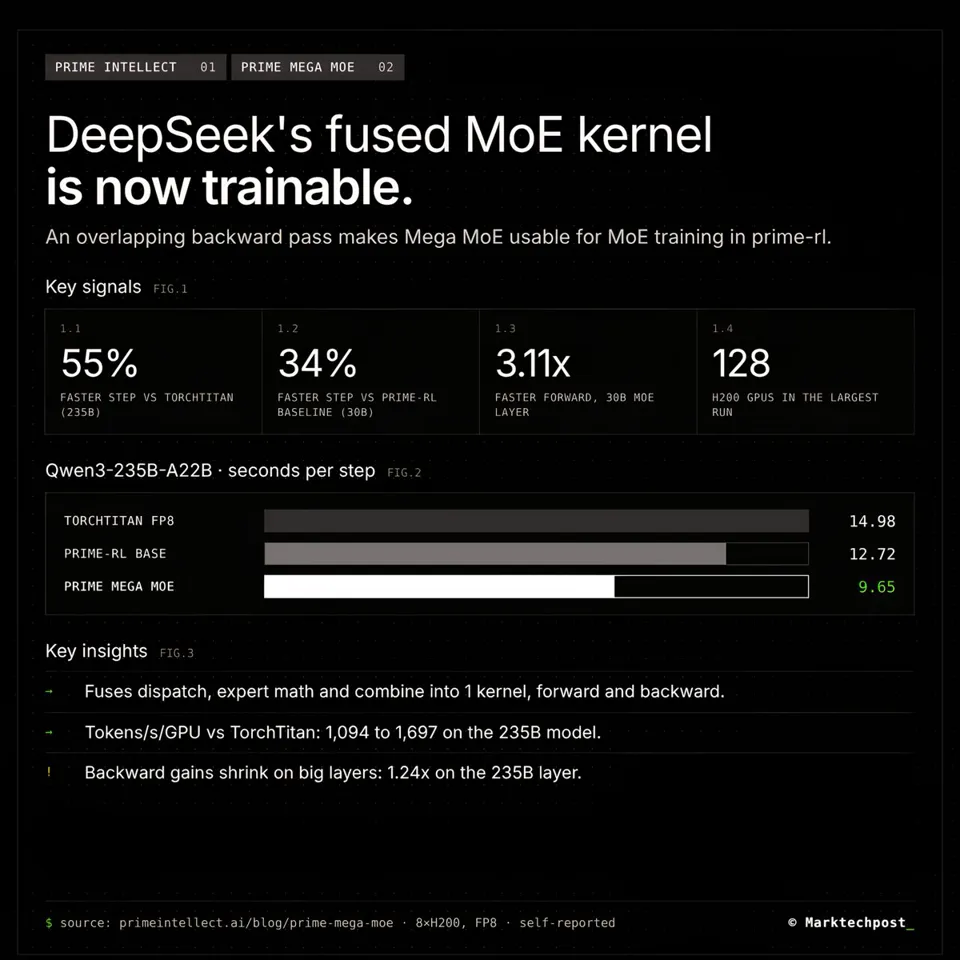
Prime Intellect 推出 Prime Mega MoE,将 DeepSeek 的融合内核扩展至支持高效反向传播训练。在 Qwen3-235B 模型上,该方案使单步训练时间从 14.98 秒降至 9.65 秒,整体提速约 55%,显著优化了混合专家模型的通信与计算重叠效率。
报道正文
▲ Marktechpost AI · 2026-10-29 18
▲ Prime Intellect 刚刚发布了 Prime Mega MoE,这使得 DeepSeek 的融合 Mega MoE 内核不仅可用于推理,还可用于训练。
核心思想是重叠(overlap)。MoE 层通常将路由、发送、计算和返回作为独立步骤执行,导致 GPU 在等待通信时处于空闲状态。DeepSeek 的 Mega MoE 将这些步骤融合为 1 个内核,但此前仅支持前向传播。Prime Intellect 添加了一个快速且具备重叠特性的反向传播内核。
在 Qwen3-235B-A22B(使用 128 张 H200)上,一个训练步骤的时间从 TorchTitan 的 14.98 秒降至 9.65 秒,速度提升 55%。与其自身的 prime-rl 基线相比,步骤速度提升了 32% 到 34%。不过这也存在权衡:前向传播速度最高提升至 3.11 倍,但在 235B 模型层中,反向传播的速度仅提升 1.24 倍。
该功能今日已在 prime-rl(Apache 2.0 许可证)中发布,作为 mega_moe 调度后端,支持 BF16、Hopper 架构上的分块 FP8 以及 Blackwell 架构上的 MXFP8……
完整分析: