Rohan Paul (@rohanpaul_ai) · 2026/10/23 13:54:01
Meta 提出 RSD 方法 AI 智能体可从无标注历史任务中自我学习
出处作者 / 发布主体:Rohan Paul (@rohanpaul_ai)原标题:New Meta paper finds that AI agents can learn from their own past attempts at tasks, even ones nobod...
78AI 研判分
核心综述
Meta 最新研究提出“回顾性评分蒸馏”(RSD)技术,使 AI 智能体无需人工标注或奖励信号,仅通过重读自身过往执行轨迹即可提取有效经验。实验显示该方法在 ScienceWorld 和 ALFWorld 基准上显著提升了 Qwen3 系列模型的任务成功率,其中 ALFWorld 表现超越所有依赖真实标签的基线方法。核心建议是保留所有未标记运行记录并每轮动态重建回顾机制以避免性能停滞。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-23 05
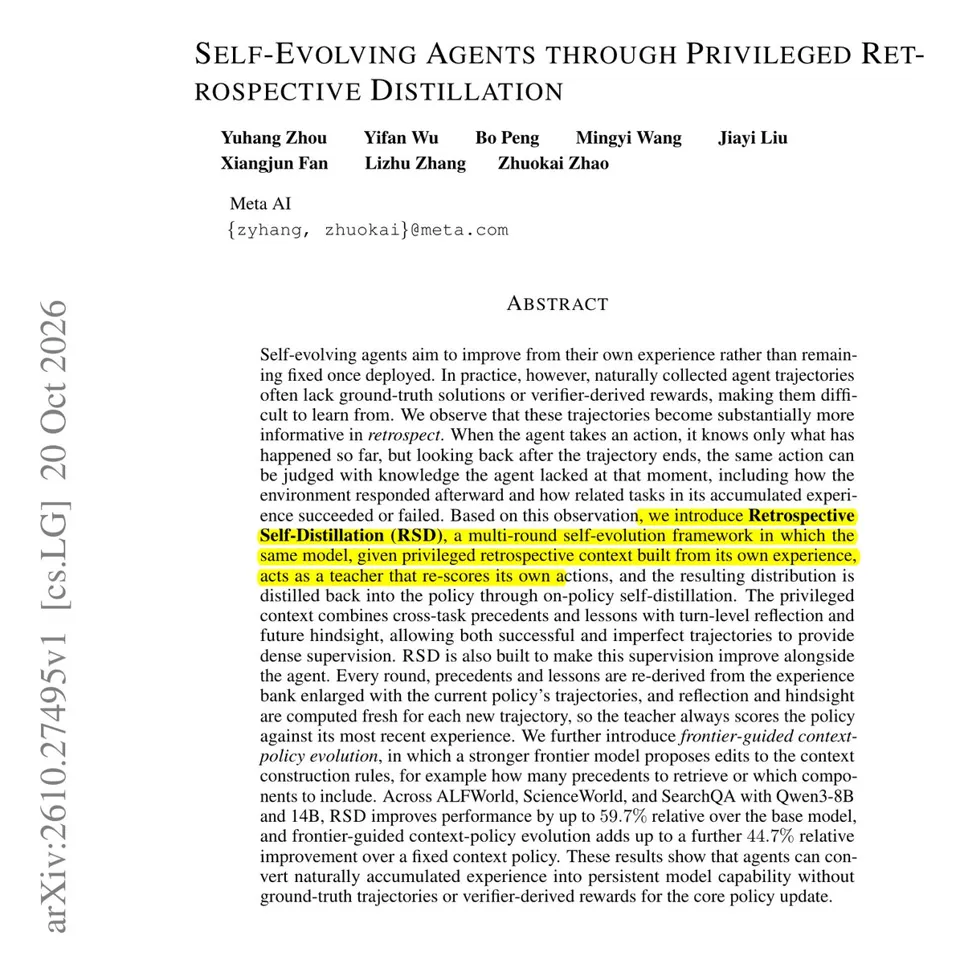
Meta 最新论文发现,AI Agent 能够从自身过往的任务尝试中学习,即使这些尝试没有任何标注(无论对错)。其核心机制在于:当 Agent 知晓任务最终结果后,回顾每一步操作。
大多数 Agent 运行轨迹既没有正确答案,也没有奖励信号,而这正是标准训练方法所依赖的。RSD 方法让同一模型重新阅读已完成的运行轨迹,结合最终结果以及在类似任务上的成功经验,对每个动作进行评分,Agent 则基于这些评分进行学习。
在 ScienceWorld 基准测试中,Qwen3-14B 的成功率从 12.9% 提升至 20.6%。在 ALFWorld 基准测试中,Qwen3-8B 达到了 76.6%,超越了所有其他测试方法,包括那些拥有奖励或真实标签的方法。
建议保留 Agent 的无标签运行轨迹(包括失败案例),并基于对这些轨迹的“事后回顾”进行训练。每一轮都应重建这种回顾机制,因为固定的笔记会导致 ALFWorld 成功率在第 3 轮时降至 59.7%,而使用动态更新的回顾则能达到 67.9%。