英伟达论文揭示无关文本通过干扰注意力头削弱模型
原标题:New Nvidia + other labs paper shows that irrelevant text hurts mainly by weakening the model's use o...
78AI 研判分
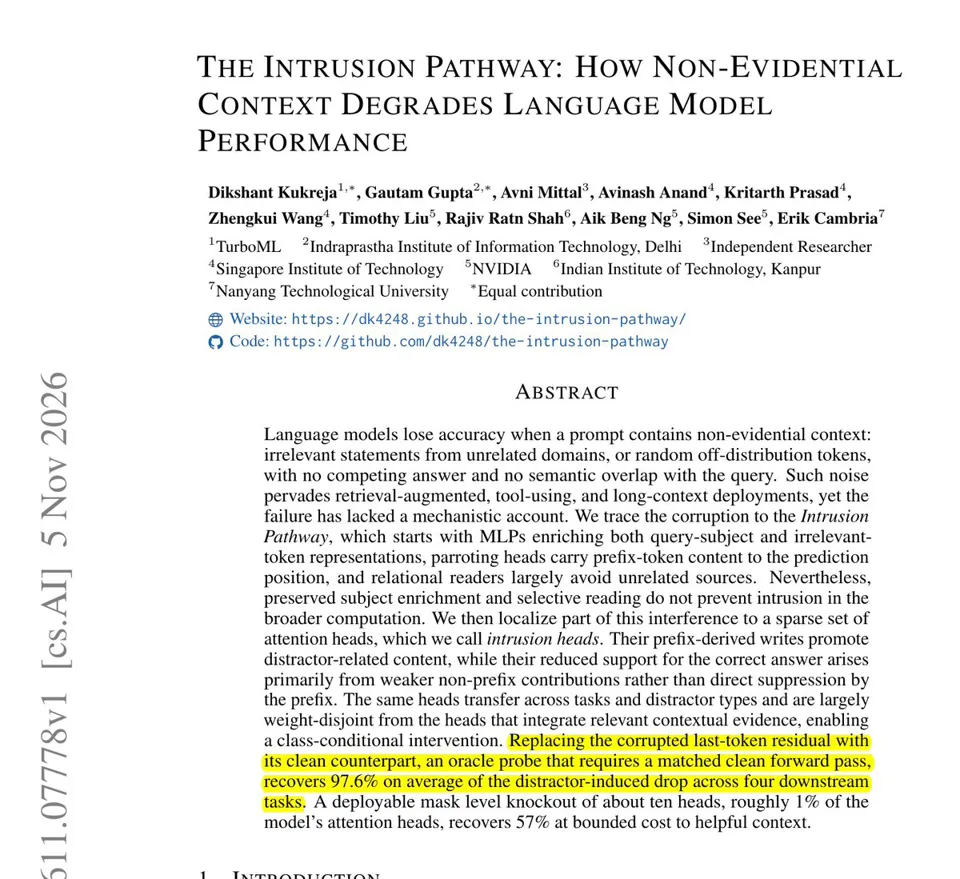
英伟达联合其他实验室的论文指出,RAG、工具调用与长上下文场景中的无关文本主要通过削弱模型对问题的利用来损害性能,而非直接压制正确答案。研究在开源模型内部定位到一小组“入侵注意力头”,它们读取无关文本并削弱答案;在 7B 规模模型上屏蔽约 10 个头即可平均挽回 57% 的干扰损失准确率,接近需要干净对照运行的 97.6% 上限。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-10 04
英伟达及其他实验室的新论文表明,无关文本对模型的损害主要在于削弱了模型对问题的利用,而非直接对抗正确答案。
在 RAG、工具调用和长上下文应用中,提示词常常包含与问题无关的文本。哪怕只是“计算机很有用”这样一句话,也会降低模型对正确答案的支持度。
他们在开源模型内部追踪了这一现象,发现了“侵入头”(intrusion heads)——一小组注意力头,它们会读取无关文本并削弱答案。将这些头对上下文的注意力屏蔽掉后,负责利用有用证据的注意力头则不受影响。
在 7B 规模模型的 4 项任务中,屏蔽约 10 个注意力头平均挽回了因干扰项而损失的 57% 准确率。而需要匹配干净运行结果的 oracle 修复方案则挽回了 97.6%。
如果你用带有噪声检索上下文来服务开放权重模型,对少数模型特定的注意力头做免训练屏蔽,就能挽回大部分损失的准确率。