Kimi K3.1 Pro 发布 智能指数第四 将成最强开源模型
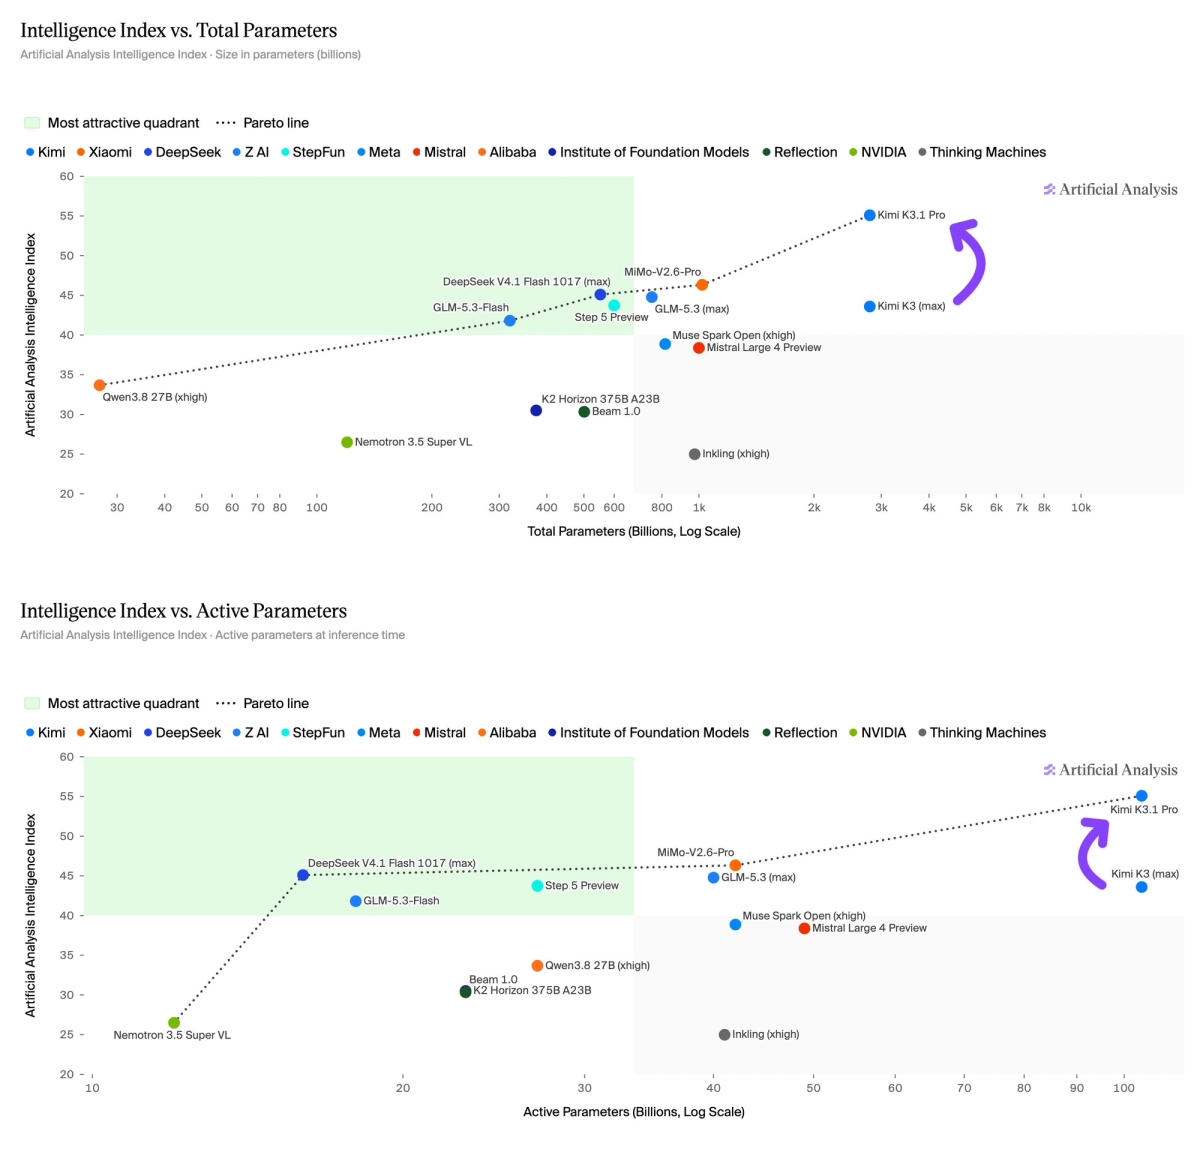
Moonshot AI 发布新推理模型 Kimi K3.1 Pro,在 Artificial Analysis 智能指数中得分为 55,位列全球第四。该模型在智能体任务性能上显著提升,一旦权重公开,将成为得分最高的开源权重模型,大幅缩小与顶级闭源模型的差距。
报道正文
本文目录5 个章节
2026 年 10 月 23 日
Kimi K3.1 Pro 发布,在 Artificial Analysis 智能指数中得分 55,位列第四;其在 agentic(智能体)性能方面取得大幅提升;一旦权重发布,它将成为领先的开源权重模型
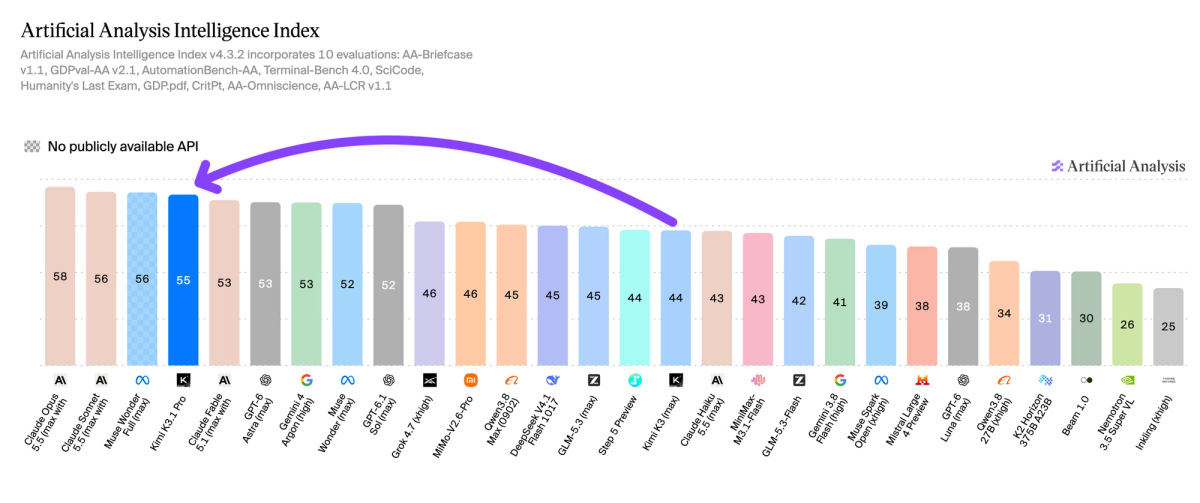
Moonshot 的新推理模型相比 Kimi K3(max,44 分)提升了 11 分。在智能指数上,它仅落后于 Claude Opus 5.5(带 fallback 的 max,58 分)、Claude Sonnet 5.5(带 fallback 的 max,56 分)和 Muse Wonder Full(max,56 分)。
一旦 K3.1 Pro 的权重发布,它将成为得分最高的开源权重模型,智能指数上领先的开源权重模型与专有模型之间的差距将从 12 分缩小至 3 分。
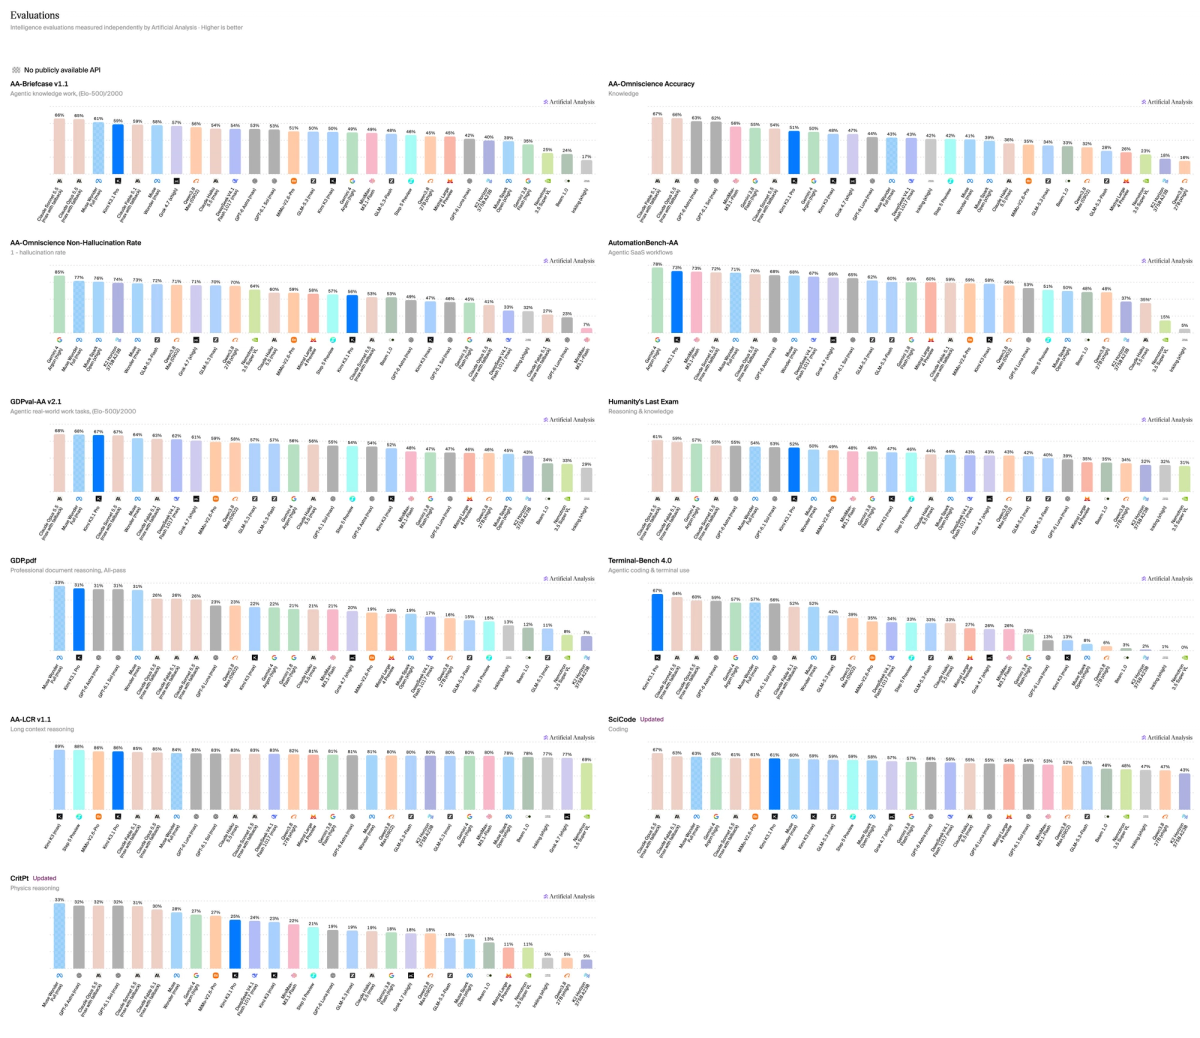
关键结果:➤ Agentic 性能大幅提升:Kimi K3.1 Pro 在 GDPval-AA 中以 1,846 Elo 分排名第三,较 Kimi K3 提升 312 Elo 分,仅次于 Claude Opus 5.5(1,866 Elo 分)和 Muse Wonder Full(1,857 Elo 分)。Kimi K3.1 Pro 还在 Terminal-Bench 4.0 中取得了所有模型中的最高分。K3.1 Pro 得分为 67%,高于 Kimi K3 的 13%,并领先于 Claude Sonnet 5.5(64%)。测试 agentic SaaS 工作流的 AutomationBench-AA 得分从 58% 上升至 73%。
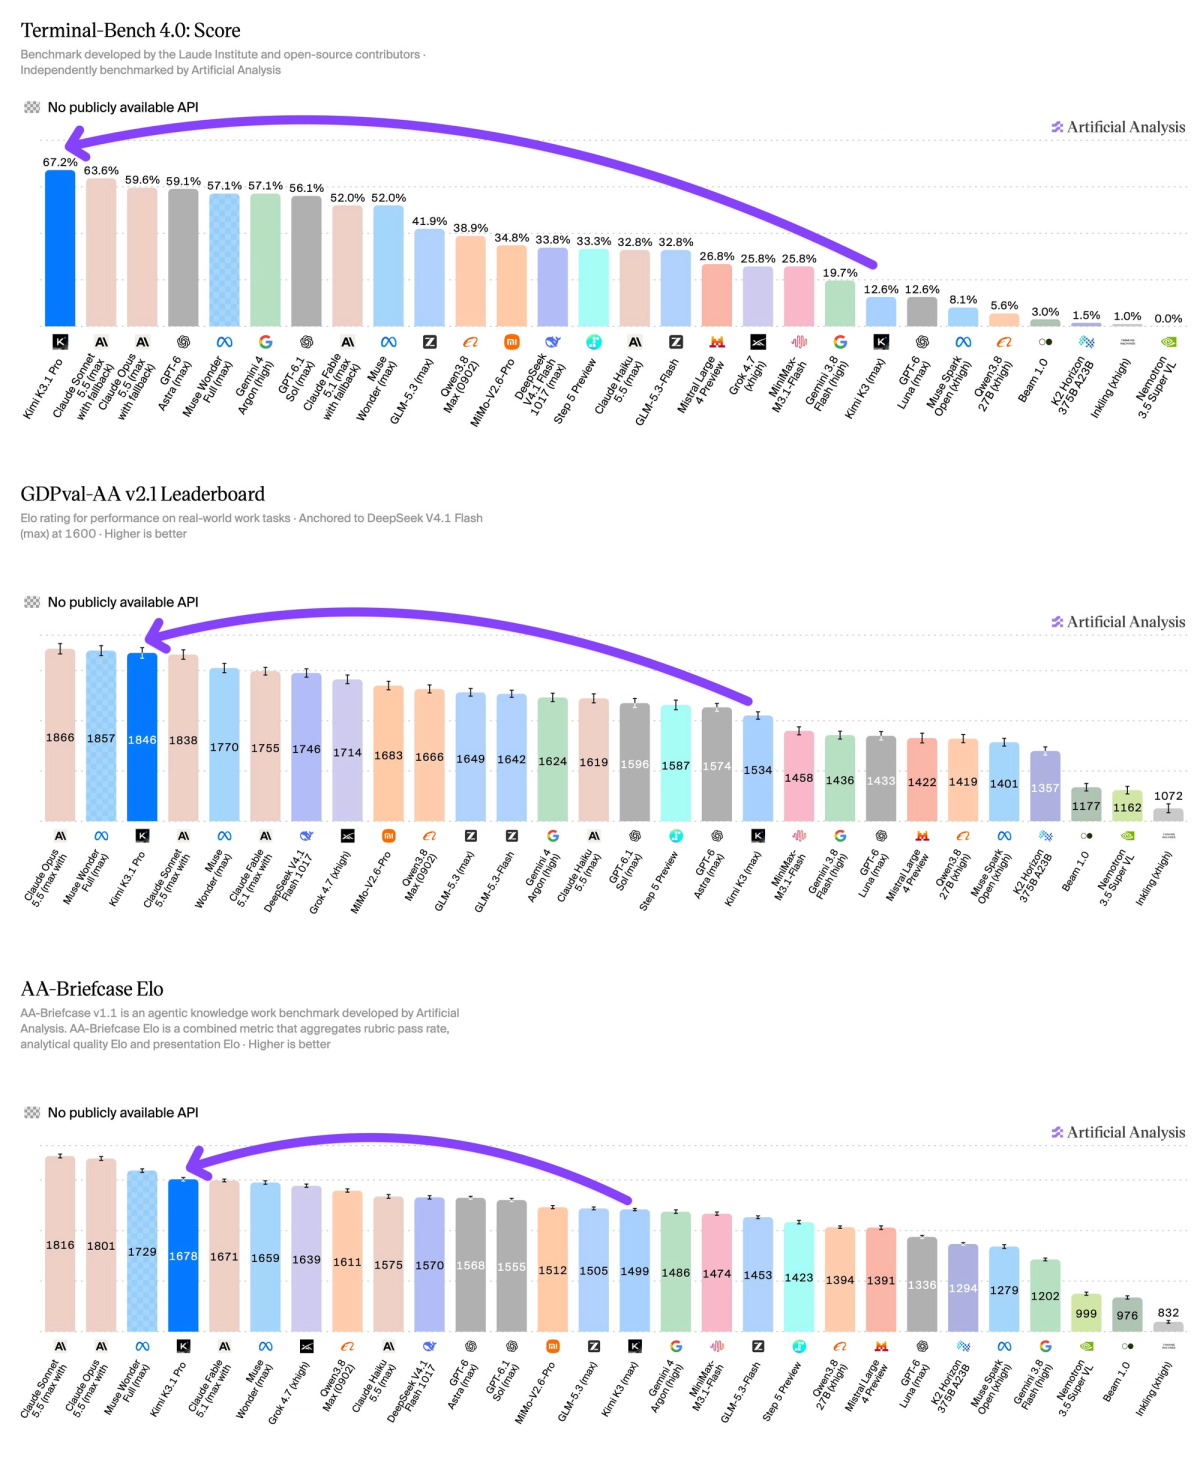
➤ 其他评估指标的提升较为温和:Humanity's Last Exam 从 47% 上升至 52%,CritPt 从 23% 上升至 25%,SciCode 从 59% 上升至 61%。AA-Omniscience Index 从 20 上升至 30,因为幻觉率从 53% 下降至 44%,准确率从 48% 上升至 51%。
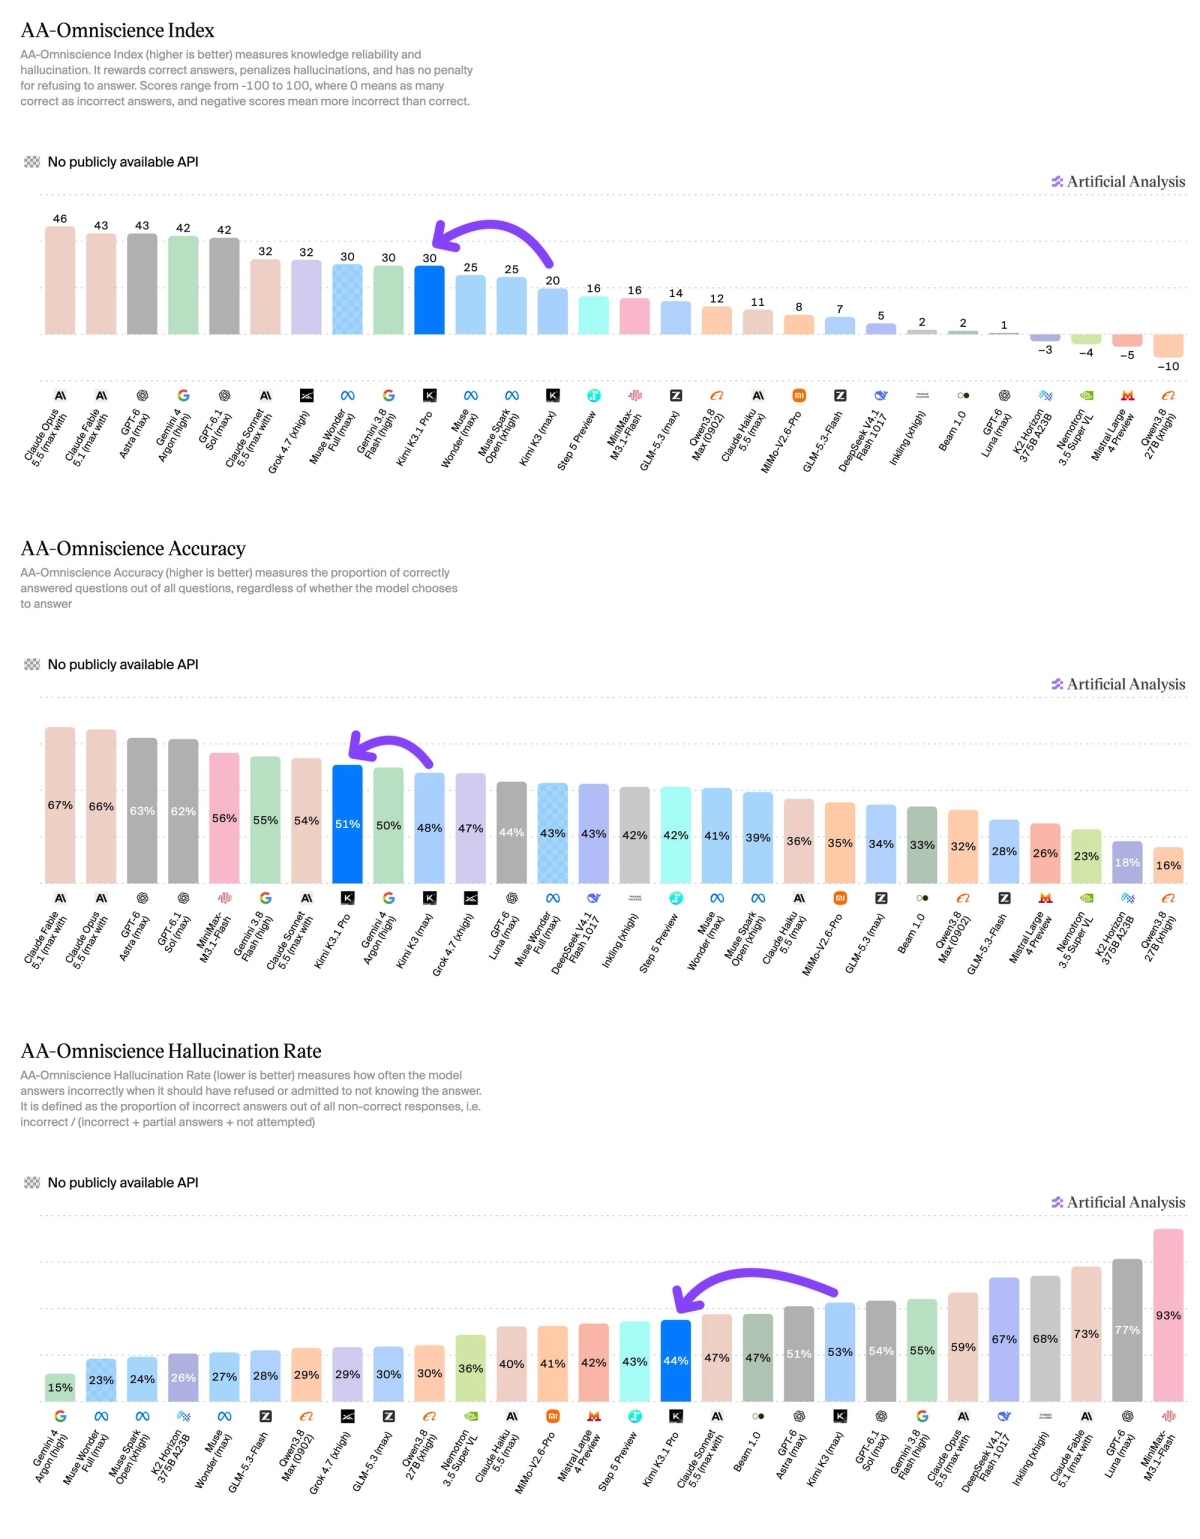
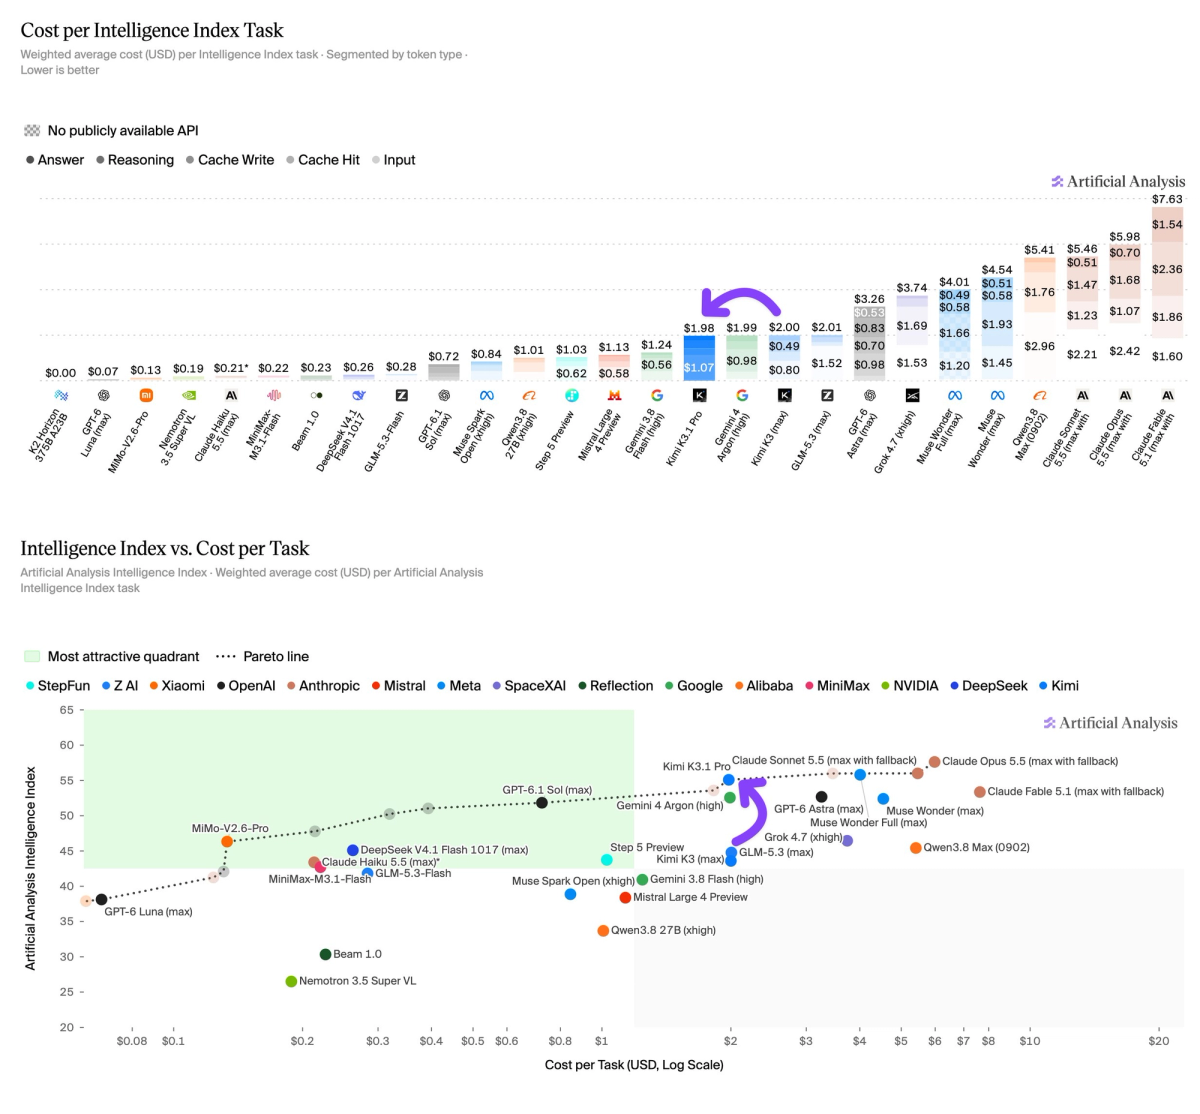
➤ 每任务成本(Cost per Task)约为 $1.98,与 Kimi K3 大致相当:K3.1 Pro 在每个智能指数任务中使用 55K 输出 token,比 Kimi K3 的 48K 多 14%,而其第一方 token 价格低 33%。
其他模型详情:➤ 上下文窗口:100 万 token。➤ 规模:总参数 2.8T,激活参数 104B ➤ 输入模态:文本和图像 ➤ 权重与许可证:权重目前尚未发布,Moonshot 预计在发布后不久开放权重 ➤ 定价:每百万输入/输出/缓存命中 token 分别为 10/$0.20,三项费率均比 Kimi K3 低 33%。
单项评测结果:
阅读最新内容
[
发布 AA-PersonalityBench:衡量 AI 模型的沟通方式
AA-PersonalityBench 用于评估 AI 模型的人格特质和沟通风格。由 LLM 评委组成的小组在 30 项人格特质上对回答进行成对比较,这些特质汇总为 8 个人格指数,同时直接从每个响应中测量 21 项沟通特征。
October 19, 2026](https://artificialanalysis.ai/articles/aa-personalitybench)[

HealthBench 和 HealthBench Professional:在真实健康对话场景中评估模型
我们推出了 HealthBench 和 HealthBench Professional 排行榜,这两个基准测试旨在评估 AI 模型在真实健康对话场景中的响应表现
October 19, 2026](https://artificialanalysis.ai/articles/healthbench-professional-health-conversations)[

Reflection 发布了其首个模型 Beam
Reflection 的首个模型 Beam 在 Artificial Analysis Intelligence Index 中获得 30 分,在美国开源权重模型中排名第 2
October 16, 2026](https://artificialanalysis.ai/articles/reflection-beam)