Artificial Analysis (@ArtificialAnlys) · 2026/10/21 13:10:12
Devin Fusion 双模型架构基准测试得分超 Claude Code
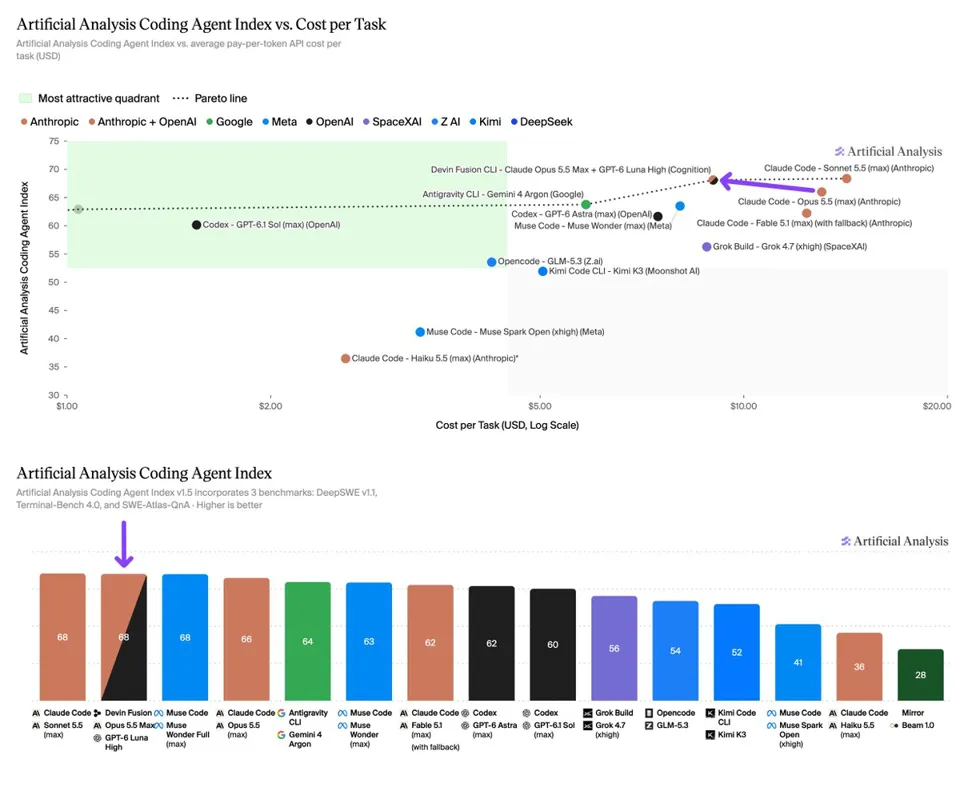
Cognition 推出的 Devin Fusion 采用“前沿主模型+低成本副模型”并行协作架构,在 Artificial Analysis Coding Agent Index 中得分为 68.1。该配置以 Claude Opus 5.5 为主、GPT-6 Luna 为副,相比单用 Opus 5.5 的 Claude Code,成本降低约 31% 且任务耗时更短,但在部分终端基准上略逊一筹。
报道全文原始报道全文
Artificial Analysis (@ArtificialAnlys) · 2026-10-21 05
Devin Fusion 搭配 Claude Opus 5.5 (max) 和 GPT-6 Luna (high) 副手模型,在 Coding Agent Index 上得分为 68,比 Claude Code 搭配 Opus 5.5 (max) 高出 2 分,且每任务成本低 31%
@cognition 的 Devin Fusion 运行一个前沿主力模型,并配合一个低成本副手模型。两者并行工作,各自拥有独立的上下文和工具,其中主力模型负责规划、任务委派和最终审查。我们对 Devin Fusion CLI 进行了基准测试,配置为 Claude Opus 5.5 (max) + GPT-6 Luna (high)。
它在 Artificial Analysis Coding Agent Index 上得分为 68.1,与排名第一的 Claude Code(搭配 Claude Sonnet 5.5 max,得分 68.4)以及 Muse Code(搭配 Muse Wonder Full max,得分 68.0)表现相当接近。相比之下,Claude Code(搭配 Claude Opus 5.5 max)得分为 66.0,而 Devin Fusion 每任务成本为 13.04,平均耗时为 55 分钟 vs. 65 分钟。
在三个基准测试中,Fusion 配置在 DeepSWE v1.1(72.6% vs. 68.4%)和 SWE-Atlas-QnA(69.6% vs. 66.4%)上得分更高,而在 Terminal-Bench 4.0 上略低(62.1% vs. 63.1%)。其结果反映了两个模型的协同工作效果,包括它们的综合 API 成本。此处成本指按 token 计费的 API 成本,而非订阅价格。