OpenWiki 结合图谱构建智能体记忆,准确率提升 5 倍
LangChain 团队推出 OpenWiki,通过编译式维基与证据图谱增强智能体记忆。实验显示,在多源复杂推理任务中,该方案比纯检索工具准确率高出 5 倍,且引入图谱后进一步提升了引用一致性并降低了成本。
报道正文
本文目录11 个章节
Open Source
使用 OpenWiki 和图构建基于证据的智能体记忆
核心要点
- 编译后的 Wiki 为智能体提供了领域上下文,而仅靠检索则需要重新构建这些上下文。 在涉及多个来源的问题上,将 OpenWiki 作为记忆层的智能体比仅使用 grep 工具的智能体准确率高出 5 倍。
- 添加证据图有助于智能体从 Wiki 追溯至支持性证据。 我们将引用和文档参考转换为智能体可以追踪的显式图边。与仅使用 Wiki 相比,这使得智能体引用相同证据的一致性提高了一倍,准确率提升了 27%,并将每个正确答案的成本降低了 58%。
- 为重复性的跨源推理保存编译后的记忆。 Wiki 捕获了领域知识和复杂关系。添加证据图可以提高准确率和检索一致性。然而,对于简单的查找任务,没有记忆层的智能体同样准确且速度更快。
需要在组织的政策、手册、Wiki、工单和代码中工作的智能体,必须应对分散在不同系统和团队中的知识。找到相关段落只是开始。它们还需要确定哪些规则适用、发生了什么变化,以及一个来源如何影响另一个来源。
持久化的记忆层能够保留知识和关系,供智能体在不同任务间复用。如果没有它,智能体往往必须在每次提问时重新构建这种理解,导致其工作成本高昂且容易出错。这在银行和保险业尤其具有挑战性,因为政策和指南经常相互修订或取代。
我们测试了 OpenWiki(我们的开源 Wiki 编译器)作为这一记忆层。在需要跨源建立关联的问题上,Wiki 使智能体的准确率比仅使用搜索高出约 5 倍。添加一个将 Wiki 陈述与支持性段落连接起来并链接相关来源的证据图,进一步将准确率提高了 27%,并使引用一致性翻倍。
为什么选择编译后的 Wiki?
RAG 流程通常使用语义搜索或混合搜索来检索孤立的文本块,将如何关联这些文本块的工作留给智能体自行处理。我们曾探索通过 Agentic RAG 和 基于图的元数据过滤 来改进检索效果,但找到相关段落只是工作的一部分。跨源问题需要追踪引用、解决冲突规则并理解依赖关系。记忆层保留了这种理解能力,使智能体无需在每次提问时重新构建它。
编译后的 Wiki 通过将源材料综合成相互链接的页面,提供这一记忆层,从而解释关键概念及其关系。随着源材料的变化,Wiki 会进行更新,为智能体提供可复用的上下文。
OpenWiki 是我们基于 Deep Agents 构建的开源 CLI 工具,它能创建带有源文件引用的此类 Wiki。我们最初开发它是为了让编码智能体不必在每个任务中重新发现架构和代码行为。
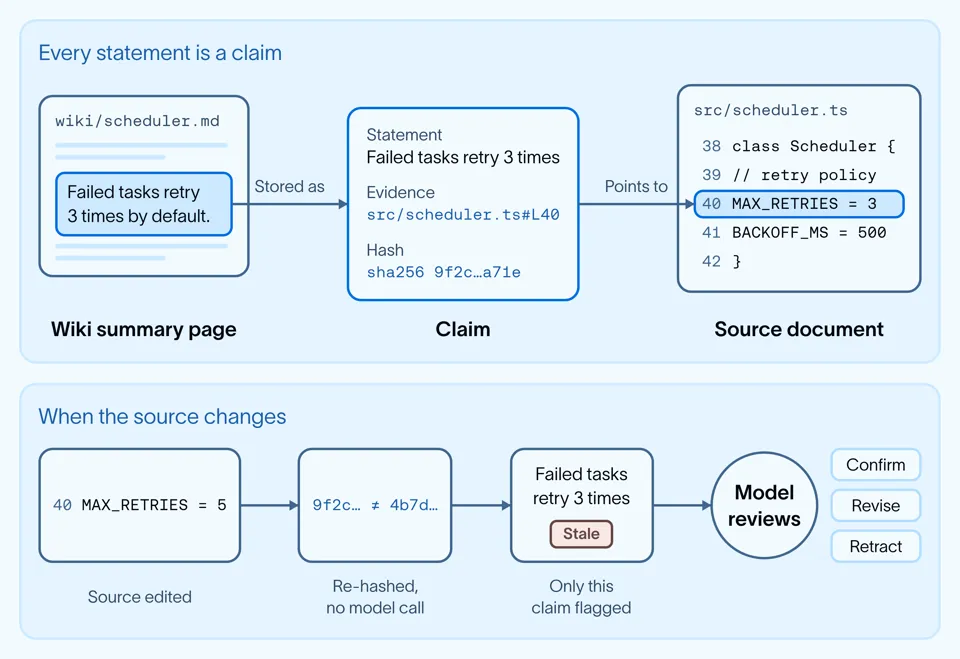
OpenWiki 中的每一条陈述都基于一个 声明(claim),即与支撑源行及其哈希值相关联的断言。当这些源行发生变化时,哈希值也会随之改变,这使得 OpenWiki 能够在不调用模型的情况下标记受影响的声明,从而节省 Token 成本并使陈旧性检测更加确定。只有那些声明会被发送给模型进行确认、修订或撤回,从而使记忆层能够随着源材料的变化自我修正。我们在 在 OpenWiki 中构建自我修正的记忆 一文中对此进行了详细解释。
构建测试文档库
我们构建了一个包含 111 份长篇文档的合成保险文档库。选择保险领域是因为保单和批单经常相互 引用、修改和覆盖;这正是导致检索困难的跨文档依赖关系的典型例子。
为了对基准进行测试评分,我们创建了一个包含 972 条事实的账本,并控制了每条事实应出现的位置、文档之间的引用方式以及版本间的变化内容。我们使用 LLM 生成周围的散文文本,并运行自动化检查以确保所需的事实均已存在。
最后,我们有意将语料库弄得杂乱无章,混入了过时版本、相互矛盾的内容、间接引用链、措辞各异的表述以及超长文档,以更贴近智能体在真实企业知识库中面临的实际情况。
实验配置方式
我们在两种条件下评估了同一个检索智能体:Search(对原始文档进行关键词搜索)和 Wiki(同一智能体访问由 OpenWiki 编译生成的、带有源链接的 Wiki)。底层模型、指令、文档和问题均保持不变——唯一改变的是智能体对已编译记忆的访问权限。
我们测试了 80 个简单查找问题和 50 个关联性问题,后者需要追踪跨文档的依赖关系(例如,识别某项条款依赖于什么,或当该条款变更时哪些内容会受到影响)。为了衡量运行间的波动,我们将每个问题重复提问三次。
指标(“更好”的定义):
- 准确率 (Accuracy, 0–1): 评分器根据源自 972 条事实账本的检查清单,核对答案及引用的证据(奖励包含必要事实的回答,惩罚存在矛盾的回答)。
- 一致性 (Consistency, 0–1): 三次运行中引用证据的重叠程度(引用集合的平均成对 Jaccard 相似度)。这衡量的是智能体是否可靠地基于相同来源为答案提供依据,而非答案是否正确。
- 成本 + 延迟: 模型花费(美元)及每个问题的实际耗时(wall-clock time)。
Wiki 的优势与不足
OpenWiki 以 4.15 美元的成本,将包含 111 份文档的库编译成了大小约为原文档十分之一的 Wiki。后续添加 17 份文档的成本约为每份 0.09 美元。以下分析排除了编译和更新成本,仅报告检索和回答的成本。
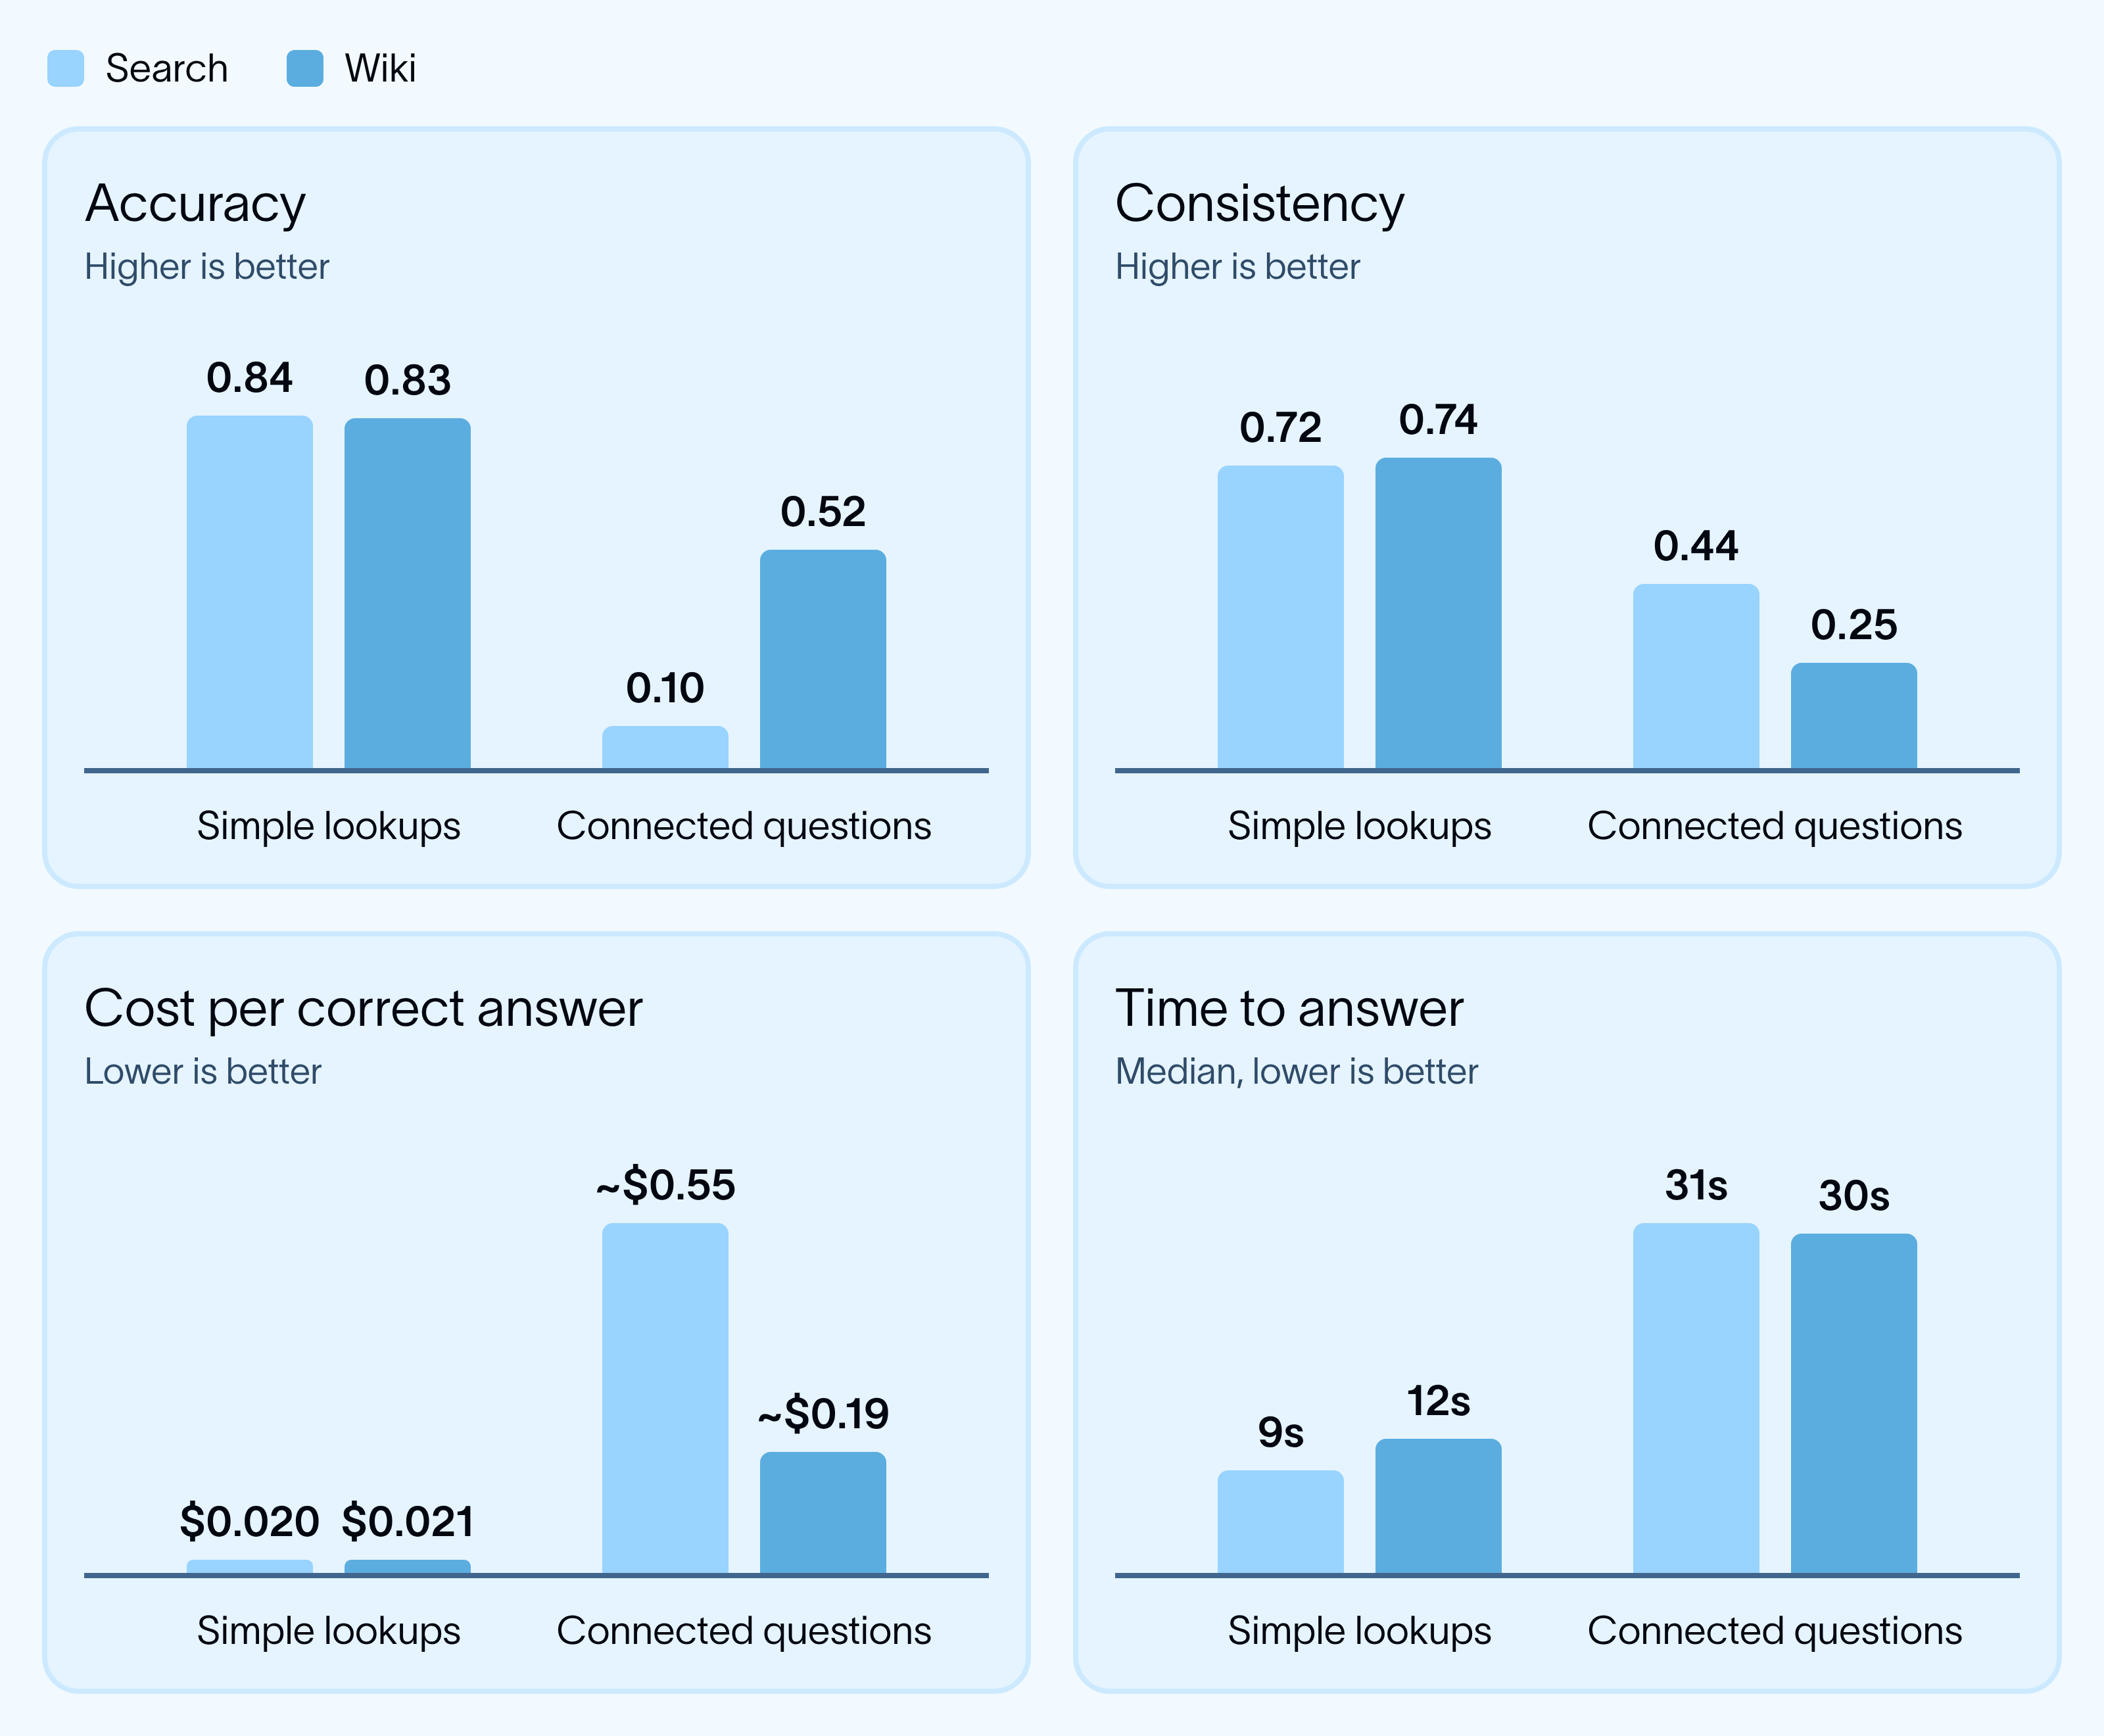
我们将简单查找作为对照组。这类单段落问题几乎不需要跨文档的保险上下文知识,因此我们并不预期 Wiki 能带来显著提升。结果显示,Search 和 Wiki 的表现相近(准确率分别为 0.84 和 0.83;引用重叠度分别为 0.72 和 0.74;每个正确答案的成本分别为 0.020 美元和 0.021 美元),但延迟从 9 秒增加到了 12 秒。
处理关联性问题需要跨源推理,并利用领域特定的关系。在此场景下,Wiki 将准确率提升了约 5 倍,从仅使用搜索时的 0.10 提升至 0.52。其编译后的上下文帮助 Agent 应用领域知识,并以更少的工具调用找到相关关系,从而将每个正确答案的成本从约 $0.55 降低至 $0.19。
尽管在准确率和成本方面取得了这些进展,但 Wiki Agent 的证据检索仍然不够稳定。引用重叠度(Citation overlap)从简单查询时的 0.74 降至关联性问题时的 0.25。引用稳定性并不直接衡量正确性,但当来源存在冲突时,证据的变化会导致答案的改变。对于关键业务功能而言,团队需要的是可复现且可审计的答案,而不仅仅是更高的平均准确率。
Wiki 帮助 Agent 跨源应用了领域知识。剩下的挑战在于如何让通往支持性证据的路径更加可重复。
添加证据图谱
为了使检索更加一致,我们引入了一个轻量级的证据图谱:它将 Wiki 引用转化为声明、Wiki 页面、段落和主题之间显式的、带类型的边。 OpenWiki 引用是 Markdown 文件中的文本引用。该图谱通过将这些引用实体化为带类型的边,使其变得持久可靠。这为 Agent 提供了一条稳定的追踪路径,而不是通过搜索重新发现相同的链接。
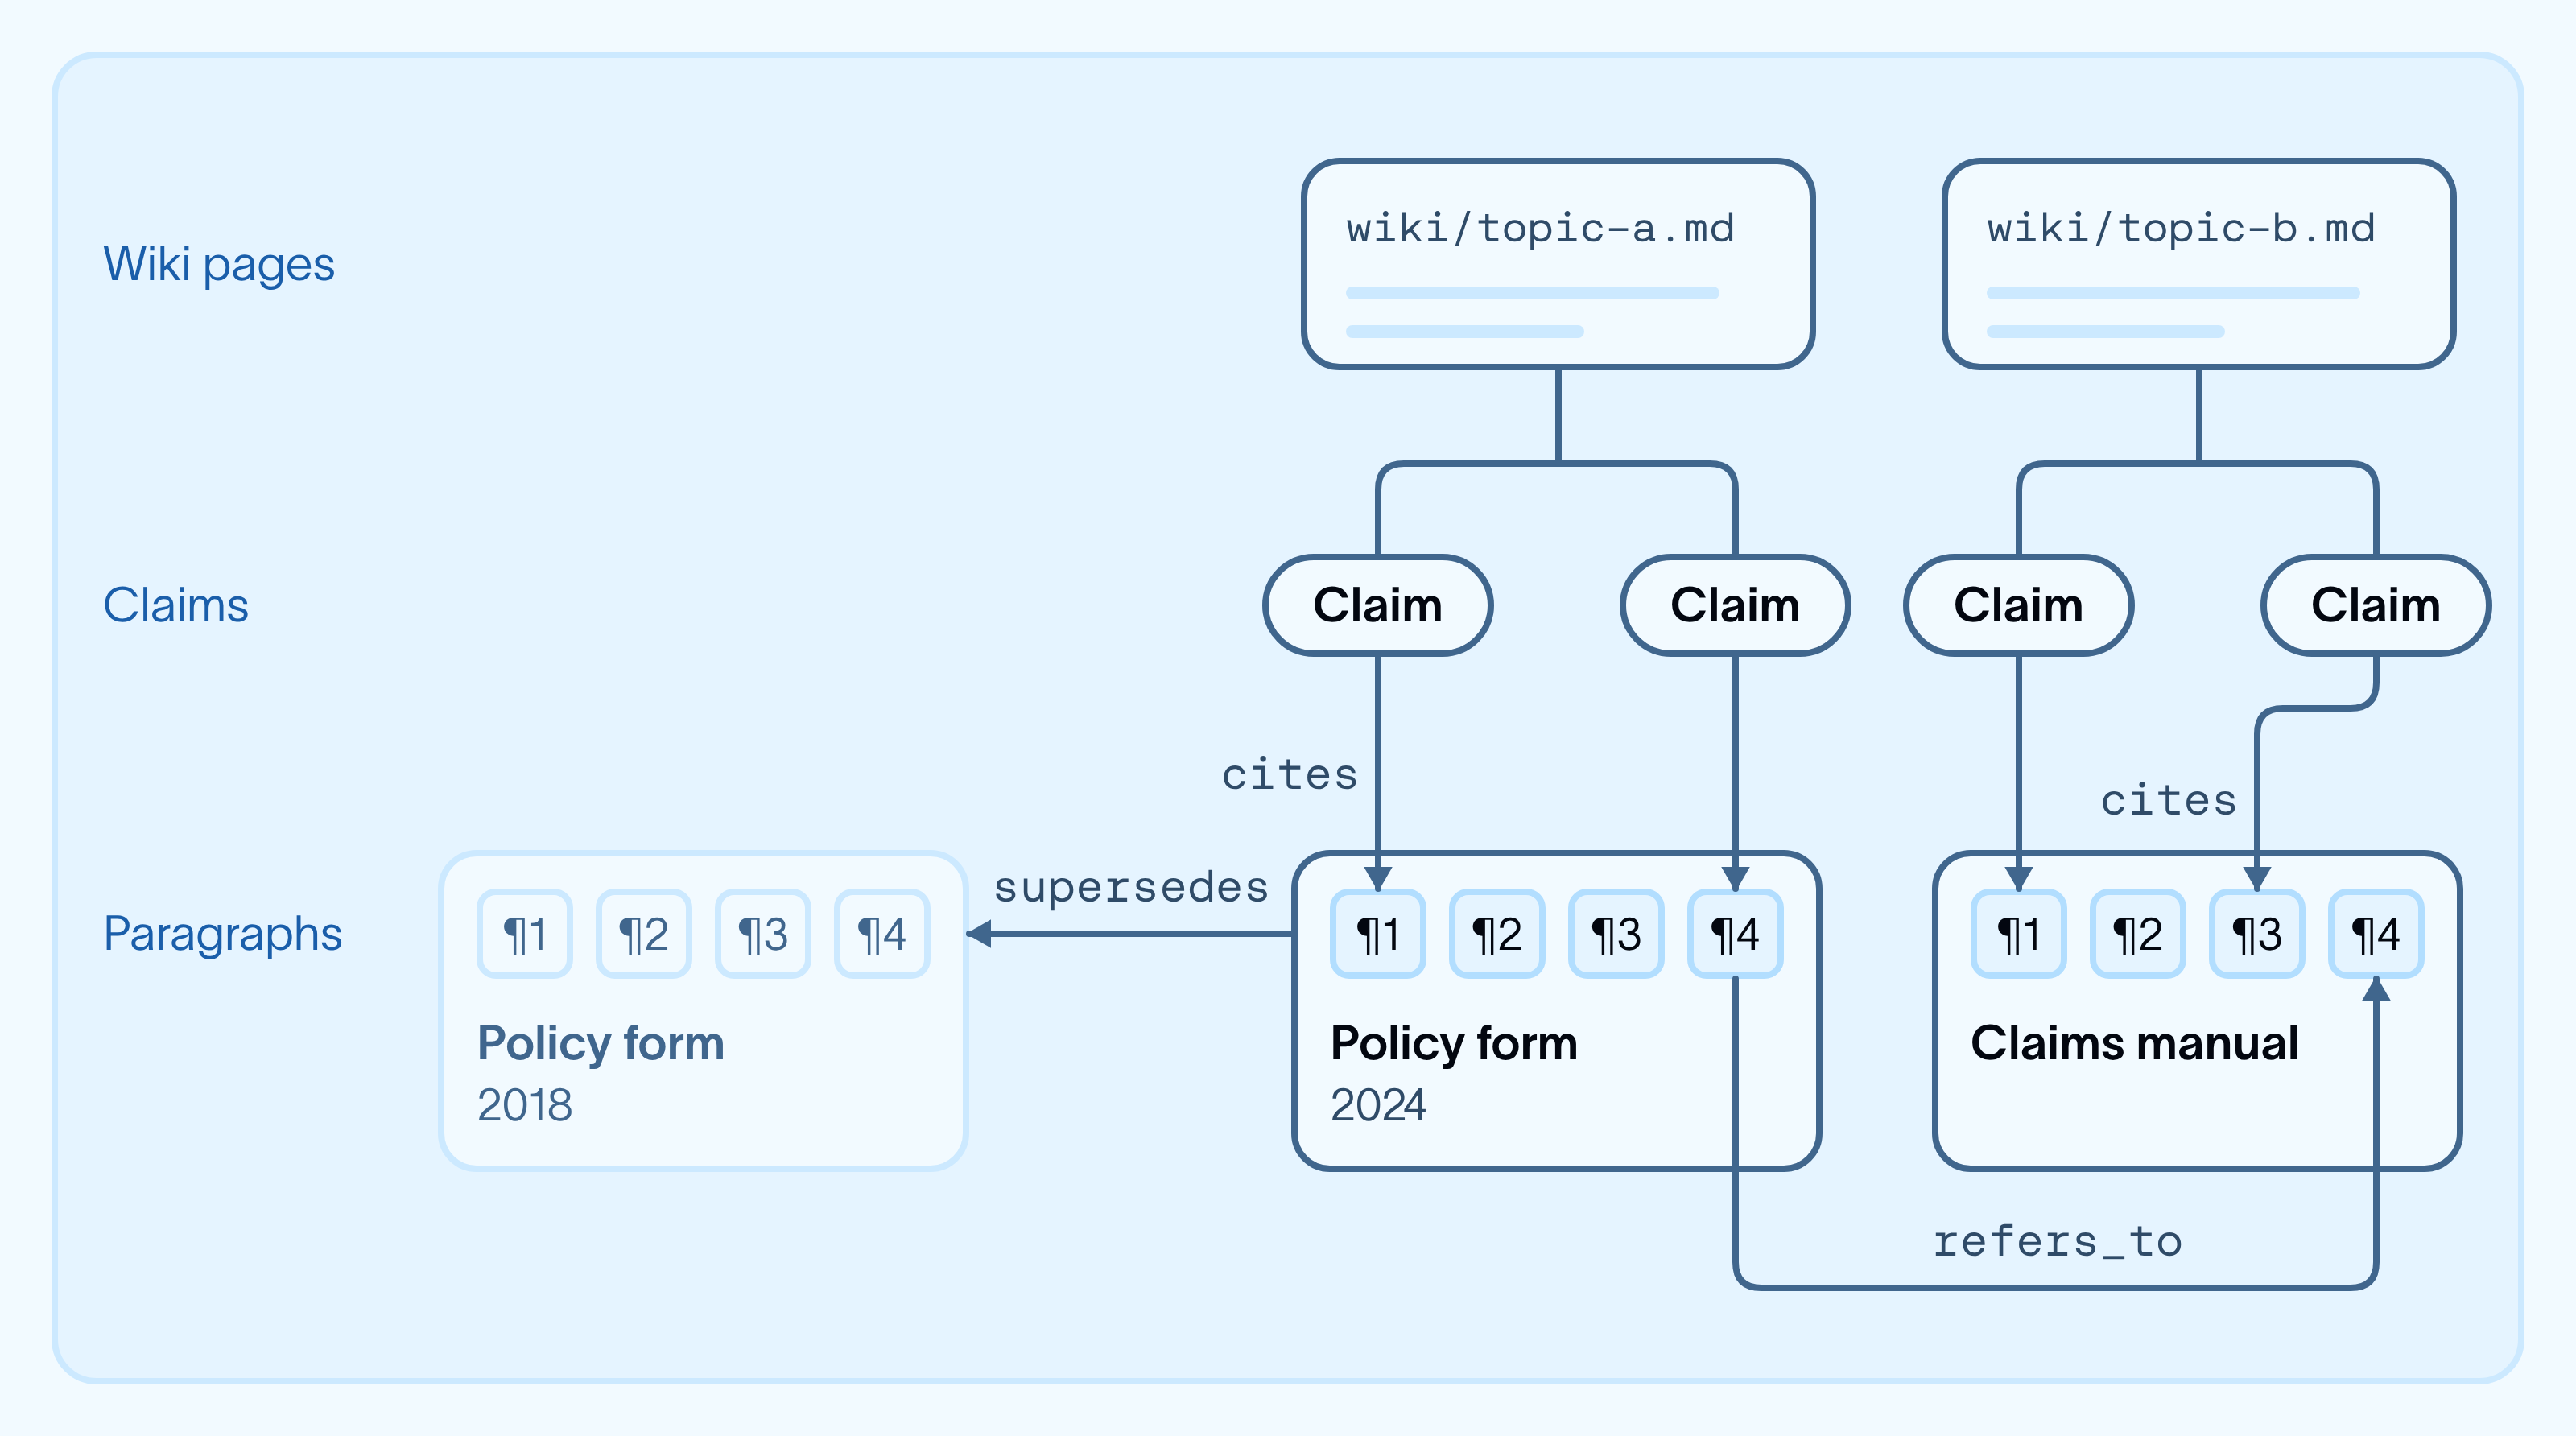
我们通过两个步骤构建了这个图谱:
- 将每个段落存储为新的基本单元。 一个确定性过程将每份文档拆分为段落,并为每个段落分配唯一标识符。这些段落成为信息的最小原子单位,将声明与确切的支撑段落而非整篇文档联系起来。
- 通过带类型的边连接段落。 我们将段落、声明和 Wiki 页面通过带类型的边连接起来:声明
cite(引用)段落,较新的文档supersede(取代)较旧的文档,章节refers_to(指向)其他文档。每条边不仅标识连接,还明确了关系类型。我们以两种方式构建边。部分边是从文档引用中确定性地提取出来的。由于 Wiki 声明已经包含文本引用,我们可以直接实体化诸如refers_to和supersedes这样的带类型边,而无需再次调用模型。
构建图谱耗时不到一秒,并解析了测试库中的所有显式交叉引用,因此智能体可以跟随链接,而无需在每个问题中重新发现关联。
该图谱的任务是证据导航,而非对组织所知的全部内容建模。Wiki 仍然提供综合信息。与提取密集型知识图谱管道不同,这一层复用现有的引用和引文,而不是通过模型提取实体并进行调和。构建过程不需要额外的模型调用,尽管从 Wiki 派生的边仍依赖于其模型生成引文的准确性。
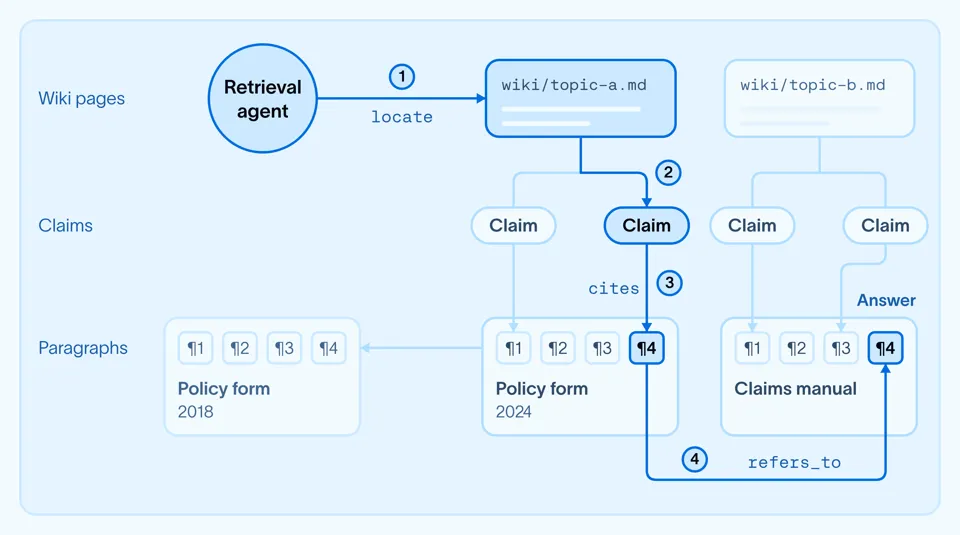
两个工具让智能体在地图上导航:locate 查找与问题匹配的起始点,expand 则跟随其连接到支持性段落和相关文档。当只有一条路径时,expand 会自动跟随;当路径出现分支时,由智能体决定下一步去向。这种定位相关节点并收集连接上下文的模式也出现在 GraphRAG 系统中,例如 Microsoft’s GraphRAG。
@tool(parse_docstring=True)
async def locate(terms: str, within: str | None = None) -> dict:
    """Find where to start: match the question's words against document titles,
    section headings, wiki pages, and claim statements."""
    ...

@tool(parse_docstring=True)
async def expand(node: str, edges: list[str] | None = None, hops: int = 1) -> dict:
    """Open one node and list its typed edges (cites, refers_to, supersedes,
    amends, attaches_to, and their inverses). With hops > 1 and one edge type,
    walk that edge while there is a single path, and stop at a branch."""
    ...
更高的准确率、更低的成本、更快的回答
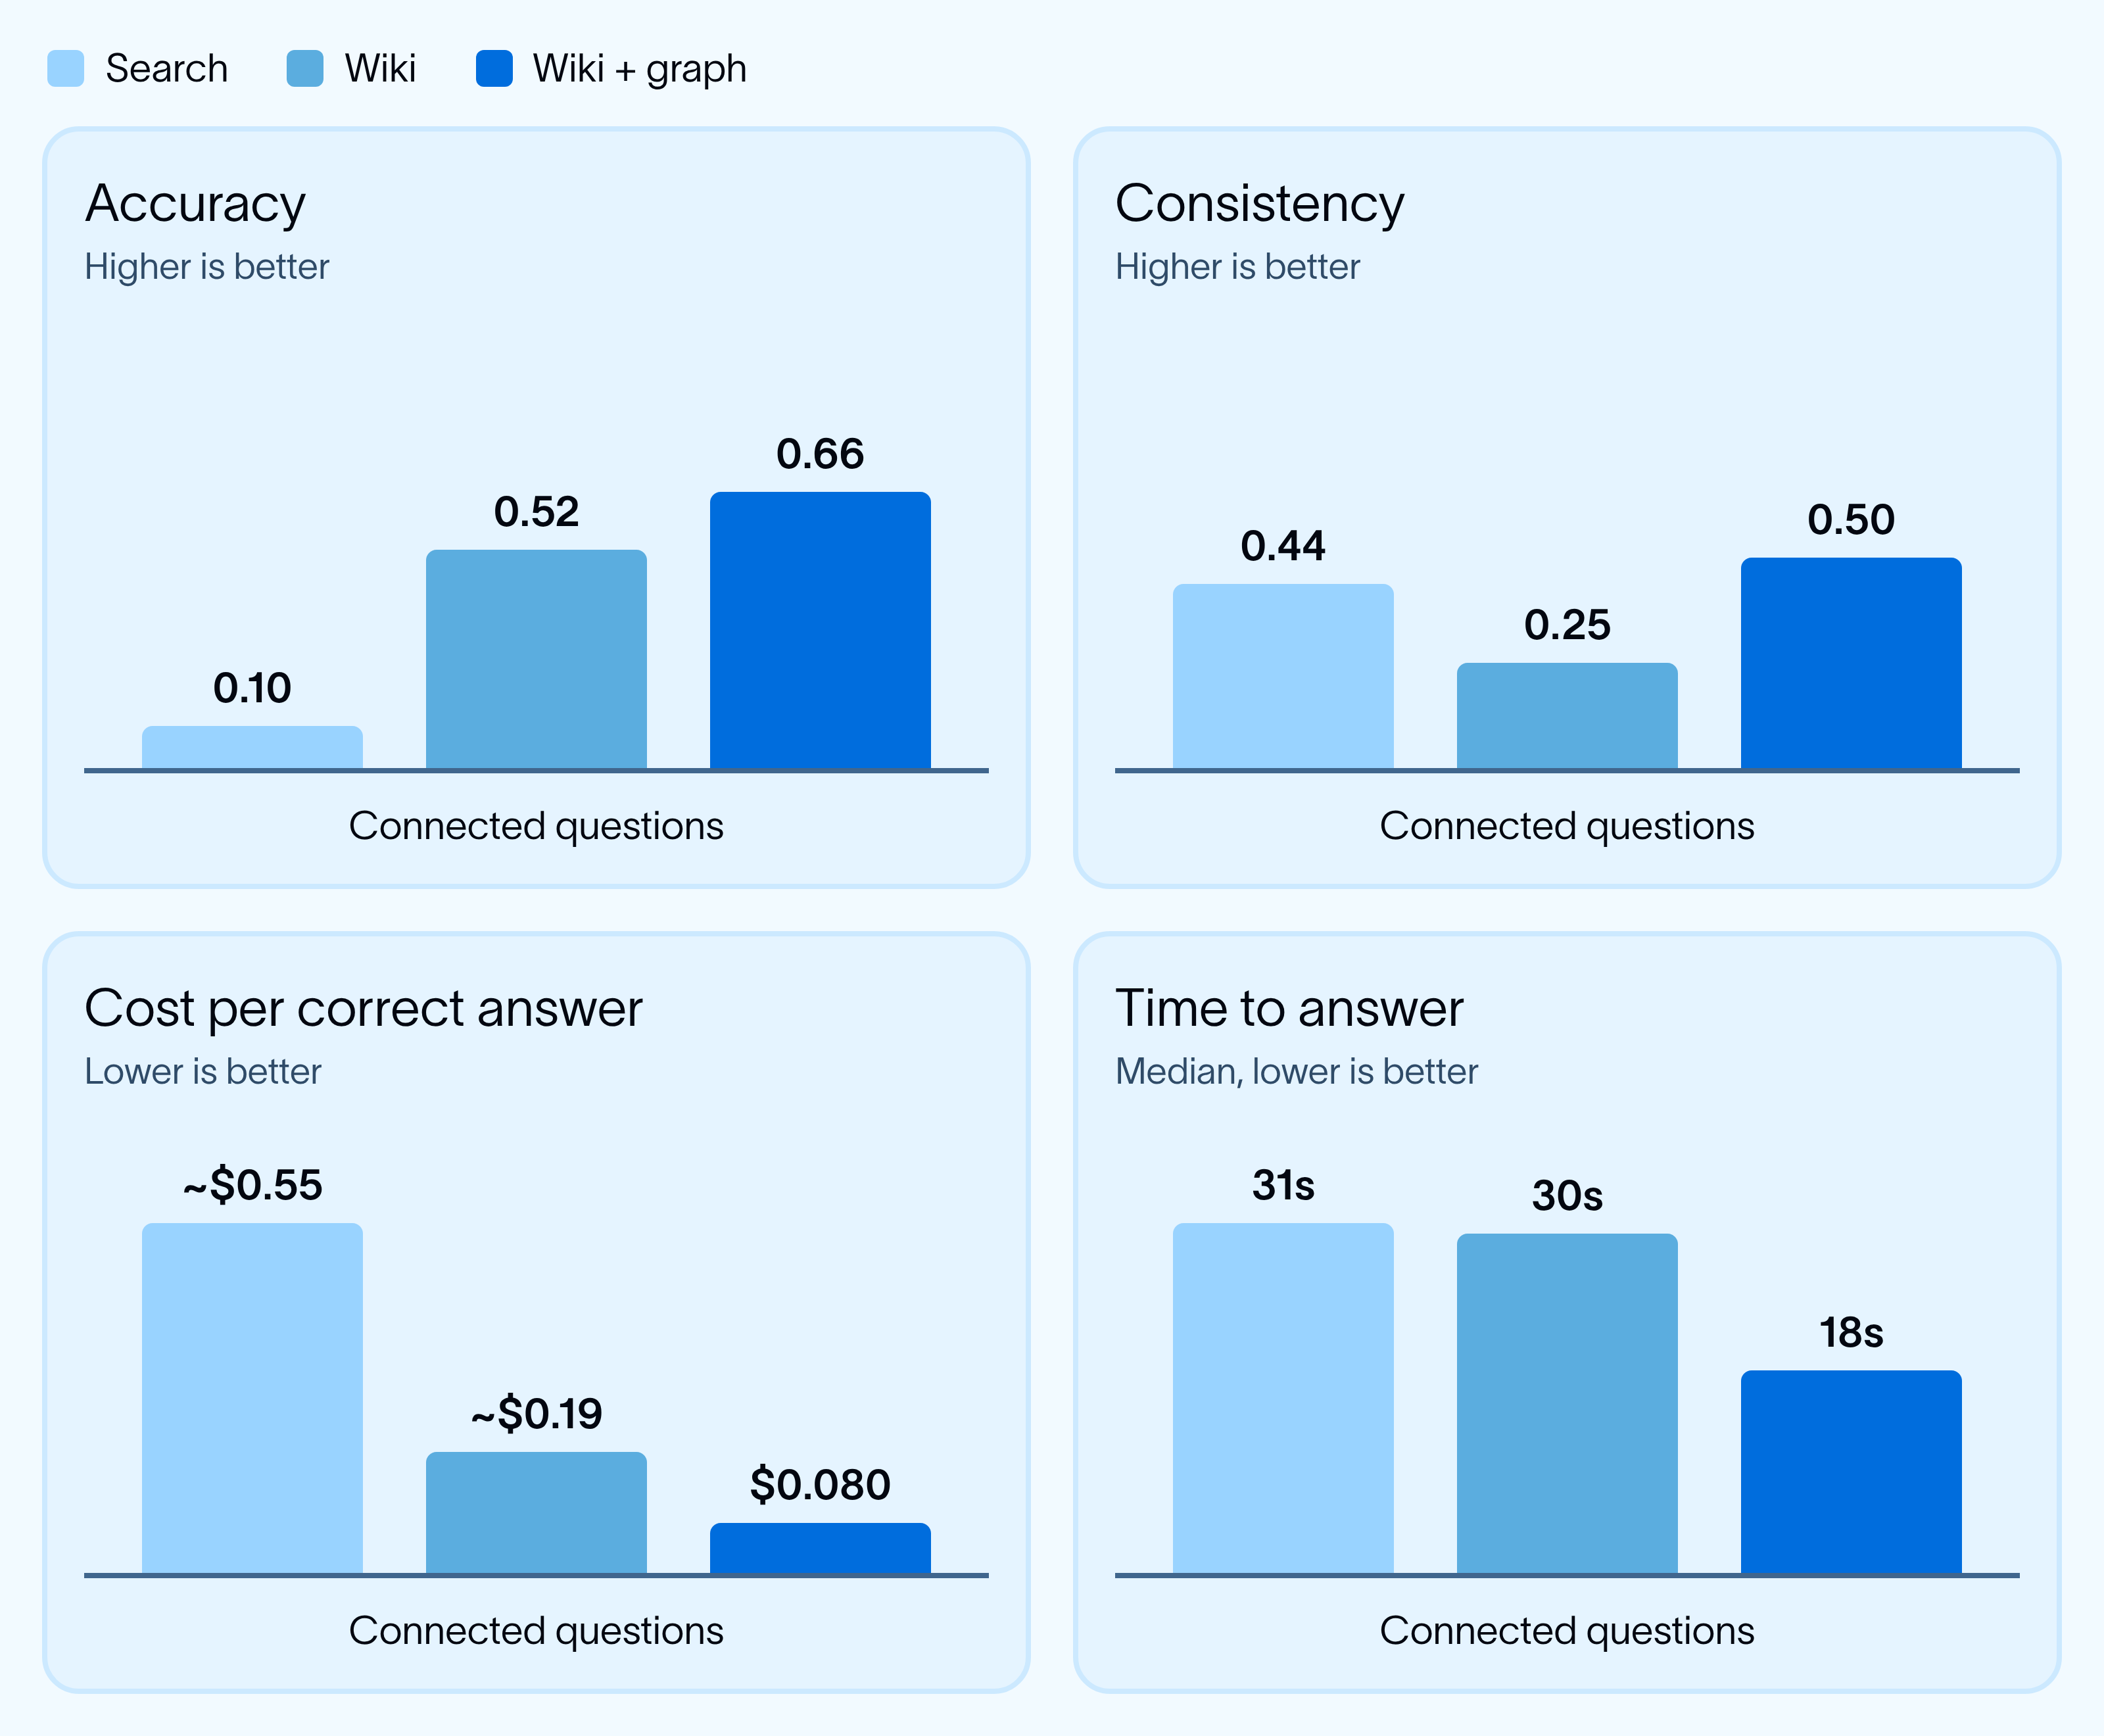
添加显式的证据路径在所有指标上都优于仅使用 Wiki 的情况。准确率提高了 27%,引用一致性翻倍,中位回答时间减少了 40%,每个正确答案的成本降低了 58%。证据图谱通过更具导向性的检索补充了 Wiki 的上下文,从而在不使智能体完全确定化的情况下,同时提升了准确率和一致性。
何时值得为添加记忆付出成本?
编译型 Wiki 最有力的论据在于重复性的跨源推理。在我们的实验中,Wiki 帮助智能体应用领域关系,而非通过搜索重新构建这些关系。但仅靠记忆层并不能保证证据检索的一致性。添加显式的图边(graph edges)提高了引用的一致性和准确性,同时减少了检索工作量。
Wiki 为轻量级证据图提供了坚实的基础,该图可确定性地从其现有的引用和文档参考中派生而来。这使我们能够添加显式的证据路径,而无需额外的模型调用,也不必对组织所知的所有内容都进行建模。
Wiki 是否值得投入取决于复用率。我们报告的问答成本不包含编译过程,且每添加一个文档的成本约为 0.09 美元。对于简单的查找任务,摄入和持续维护的成本可能会超过检索带来的节省,因为在企业规模下,仅使用搜索同样准确且速度更快。
当多个智能体反复回答涉及相同离散来源的问题时,权衡点就会发生变化。共享的 Wiki 保留了这些来源之间的关系,而图边则引导智能体找到支持性证据。在我们的测试中,这种组合以每次正确回答更低的成本产生了更准确的答案。在足够的复用情况下,避免重复上下文重建所节省的成本可以抵消构建和维护记忆的费用。
下一步计划
接下来,我们希望更动态地构建 Wiki,仅编译并保留智能体处理跨源问题所需的上下文,而不是整个代码库。
我们还希望探索声明(claims)和类型化边(typed edges),作为其他类型智能体记忆的基础。将知识与证据关联起来,并检测知识何时发生变化,可能有助于夯实语义记忆(事实)、情景记忆(发生了什么)和程序性记忆(如何做事情)。
想要在你的智能体中添加 Wiki 吗?请查看我们的 OpenWiki 资源:
致谢
感谢 Colin Francis 和 Nick Hollon 就 OpenWiki 及评估提出的宝贵意见!