斯坦福发现 8 款大模型评审医学答案时集体偏袒自身
原标题:New Stanford paper finds that all 8 LLMs tested rank their own medical answers higher than other mod...
78AI 研判分
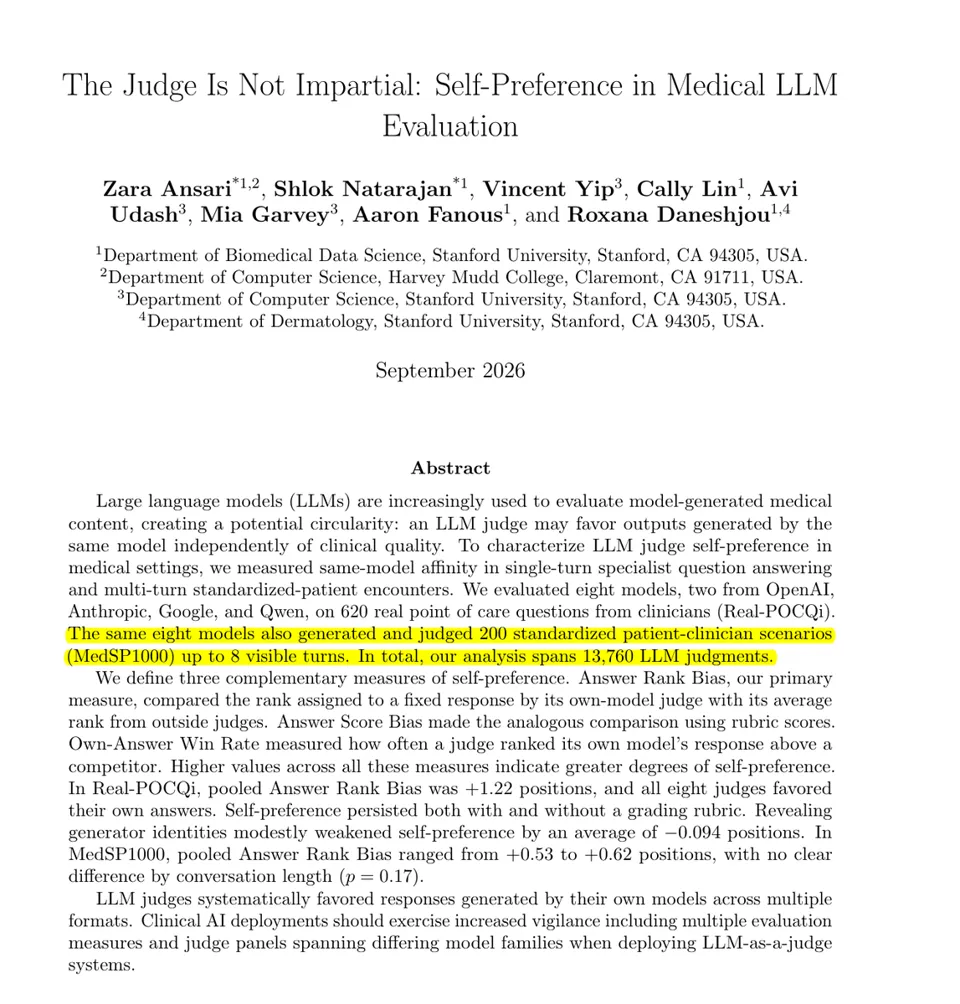
斯坦福新论文让 OpenAI、Anthropic、Google 与 Qwen 的 8 款模型回答 620 个真实临床问题,再匿名互评全部答案,结果每个评审模型都给自己更高排名,平均高出 1.22 个位次,GPT-5.6 Sol 接近 3 个位次。该偏差在无评分标准时依然存在,公开模型名称也只能削弱 0.094 个位次,说明以 LLM 作为裁判的医学评测存在系统性自利倾向。作者建议改用跨模型家族评审团并分评审报告结果,而非汇总单一分数。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-18 04
斯坦福大学的一篇新论文发现,在测试的全部 8 个 LLM 中,每个模型对自己医疗回答的排名都高于其他模型对同一回答的排名,即使回答是匿名的也是如此。
医疗 AI 基准测试常常使用 LLM 来给其他 LLM 的回答打分。如果评判模型偏袒自己的输出,基准结果就会向该模型倾斜。
他们让来自 OpenAI、Anthropic、Google 和 Qwen 的 8 个模型回答 620 个真实的临床医生问题,然后对全部 8 个匿名回答进行排名。他们比较了每个评判模型把自己回答排在什么位置,以及其他 7 个评判模型把同一回答排在什么位置。
每个评判模型都偏袒自己的回答,平均高出 1.22 个排名位次,而 GPT-5.6 Sol 高出近 3 个位次。这种偏差在没有评分标准时依然存在,而公开模型名称也只能将其缩小 0.094 个位次。
如果你使用 LLM 作为评判模型,请使用来自多个模型家族的评审团,并按每个评判模型分别报告结果,而不是只给出一个汇总分数。