微软新研究揭示大模型遭错误质疑时放弃正确答案
原标题:New Microsoft paper finds that LLMs give up correct answers when challenged with wrong arguments, an...
78AI 研判分
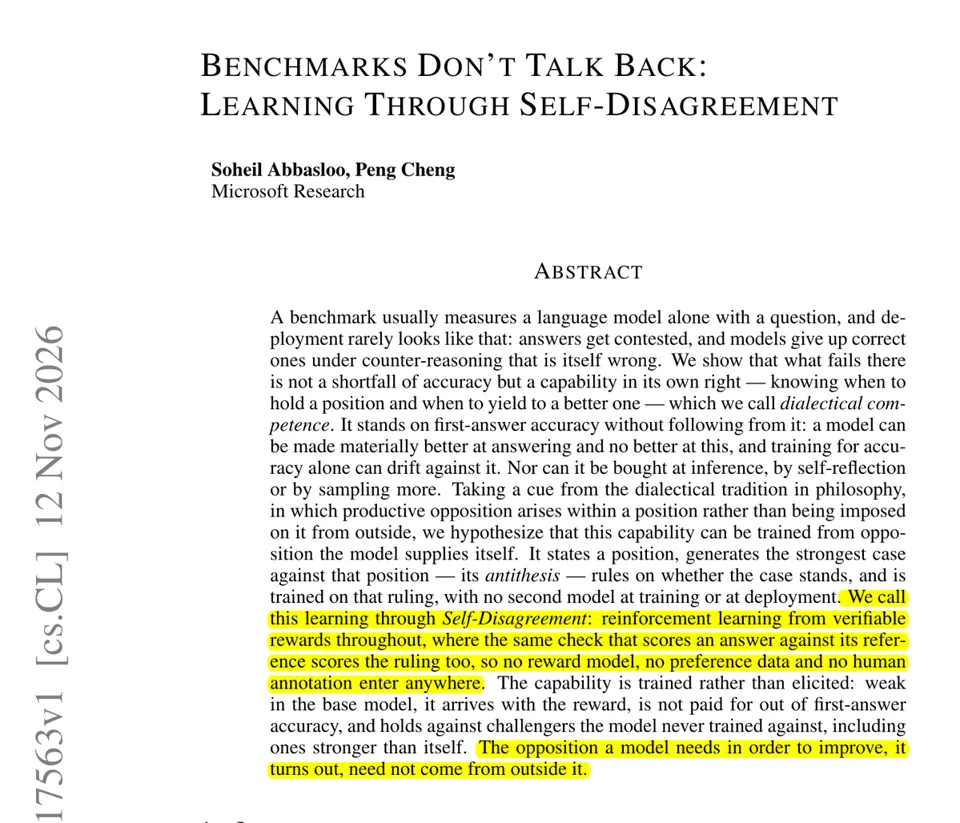
微软最新论文发现,当用户或其他智能体以错误论据质疑模型答案时,大模型往往会放弃原本正确的回答,且单纯提升准确率的训练无法解决这一问题。研究提出 Self-Disagreement 训练法,让模型先作答、再写出最强反驳、最后裁决并重新作答,使 Qwen3-8B 与 Gemma-2 9B 在错误质疑下保持正确答案的比例从 53.3% 和 25.1% 提升至约 89%。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-18 16
微软的新论文发现,当 LLM 面对错误论据的质疑时,会放弃原本正确的答案,而准确率训练并不能解决这个问题。
当用户或其他 agent 对某个答案提出异议时,即使质疑本身是错误的,模型也常常会放弃正确答案。更多的准确率训练、更多的采样或自我反思都无法解决这个问题。
Self-Disagreement 训练让同一个模型先给出一个答案,再写出反对该答案的最强论证,然后对该论证作出裁决并再次作答。一个标准的答案检查器会对最终答案和裁决结果给予奖励。
当质疑者出错时,基础版 Qwen3-8B 有 53.3% 的概率坚持正确答案,Gemma-2 9B 为 25.1%。经过训练后,两者坚持正确答案的概率都提升到约 89%,而仅做准确率训练则完全没有带来这种能力。
如果你的模型会面对来自用户或其他 agent 的反驳,不妨测试一下它有多频繁地放弃正确答案,因为准确率分数并不会体现这一点。