NVIDIA Nemotron 3.5 Super VL 上线 AWS EKS 与 SageMaker HyperPod
NVIDIA 推出 120B 参数混合专家模型 Nemotron 3.5 Super VL,现已支持在 Amazon EKS 和 SageMaker HyperPod 上部署。该模型单次推理仅激活 12B 参数,统一处理文本、图像及视频理解任务,旨在加速智能体 AI 的开发与落地。
报道正文
本文目录9 个章节
NVIDIA Nemotron 3.5 Super VL 加入了已在 AWS 上可用的 NVIDIA Nemotron 3 Nano、Nano Omni、Super、Ultra 以及 Nemotron 3.5 Lightning 模型系列。这是一个拥有 120B 参数的混合专家(MoE)模型,每个 token 激活 12B 参数。它将推理和工具使用能力与文本、图像、文档及视频理解相结合,使得单一模型即可同时服务于文本和视觉任务。本文将探讨其架构和应用场景,并展示如何在 Amazon Elastic Kubernetes Service (Amazon EKS)、Amazon EKS Auto Mode 和 Amazon SageMaker HyperPod EKS 上部署该模型。
关于 Nemotron 3.5 Super VL
NVIDIA Nemotron 3.5 Super VL 是一个从 Nemotron 3 Ultra 蒸馏而来的开源多模态模型。NVIDIA 发布了模型权重、训练数据集和后训练配方,因此你可以针对特定领域的工作负载定制该模型,并在自己控制的基础设施上运行它。模型详情如下:
- 总参数量 120B,每个 token 激活 12B 参数。
- 采用混合 Mamba-2、MoE 和注意力层,并配备 RADIO 视觉编码器。
- 上下文长度最高可达 1M tokens。
- 输入:文本、图像、文档和视频。
- 输出:文本。
- 提供 BF16 和 NVFP4 检查点。
NVIDIA 报告称,该模型在 Hermes Bench 上的得分为 63.44%,在 LangChain agent 评估中得分为 87.05%,在 CharXiv 图表推理基准测试中得分为 80.8%。(技术报告)
模型架构
Nemotron 3.5 Super VL 采用混合 Mamba-Transformer MoE 架构,交错排列 Mamba-2、注意力层和专家层。稀疏路由机制在每个 token 上仅激活 120B 参数中的 12B,因此每个 token 的计算量相当于一个更小的模型,而 GPU 显存仍需存储完整权重。Mamba-2 层在生成过程中保持恒定大小的状态,其内存占用不会像 KV Cache 那样随序列长度增长,从而使得长上下文处理更具成本效益。递归共享的多 Token 预测(MTP)头支持原生推测解码。
应用场景
Nemotron 3.5 Super VL 支持结合推理与视觉理解的智能体工作流:
- 编程: 测试并验证代码,分析错误,推荐修复方案。
- 网络研究: 交叉引用并验证搜索工具返回的信息源。
- 文档智能: 读取表格、图表和页面布局以生成摘要。
- 网络安全: 识别漏洞并对威胁进行分诊。
- 视频理解: 搜索、内容审核及事件分析。
Nemotron 3.5 Super VL 通过 NVIDIA 参考实现、Cookbook 以及 NVIDIA Agent Toolkit 与主流开源智能体框架和编排系统集成。有关支持的框架完整列表,请参阅 NVIDIA 开发者博客。
最低 GPU 配置
| vLLM (GPU 型号 / 最小数量) | BF16 | NVFP4 |
|---|---|---|
| B200/GB200 | 8 | 2 |
| B300/GB300 | 4 | 1 |
| H200 | 8 | 4 |
| H100 | 16 | 8 |
在 AWS 上的部署
部署架构
参考实现运行在标准的 Amazon EKS、EKS Auto Mode 以及 SageMaker HyperPod EKS 上。使用 EKS Auto Mode 时,AWS 会代您管理集群的扩缩容、GPU 和 EFA 支持。用于模型部署的 Kubernetes manifest 文件在所有编排器选项中均保持一致。每个集群都包含一个托管 Kubernetes API 的控制平面,以及由 CPU 和 GPU 节点组成的数据平面。CPU 节点运行系统和测试 Pod,而 GPU 节点运行模型。Amazon Elastic Container Registry (Amazon ECR) 存储容器镜像,共享的 Amazon FSx for Lustre 卷保存模型权重,Elastic Fabric Adapter (EFA) 则连接各个 GPU 节点。下图展示了一个标准的 Amazon EKS 集群。
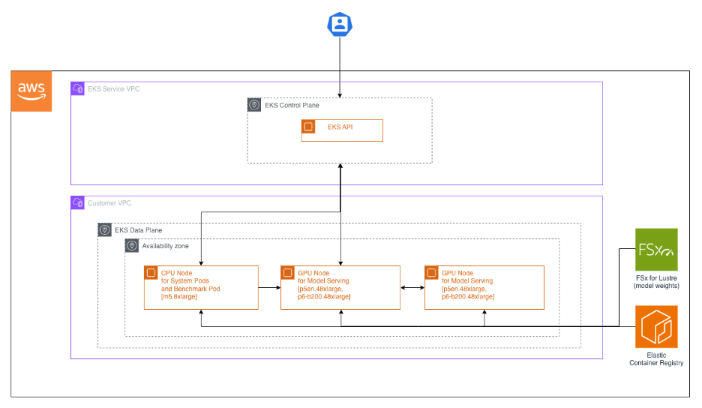
图 1:用于服务 NVIDIA Nemotron 模型的标准 Amazon EKS 集群架构
NVIDIA Dynamo 可以在单个节点上聚合服务模型,也可以将预填充(prefill)和解码(decode)阶段分离到不同节点上进行解耦服务。对于视觉语言模型,图像/视频编码阶段还可以额外在独立节点上以解耦方式运行。
验证与性能
该架构已在 p6-b200.48xlarge(8 x NVIDIA B200 GPU)和 p5en.48xlarge(8 x NVIDIA H200 GPU)实例上完成验证。您可以使用 NVIDIA Collective Communications Library (NCCL) all-reduce 微基准测试来验证集群及其网络状况。
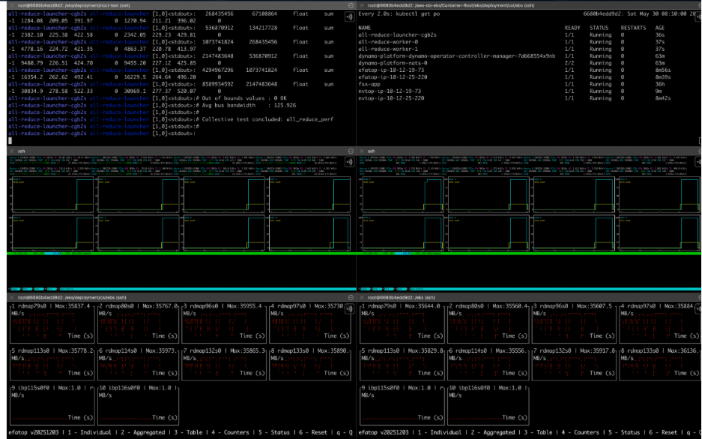
图 2:NCCL all-reduce 验证测试期间的 GPU 和 EFA 利用率
在运行 NCCL 测试期间,如果观察到所有 GPU 均有利用率且所有 EFA 适配器均有流量,则表明集群工作正常。
您可以使用 NVIDIA aiperf 工具来测量部署在集群上的模型的性能。

图 3:已部署模型的 aiperf 性能指标
左上角面板中的 aiperf 输出显示了关键性能指标 (KPI),例如首 token 时间 (TTFT)、token 间延迟 (ITL) 以及以每秒 token 数 (TPS) 为单位的吞吐量。通过在不同并发级别下进行这些测量,我们可以研究延迟和吞吐量如何随并发请求数量的变化而变化。这些信息对于精心规划容量和模型部署拓扑至关重要。aws-do-eks 容器提供了自动化功能,可用于可视化 GPU 和 EFA 利用率,并通过单条命令运行 aiperf 和并发扫描。

图 4:比较聚合部署与分离式部署的并发扫描
上述并发扫描图表明,在双节点上,Nemotron 3.5 Super VL 的推理在聚合部署与分离式部署之间具有更低的 TTFT 和大致相同的 ITL。
这种图表在做出部署决策时非常有用。将你的延迟预算绘制为水平线,例如 TTFT 低于 600 ms(约 1 秒)且 ITL 低于每 token 100 ms。位于两条线下方最右侧的点即为该拓扑的一个副本在服务级别目标 (SLO) 内可提供的吞吐量,此处为 c32,即大约每秒 320 个 token。为了规划容量,请将目标每秒 token 数除以这个每副本吞吐量,从而确定需要部署的预填充-解码对数量。在进行更改后(如精度调整、TP/PP 形状变更、聚合与分离式部署切换、新的 Dynamo 或 vLLM 版本发布),重新运行相同的扫描可以立即显现权衡结果。曲线向右下方移动意味着改进。由于 TTFT 和 ITL 是分开绘制的,这还能告诉你应该扩展哪一侧:ITL 上升意味着需要增加解码容量,而 TTFT 上升则意味着需要增加预填充容量。
结论
本文介绍了在 Amazon EKS、EKS Auto Mode 以及 SageMaker HyperPod EKS 上,使用 NVIDIA Dynamo 和 vLLM 部署 NVIDIA Nemotron 模型的架构设计与性能评估模式。如需快速上手,请通过参考实现在你的账户中部署 Nemotron 3.5 Super VL。更多推理蓝图也可在 AI on EKS 项目中获取。若想进一步积累在 EKS 上进行推理的实践体验,欢迎报名参加我们即将举办的工作坊。
致谢
作者谨向所有参与开发、验证、审阅及发布本内容的同仁致以特别感谢,包括但不限于:Eliuth Triana, Jiahong Liu, Kshitiz Gupta, Abhijeet Patil, Mike Stefaniak, Chris Splinter, Sheetal Joshi, Aditya Ramakrishnan, Natarajan Kumar, Anish Maddipoti。