SemiAnalysis 发布 GDPx 基准 AI Agent 专家任务得分极低
原标题:SemiAnalysis has released GDPx, a benchmark testing AI agents on expert work across 11 domains.
85AI 研判分
SemiAnalysis 推出 GDPx 基准,评估 AI Agent 在芯片设计、金融等 11 个领域的专家级工作能力。结果显示当前最强模型 Claude Opus 5.5 平均分仅 12%,且在金融和法律任务中全部得分为零,暴露出智能体在处理复杂真实工作流时的巨大能力缺口。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-02 12
SemiAnalysis 发布了 GDPx,这是一个测试 AI Agent 在 11 个领域专家级工作表现的基准。
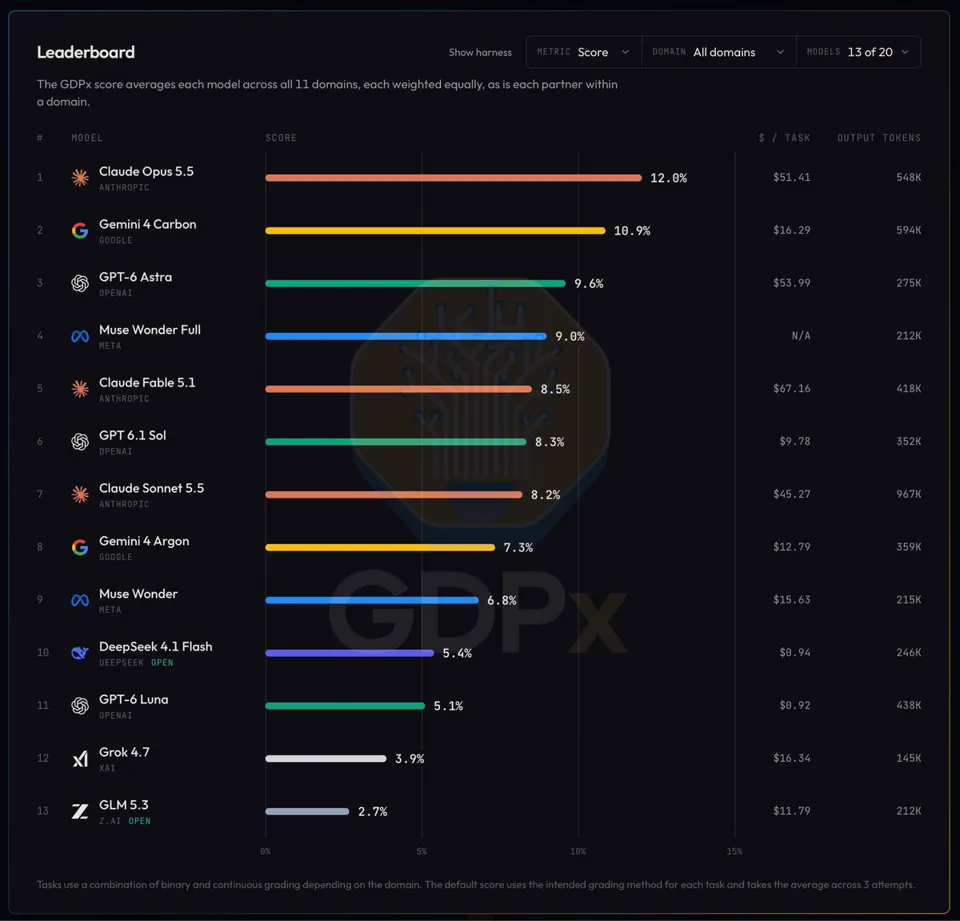
表现最佳的模型是 Anthropic 的 Claude Opus 5.5,平均得分仅为 12%,紧随其后的是 Google 的 Gemini 4 Carbon,得分为 10.9%。
OpenAI 的 GPT-6 Astra 在 AI 研究和材料科学任务中位居榜首。
这些任务涵盖芯片设计、网络安全、金融和法律等领域,数据来自 14 家专业合作伙伴。
与 OpenAI 的 GDPval 不同(后者直接在提示词中向模型提供上下文),GDPx 要求 Agent 自行在工作空间中挖掘信息,例如一个包含 3,983 个文件的真实收购案副本。
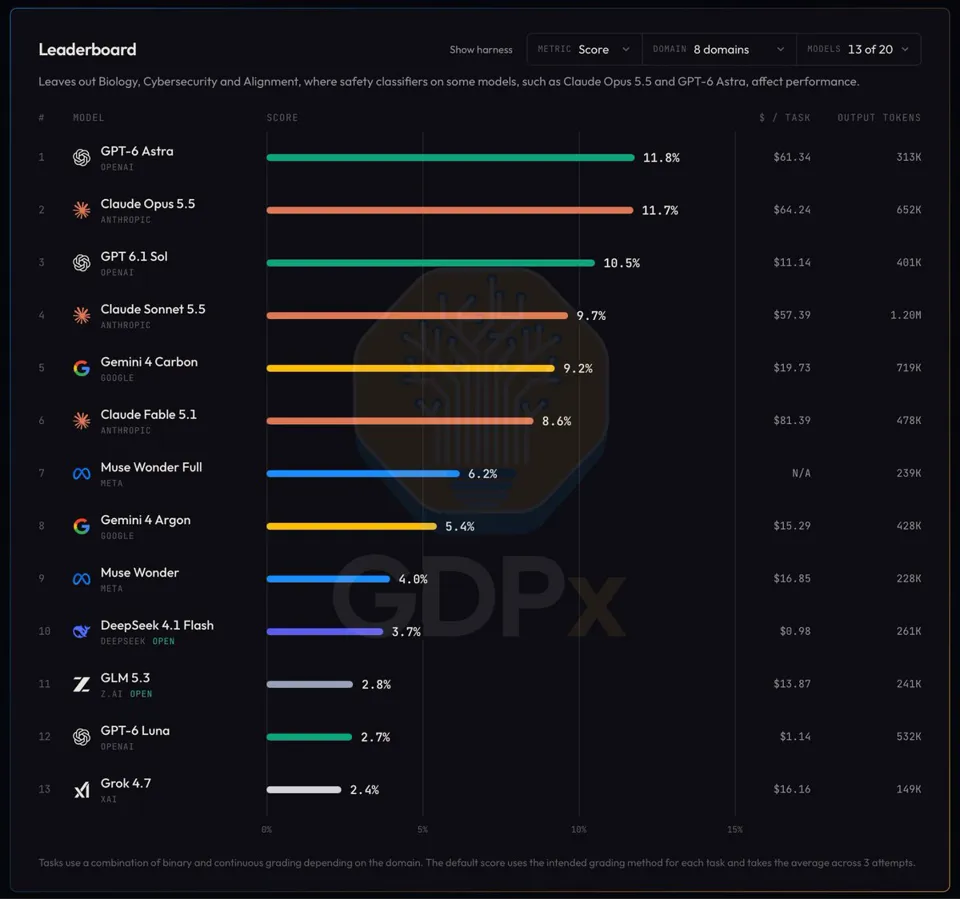
若排除网络、生物和对齐领域(在这些领域中安全分类器有时会进行干预),OpenAI 的 GPT-6 Astra 得分将从 9.6% 提升至 11.8%,从而超越 Opus。
金融和法律任务让所有模型都败下阵来:在通过/失败评分标准下,所有模型均得 0 分,因此 GDPx 改为报告部分得分。
当被要求改进一个现有的交易策略时,模型在 111 次尝试中有 70 次的表现比原始策略更差,它们往往只是承担更大的风险,而不是寻找更好的交易机会。