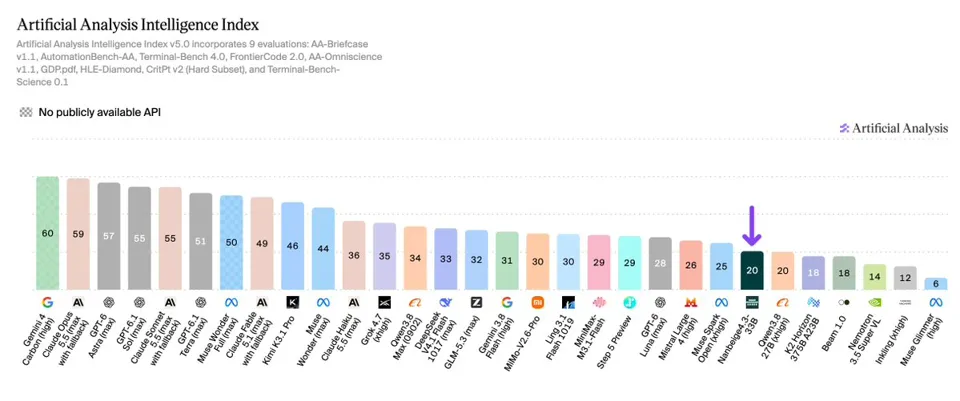
BOSS 直聘团队开源 Nanbeige4.3-33B 推理模型,综合智能追平 Qwen3.8 27B
BOSS 直聘旗下基础模型团队 Nanbeige 以 Apache 2.0 协议开源 33B 稠密推理模型 Nanbeige4.3-33B,在 Artificial Analysis 智能指数 v5 上得 20 分,与 Qwen3.8 27B(xhigh)持平。该模型支持 524K token 上下文、仅文本输入输出,体积小到可在笔记本本地运行,终端操作与物理推理为相对强项,但知识类基准明显落后。
报道正文
Artificial Analysis (@ArtificialAnlys) · 2026-11-05 17
南北阁(Nanbeige)发布了 Nanbeige4.3-33B,这是一个开放权重模型,在 Artificial Analysis Intelligence Index v5 上得分 20,与 Qwen3.8 27B(xhigh)持平,终端使用能力更强,但知识能力较弱。
@Nanbeige 是 BOSS 直聘的基础模型研究团队,BOSS 直聘是由看准有限公司运营的中国招聘平台。其稠密 33B 推理模型以 Apache 2.0 许可开放权重,仅支持文本输入和输出,上下文窗口为 524K token,且规模小到足以在笔记本电脑上本地运行。
关键结果:
➤ 在约 30B 总参数规模下具备竞争力。Nanbeige4.3-33B 和 Qwen3.8 27B(xhigh)均得分 20,而 Muse Glimmer(high,30B)为 6。
➤ 终端使用和物理推理是相对优势。Nanbeige 在 Terminal-Bench 4.0 上得分 30%,在 CritPt v2 的 Hard Subset 上得分 16%,而 Qwen3.8 27B 分别为 6% 和 4%。
➤ 尽管总分相同,优势领域与 Qwen3.8 27B 不同。Nanbeige 在 AutomationBench-AA 上优于 Qwen3.8 27B(53% 对 48%),但在 AA-Briefcase v1.1(1162 对 1391 Elo)、FrontierCode 2.0(11% 对 15%)和 HLE-Diamond(7% 对 15%)上落后。
➤ 在 Omniscience 上具有高弃答率和低幻觉率。Nanbeige 在 AA-Omniscience v1.1 上得分 -4,而 Qwen3.8 27B 为 -6,幻觉率为 18% 对 29%。它正确回答的问题更少(12% 对 17%),并对 71% 的问题选择弃答。
➤ 智能水平相近,但每个任务消耗更多输出 token。Nanbeige 在每个 Intelligence Index 任务上使用 158K 输出 token,而 Qwen3.8 27B 为 110K,约多 44%。
模型其他细节:
➤ 类型:开放权重推理模型(Apache 2.0 许可证)
➤ 规模:33B 总参数(稠密)
➤ 模态:仅文本输入和输出
➤ 上下文窗口:524K
➤ API 可用性:无已确认的公开第一方或第三方 API