Rohan Paul (@rohanpaul_ai) · 2026/10/21 03:39:01
OXR 发布开源文档解析模型 引入 RSI 训练机制
出处作者 / 发布主体:Rohan Paul (@rohanpaul_ai)原标题:OXR makes parsing failures part of the training process.
78AI 研判分
核心综述
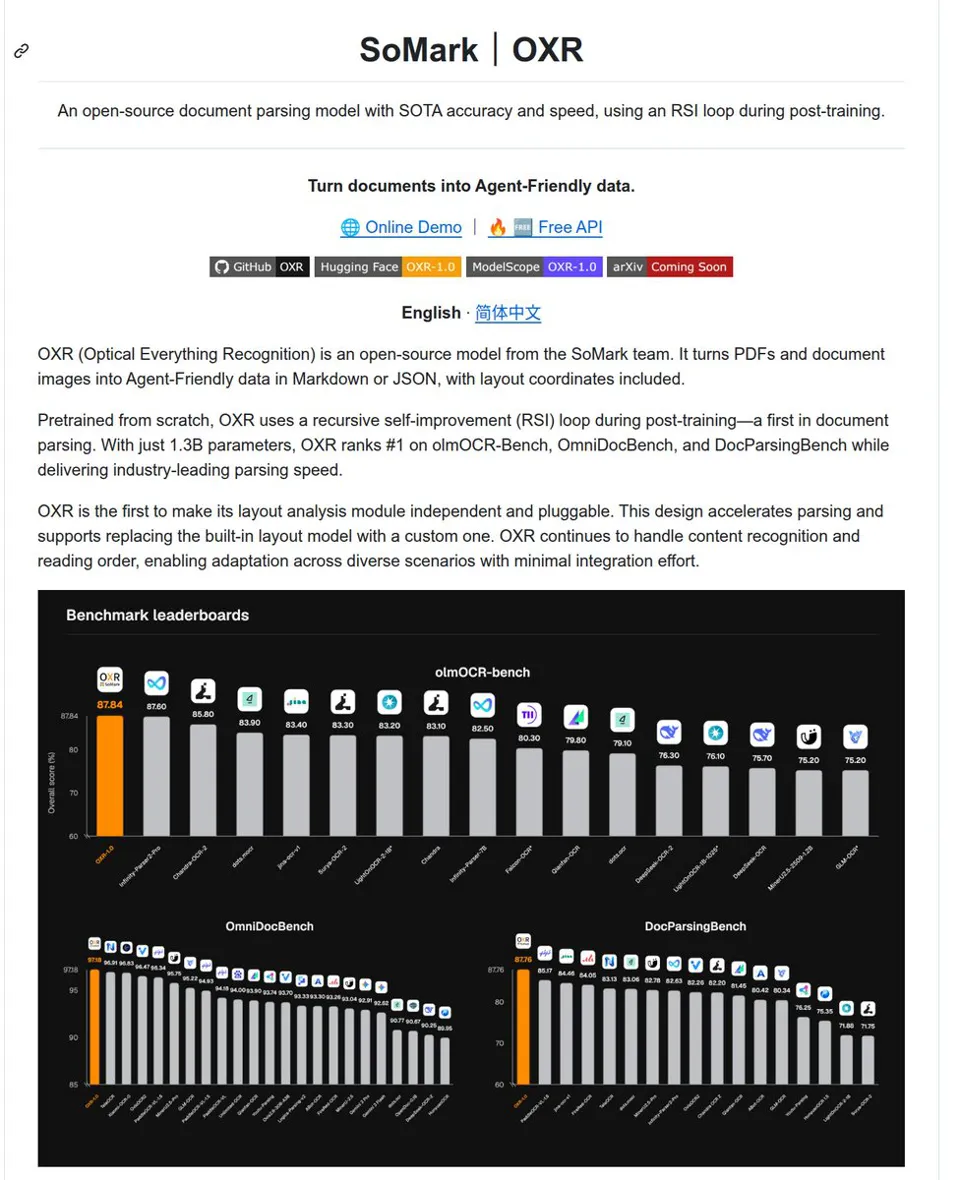
OXR 推出仅 1.3B 参数的开源文档解析模型,首次在 OCR 领域应用递归自我改进(RSI)技术。该模型通过 VLM 评估输出、聚类失败原因并指导数据生成来优化训练,在 olmOCR-Bench 等三大基准测试中排名第一,且在单卡 RTX PRO 6000 上实现 GLM-OCR 3.05 倍的吞吐量。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-20 19
OXR 将解析失败纳入训练流程。
在后训练阶段(OXR 是首个在此环节采用 RSI 的文档解析器),VLM 会评估其输出,rollout 中的分歧用于标记不确定性,并由一个独立的聚类模型对成因进行分组;
这些发现随后指导下一轮定向数据生成。由此产出的 1.3B 参数模型在 olmOCR-Bench、OmniDocBench 和 DocParsingBench 上均排名第一,同时在单张 RTX PRO 6000 显卡上的吞吐量达到 GLM-OCR 的 3.05 倍,创下速度对比中开源模型的最快纪录。
值得深入研究(GitHub 链接见评论)
↳ 引用 @somarkai (SoMark): 超越 OCR。遇见 OXR。 仅 1.3B 参数。开源。
#1 on olmOCR-Bench, OmniDocBench & DocParsingBench🏆 #1 in parsing speed among open-source models⚡
由 RSI 驱动。文档解析领域的首创。 将文档转化为 Agent-Friendly 数据。
如果 OXR 对你有帮助,请在 GitHub 上给我们点个星!🌟