e-means 让 k-means 提速 45 倍且损失更低
Meta 与 École Polytechnique 等机构研究者提出 e-means,在同等或更低测试损失下仅需 1.2 至 3 个 epoch 即可达到 Lloyd 算法 25 个 epoch 的效果。端到端实测在 GPU 上相对 Flash-KMeans 实现 10 至 45 倍加速,CPU 上相对 Faiss 提速 8 至 15 倍,同时打破 k-means 中速度与质量此消彼长的传统权衡。
报道正文
本文目录10 个章节
少一个数量级的迭代轮数
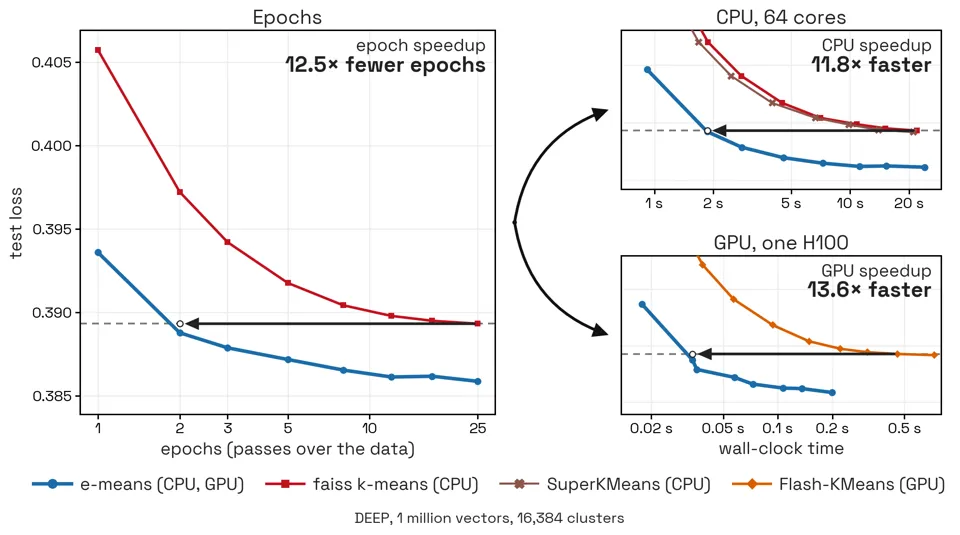
在大量不同的规模和数据集上,e-means 在 1.2 到 3 个 epoch 内就能达到 Lloyd 算法在 25 个 epoch 时的测试损失。端到端测量,在 GPU 上相比最先进的 Lloyd 实现(Flash-KMeans[2])实现了 10–45 倍的墙钟时间缩减,在 CPU 上相比 Faiss[1] 实现了 8–15 倍的缩减。在 k-means 中,速度和通常质量往往相互权衡,而 e-means 同时实现了更好的速度和损失。
k-means 问题
给定一个包含 n 个点的固定数据集 X = {x1, ..., xn} ⊂ Rd 和一个整数 k,k-means 问题是找到 k 个质心 C = (c1, ..., ck),最小化每个点到其最近质心的均方距离:
[ \mathrm{MSE}(X, C) = \frac{1}{n} \sum_{i=1}^{n} |x_i - c_{a(i)}|^2, \qquad a(i) = \arg\min_{j \in {1,\dots,k}} |x_i - c_j|^2 ] [ \mathrm{MSE}(X, C) = \frac{1}{n} \sum_{i=1}^{n} |x_i - c_{a(i)}|^2 ] [ a(i) = \arg\min_{j \in {1,\dots,k}} |x_i - c_j|^2 ]
这是一个静态数据集,不同于 VQ-VAE 内部的码本学习,后者的待聚类分布是不断变化的。
e-means 项目
e-means 的目标是为 k-means 问题提供一种现代优化规则。我们从这个项目起步于以下观察:
- k-means 是机器学习中少数仍然广泛使用全批量优化的问之一。
- 文献中存在小批量 k-means 方法[3],[4],[5],但大多基于 1967 年发布的 MacQueen 更新规则。
- 现代深度学习提供了可以增强小批量方法的优化工具。
对于 e-means,我们选择使用指数移动平均进行小批量更新[6],我们发现这对于 k-means 问题最为高效。与以往的小批量方法不同,e-means 无需超参数调优,因为它通过缩放定律自动设置批量大小和步长(参见使用缩放定律的自动超参数调优)。此外,e-means 改进了初始化与死簇复活策略,加入了余弦调度的衰减率,并引入了一个收尾阶段,在训练结束时以可忽略的运行时开销降低训练损失。e-means 具有高度可并行性,并附带专用内核,将其算法优势转化为实际运行时间的加速。
移动平均更新
每个小批量都会更新每个簇的计数和总和。质心是二者的比值。
无需超参数调优
一切均由缩放定律推导而来。
起始与收尾
新颖的初始化与收尾方法。运行结束时落在每个簇精确的最后一个 epoch 均值上。
余弦调度
步长 α 从 α0 退火至 0.1α0,如同学习率一样。
死簇复活
大小低于阈值的簇通过拆分一个大簇来复活。
专用内核
GPU 内核融合了最近质心分配,将上述 epoch 节省转化为相应的实际运行时间加速。
质心更新规则
质心更新规则是 e-means 的核心组件。本节旨在概述 k-means 聚类的更新规则。所有方法都为每个簇 j 维护分配给它的点的总和 Sj 和计数 Nj,并以二者的比值作为质心:
[ c_j = S_j / N_j ]
它们仅在 Sj 和 Nj 的更新方式上有所不同。下文中的 sj 和 nj 表示当前批次中分配给簇 j 的点的总和与计数(若没有则为零)。
Lloyd 算法[7]将每个点分配给其最近的质心,并从头重新计算统计量,使用完整数据集作为批次:
[ S_j \leftarrow s_j, \qquad\quad N_j \leftarrow n_j ]
因此 cj 是当前分配给它的点的精确均值。每次更新需要对数据做一次完整遍历,该过程重复固定次数(通常为 20 到 50 次迭代)。
MacQueen 更新[3] 会累积统计量,且从不丢弃它们:
[ S_j \leftarrow S_j + s_j, \qquad\quad N_j \leftarrow N_j + n_j ]
因此,cj 是自训练开始以来分配给簇 j 的每个点的均匀均值,包括在早期可能较差的质心位置下分配的点。后来,Staleness-Reduction Mini-Batch K-Means[8] 部分解决了这个问题,它是一种介于 k-means 和 MacQueen 之间的混合方法。他们获得了显著的加速,但仅在非常少的簇数量上。
e-means 在小批量上工作,并用指数移动平均替代了这种求和:
[ S_j \leftarrow (1-\alpha),S_j + \alpha, s_j, \qquad\quad N_j \leftarrow (1-\alpha),N_j + \alpha, n_j ] [ S_j \leftarrow (1-\alpha),S_j + \alpha, s_j ] [ N_j \leftarrow (1-\alpha),N_j + \alpha, n_j ]
因此,较旧的分配会以速率 α 被遗忘,质心跟踪的是最近的分配,而不是整个历史。这种更新规则通常用于移动分布,因此被采用于训练 VQ-VAEs[6]。我们发现,如果将其与 e-means 的其他组件结合,并且超参数得到适当调整,那么它对于静态数据集也极其高效。
e-means 更好地逃离局部最小值
为了更好地理解为什么 e-means 在收敛时比 Lloyd 达到更好的损失,我们在玩具数据集上绘制了几次训练,以评估它们逃离局部最小值的能力。在 200 个种子上重复训练,我们发现与 Lloyd 相比,e-means 陷入病态配置的可能性要小得多。
Lloyd(全批量)e-means(256 的小批量)训练 MSE 两个大小差异很大的团块,k = 8。Lloyd 将两个质心放在小团块上,导致大团块分配不足。e-means 从相同的陷阱开始,并在最初的几个 epoch 内摆脱它,最终在大团块上放置七个质心,在小团块上放置一个。在 200 次启动中,Lloyd 在 26% 的启动中保持卡住,而 e-means 在 3.5% 的情况下保持卡住。Lloyd(全批量)e-means(256 的小批量)训练 MSE 3×3 网格中的九个团块,角部更重,k = 10。Lloyd 让中心团块没有质心,并将三个质心挤入一个角落。e-means 陷入相同的排列,然后在第 10 个 epoch 左右爬出。在 200 次启动中,Lloyd 在 43% 的启动中保持卡住且差于 1% 以上,而 e-means 在 4% 的情况下差于 1% 以上。Lloyd(全批量)e-means(256 的小批量)训练 MSE 四个团块位于一个正方形上,围绕一个更重的中心团块,k = 5。Lloyd 将两个质心放在一个角落团块上,并将一个质心搁置在另外两个团块之间的间隙中,然后这两个团块共享它。e-means 从相同的起点开始,为每个团块分配一个质心。在 200 次启动中,Lloyd 在 15.5% 的启动中保持卡住,而 e-means 保持卡住的比例为 0%。Lloyd(全批量)e-means(256 的小批量)训练 MSE 五个团块在一条线上,k = 5。Lloyd 让一个较轻的中间团块没有质心,并给一个端部团块分配两个质心。e-means 从相同的起点开始,为每个团块分配一个质心。在 200 次启动中,Lloyd 在 46% 的启动中保持卡住,而 e-means 保持卡住的比例为 0%。
我们对此的解释是,小批量提供了更多噪声更新,更有可能探索优化景观并逃离局部最小值。Lloyd 的损失始终递减,更有可能利用已找到的局部最小值并且永远不会逃离它们。
使用缩放定律进行自动超参数调优
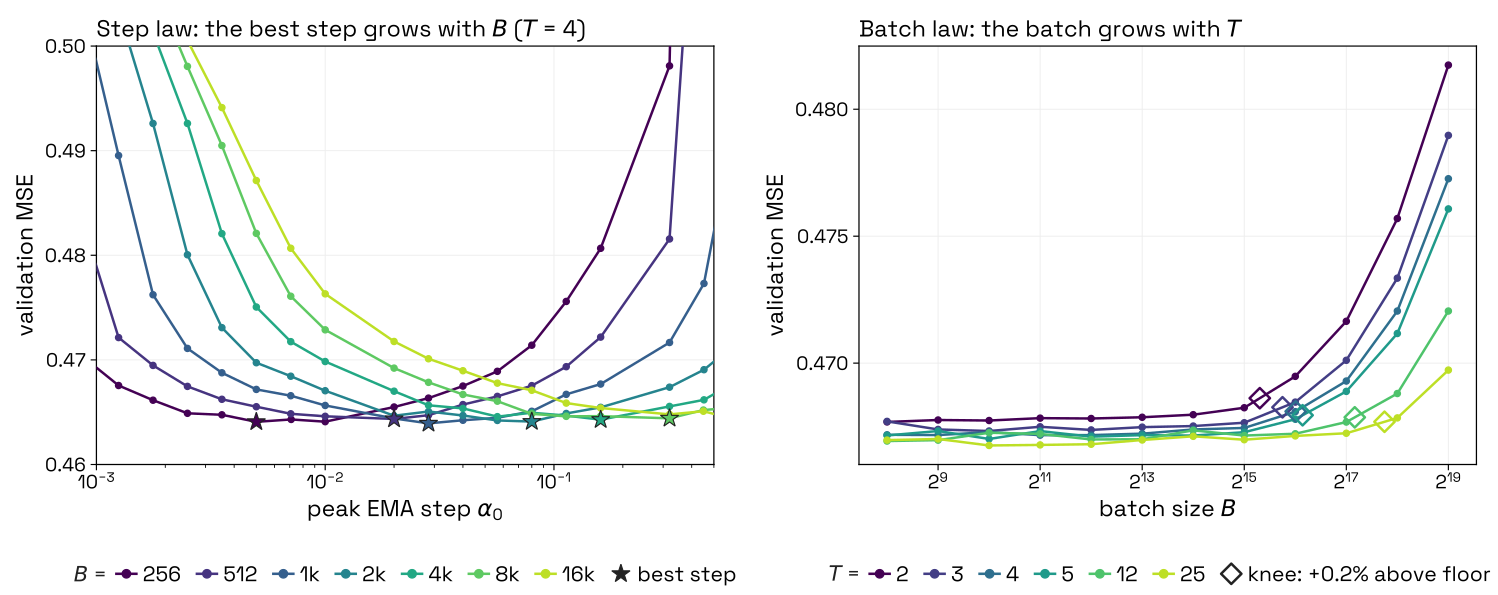
e-means 的一个基本特性是,与 Lloyd 算法相比,从业者不需要设置任何额外的超参数。我们拟合了两个缩放定律,以根据任何问题的特征 (n, k, T) 设置批量大小 B 和步长 α0,并发现它们在未见过的数据集和问题规模上表现出强大的泛化能力。
[ B = c_B , k^{b_k} , n^{b_n} , T^{b_T} ] [ \alpha_0 = \min!\Big(c_\alpha , k^{a_k} , B^{a_B} , n^{a_n} , T^{a_T},; 1\Big) ]
| 定律 | 常数 | 指数项 | 遗憾值,留出数据集 | 遗憾值,留出规模 | R² |
|---|---|---|---|---|---|
| k | B | n | T | ||
| 步长 α0 | 0.824 | −0.46 | 0.90 | −0.45 | −0.11 |
| 批量 B,默认 | 0.035 | 0.13 | 不适用 | 0.88 | 0.81 |
| 批量 B,质量定律 | 0.0044 | 0.13 | 不适用 | 0.88 | 0.81 |
Regret =(使用该定律的 MSE − 网格上的最佳 MSE)/ 最佳 MSE,取各配置的中位数。留出数据集:SIFT、SPACEV,以及 VIBE[9] 数据集 arXiv 和 AG-News。留出规模:从拟合中留出一个 n 值并进行预测。
我们提出两个方程来选择批次,即默认定律和质量定律。“质量定律”以吞吐量为代价,换取更好的聚类质量,相较“默认”定律而言。下面我们绘制了缩放定律的训练数据:验证 MSE 随步长 α0(左)和批次大小 B(右)的变化。
死簇复活的重要性
死簇复活关闭:0 / 25 死簇复活开启(e-means):0 / 25 质心死簇(无点)簇边界 epoch:0.00 · 更新 0 / 157
展示死簇复活重要性的玩具示例。
小批量 k-means 的主要问题是它容易产生“死”簇,即在优化过程中最终分配到零个点的质心。这会减小码本的有效大小,而对于当今越来越多使用的大码本而言,这一问题尤为严重。
一种常见的缓解方法是重新初始化低于某个大小阈值的簇,如 EnCodec[10] 中所做的那样,其中死质心直接被从传入批次中抽取的随机样本替换。虽然这有所帮助,但并未完全解决问题。我们不是从批次中采样任意点,而是通过分裂已有的大簇来复活死簇:我们按大小成比例的概率采样一个活跃簇,并将其分裂为两个。我们发现,这种改编自 Faiss k-means 的方法在消除死簇和保留码本容量方面显著更为有效。
| dataset | revival policy | dead clusters | of codebook | imbalance | test MSE |
|---|---|---|---|---|---|
| DEEP | proportional split | 47 | 0.3% | 1.194 | 0.38762 |
| resample from batch (EnCodec) | 2,343 | 14.3% | 1.423 | 0.39124 | |
| off | 4,313 | 26.3% | 1.647 | 0.39448 | |
| SIFT | proportional split | 10 | 0.1% | 1.186 | 0.19623 |
| resample from batch (EnCodec) | 750 | 4.6% | 1.233 | 0.19684 | |
| off | 2,080 | 12.7% | 1.404 | 0.19797 |
100 万个向量,k = 16,384,5 个 epoch,对 5 个随机种子取平均;只有 revival 策略发生变化。当一个聚类在结束时被分配的向量少于十个(即平均聚类大小的千分之一),该聚类就被视为死亡。不均衡度:聚类大小的不均匀程度(1 = 全部相等)。摘自论文的 revival 消融表。
广泛的实验验证
我们在 24 个不同的嵌入和合成数据集及配置上验证了 e-means(见论文)。为制作视频,我们运行了 234 种 e-means 与 k-means 的对比配置(16 个数据集,10 万到 1 亿个点):在结果地图中探索每一条曲线。
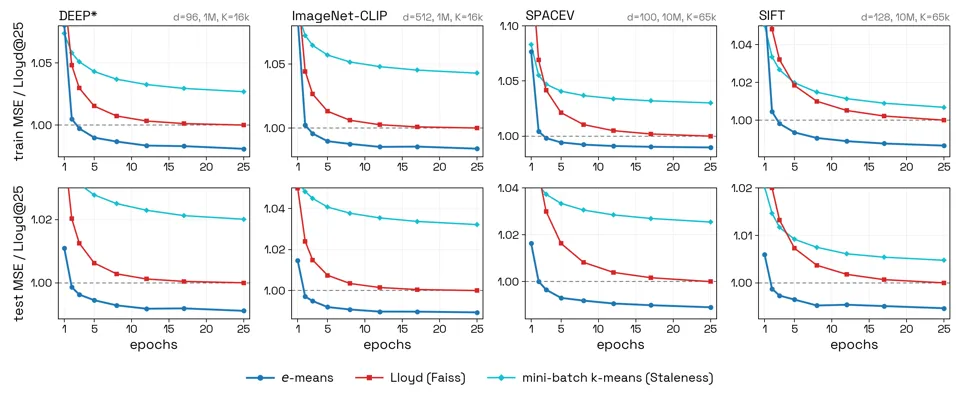
训练(上)和测试(下)MSE,除以 25 个 epoch 后 Lloyd 的对应值。从随机向量初始化。
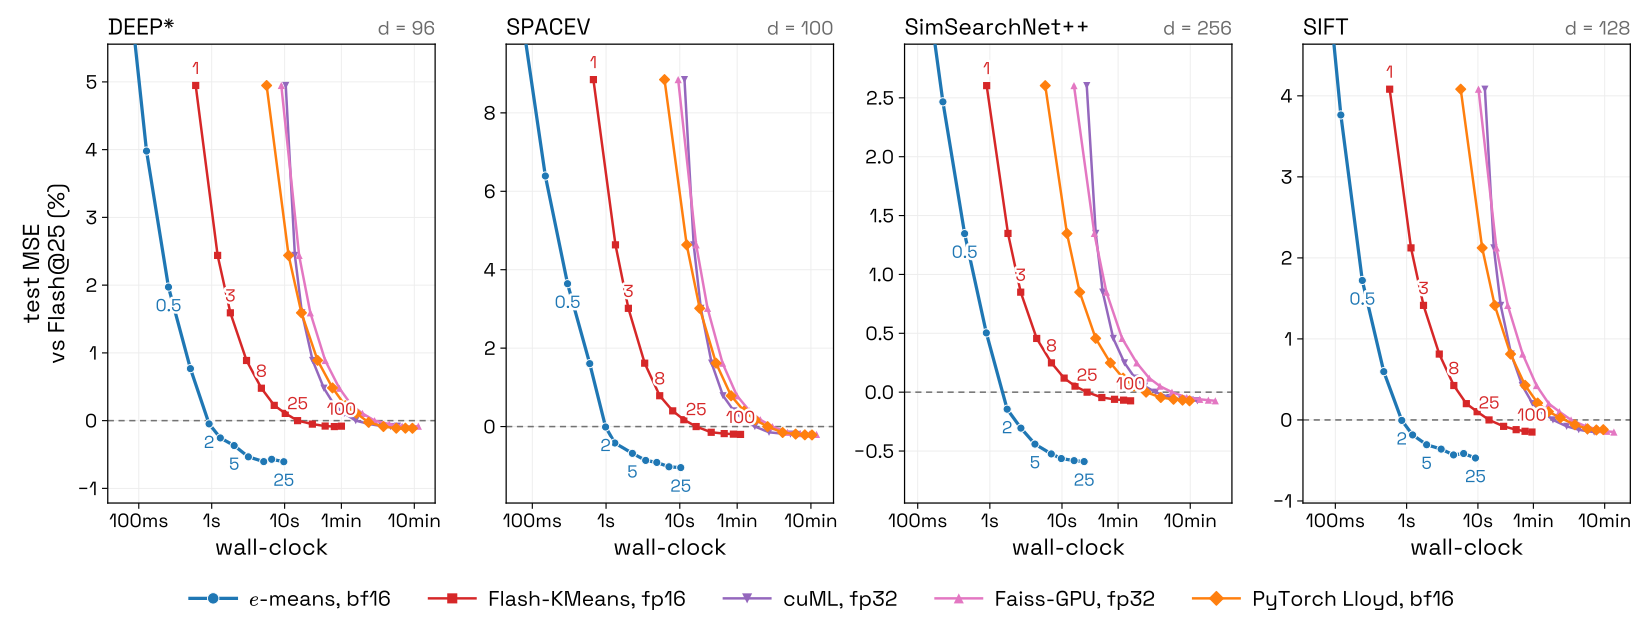
单块 H100 上测试 MSE 随实际耗时变化,1000 万个向量,65,536 个聚类。普通 PyTorch Lloyd(数据在 GPU 上,bf16)的 25 个 epoch 需要 142 到 155 秒,而 Flash-KMeans[2] 只需 14 到 22 秒。曲线上的标签标明了 epoch 数。
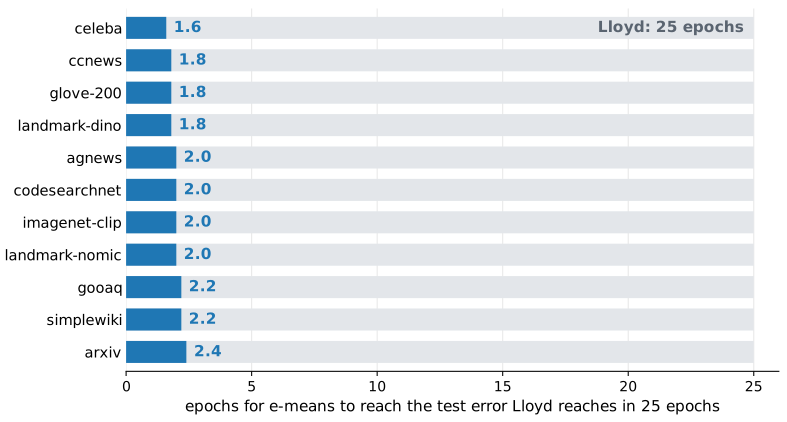
在 VIBE 嵌入基准的 11 个数据集(文本、代码、图像和多模态嵌入,d = 200 到 3,072,k = 8,192 或 16,384)上,e-means 达到 Lloyd 在 25 个 epoch 时达到的测试误差所需的 epoch 数。预算间隔为 0.2 个 epoch,对五个随机种子取中位数。每个数据集需要 1.6 到 2.4 个 epoch,而 Lloyd 需要 25 个。
库与代码
from faiss.contrib.e_means import Emeans # NumpyEmeans for NumPy em = Emeans(d, k, nepochs=T) # T epochs (5 by default) centroids, labels = em.train(x) # x: a PyTorch tensor (n, d) # labels: each vector's cluster in the last epoch
引用本工作
如果您使用 e-means,请引用该论文(arXiv.09501):
@misc{bessa2026emeansoutperformingkmeansin, title={e-means:以十分之一的 epoch 数超越 k-means}, author={Swann Bessa and Pierre-Emmanuel Mazaré and Gergely Szilvasy and Hugo Touvron and David Picard and Matthijs Douze and Hervé Jégou}, year={2026}, eprint={2611.09501}, archivePrefix={arXiv}, primaryClass={cs.LG}, url={https://arxiv.org/abs/2611.09501}, }