qwenGPU 项目发布:在 Qwen3.5-2B 权重中编译 SIMT GPU
开发者推出 qwenGPU,将 45 层未训练的 SIMT GPU 架构直接编译进 Qwen3.5-2B 模型权重中。该项目利用 Gated DeltaNet 状态作为显存,实现了模型内部运行真实 CUDA 指令的能力,并在 Tesla T4 上验证了内核匹配度。尽管推理速度较慢且存在文本漂移,但这一实验展示了大模型权重作为通用计算载体的可能性。
报道正文
▲ Marktechpost AI · 2026-11-02 07
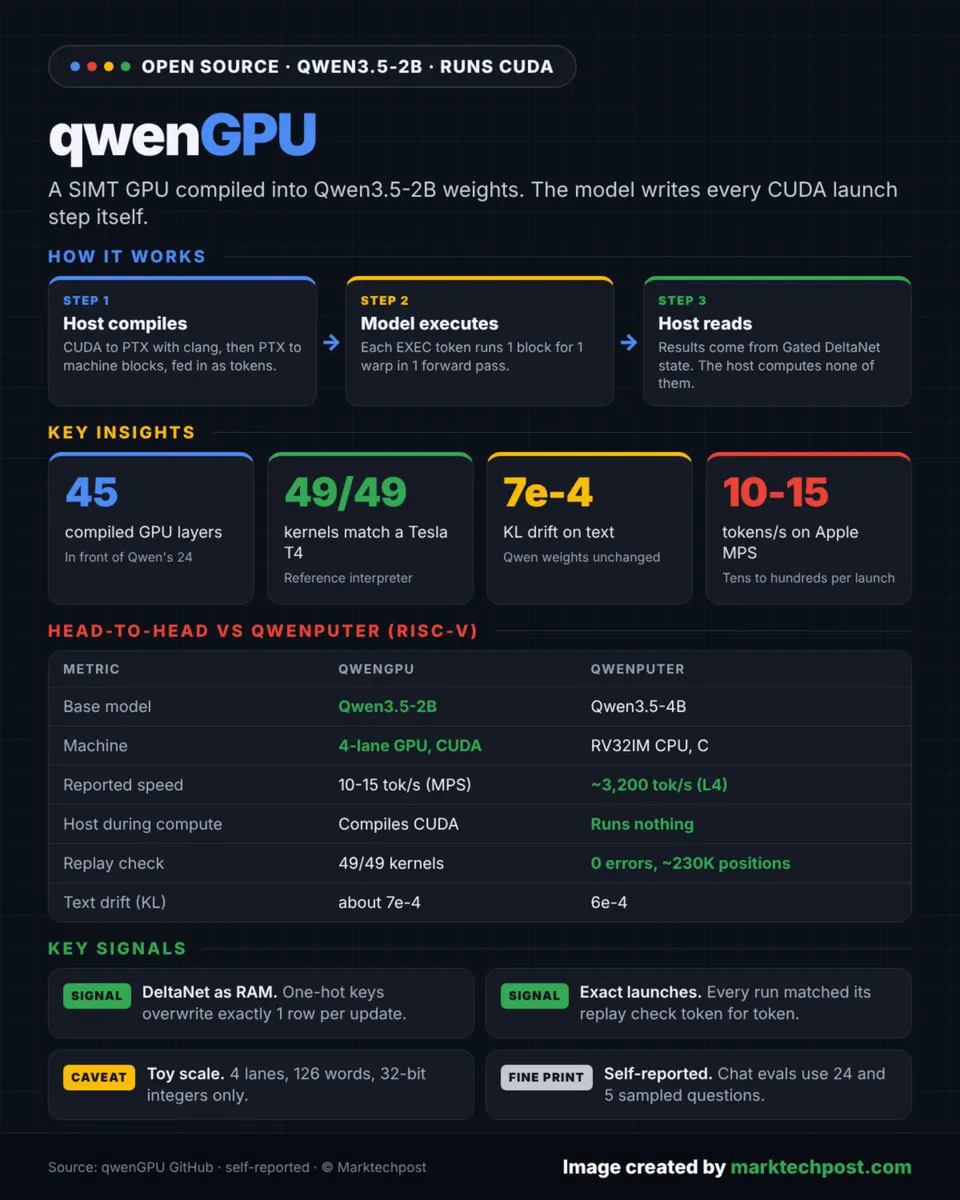
▲ [令人印象深刻的个人项目] 认识 qwenGPU:拥有 45 个编译 GPU 层并运行 CUDA 的 Qwen3.5-2B。qwenGPU 是一个直接编译进 Qwen3.5-2B 权重中的 SIMT GPU。该模型在其自身的前向传播过程中运行真实的 CUDA。
核心思想是复用 Qwen3.5 的门控 DeltaNet(Gated DeltaNet)状态作为 GPU 内存。当门保持开启、写入强度为 1 且使用独热键(one-hot keys)时,每次更新恰好覆盖 1 行。寄存器、程序 ROM 和全局内存都存在于这些行中。
该 GPU 位于 Qwen 的 24 层之前,由 45 个未训练层组成:包含 4 个通道(lanes)、一个 4 级流水线、每个通道 15 个寄存器以及 126 个字的内存。参考解释器在 49 个内核中有 49 个与真实的 Tesla T4 匹配,文本漂移保持在约 7e-4 的 KL 散度水平。但这是一种权衡:它在 Apple MPS 上以每秒约 10 到 15 个 token 的速度运行,且由 Qwen 编写的 CUDA 代码在 5 次尝试中有 4 次是正确的。
代码采用 MIT 许可证,你需要自行构建检查点,大约需要 16 GB 的空闲内存。它基于 Qwenputer,后者将 RISC-V CPU 内置于 Qwen3.5-4B 中……
完整分析: