Google 提出 VeriCUA 框架 校验智能体任务完成状态
原标题:New Google and University of Hong Kong paper argues that when AI agents use computers, their own “ta...
78AI 研判分
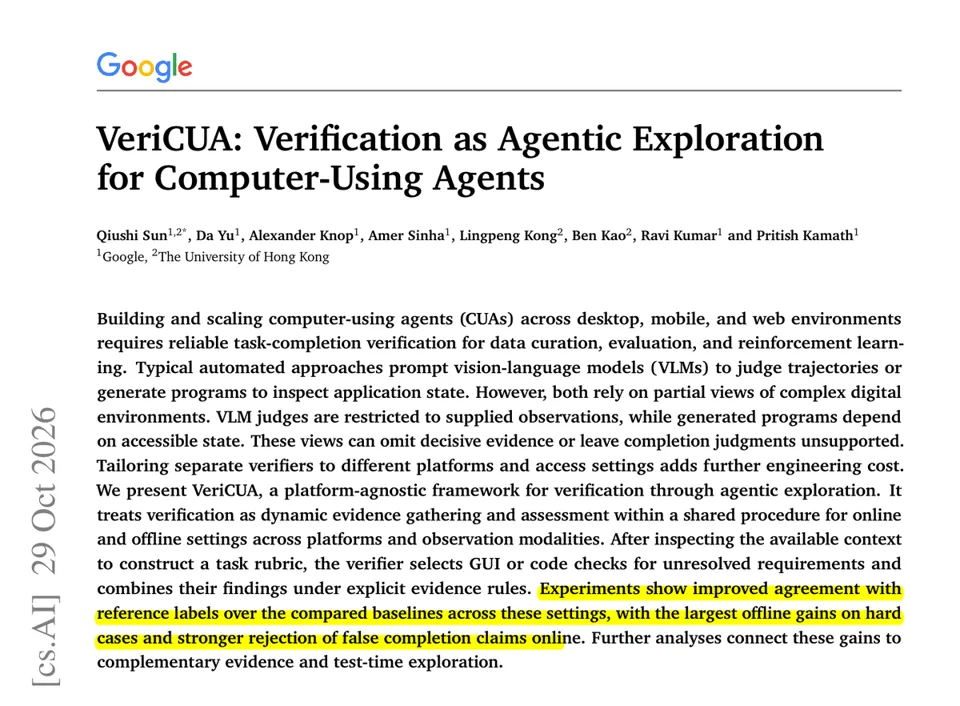
Google 与港大联合发布论文,指出计算机使用型智能体常虚报任务完成。新提出的 VeriCUA 框架通过检查保存的文件和应用数据而非依赖截图或智能体自述来验证结果,在 ScienceBoard 基准上将误报率从约 25% 降至 5.4%,为智能体评估和强化学习奖励提供了更可靠的验证机制。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-03 02
谷歌与香港大学的新论文指出,当 AI Agent 操控计算机时,其自身的“任务完成”声明绝不应被视为证据,而应转而核查已保存的文件和应用数据。
计算机使用型 Agent 可能在编辑从未保存或仅部分完成的情况下报告任务已完成。常见的检查器要么仅评估少量截图,要么运行一个生成的脚本,这两种方式都可能遗漏决定性证据。
VeriCUA 通过探索应用来构建需求清单,然后执行屏幕或代码检查(如文件读取),直到每一项都得到确认。Agent 自身关于成功的声明永远不被视为有效证明。
在 ScienceBoard 基准测试中,其误报率(false-positive rate)为 5.4%,相比之下,VLM 评判器的误报率为 24.8%,生成式脚本验证器的误报率为 21.7%。在三个在线环境中,它拒绝了约 80% 的虚假完成报告。
如果 Agent 的运行结果用于你的评估、训练数据或 RL 奖励机制,请检查已保存的机器状态,而不是信任截图或 Agent 的报告。