InfoQ 中文 · 2026/10/21 11:35:05
Cloudflare 构建 LLM 黑盒测试框架 评估 WAF 防御能力
Cloudflare 开发了一套基于 Python 的测试框架,利用大语言模型(LLM)动态生成并迭代 Web 攻击变体,以黑盒方式评估其 WAF 防御能力。在 45 个场景中,系统通过反馈循环调整载荷编码与交付方式,最终产出 49 项有效发现并驱动三项托管规则更新,展示了 AI 在安全测试中的结构化应用潜力。
报道全文原始报道全文
Cloudflare 构建黑盒测试框架,利用 LLM 动态生成并迭代 Web 攻击变体,以评估 WAF 防御能力;45 个场景中产出 49 项有效发现,驱动三项托管规则更新。
模型仅基于 WAF 响应反馈调整载荷编码、位置与交付方式,不接触规则或源码;Python 框架负责请求编排与状态管理,模型仅提供建议与响应分析;SSRF 测试中通过地址表示形式微调触发重定向,暴露检测盲区。
适合安全工程师、WAF 规则开发者、AI 安全测试架构师阅读。
Cloudflare 将前沿 AI 模型置于一个受控测试框架中,用于探测其 Web 应用防火墙(WAF),并以遭到拦截的攻击为起点,让模型生成和改进新的变体。
在 45 个场景中,该系统生成了 1,107 次尝试,经过人工筛选后留下了 49 项发现。这项测试最终促成了 Cloudflare 托管规则集的三项变更。
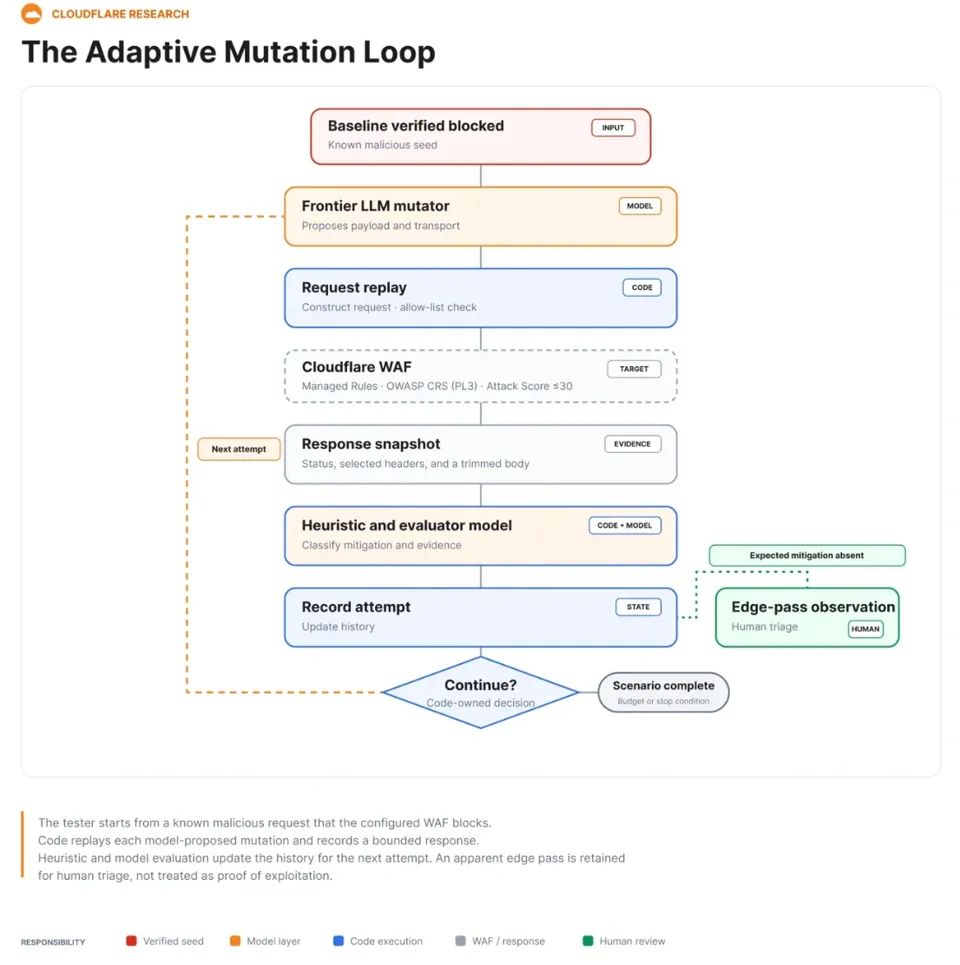
实验从 WAF 已经拦截的攻击载荷开始。模型并非反复重放固定测试用例,而是根据此前尝试得到的响应,提出对编码方式、载荷位置或交付方式的修改。模型无法访问 Cloudflare 的 WAF 规则、源代码或内部安全信号,因此从模型的角度来看,这实际上是一场黑盒测试。
Cloudflare 不希望交给模型处理的部分由一个 Python 测试框架负责。它负责构造和重放 HTTP 请求、维护场景状态、实施限制并收集响应。一次模型调用负责提出下一个变体,另一次模型调用则审查由此产生的响应,使后续尝试能够动态调整,同时又不让模型直接控制请求的执行。
一项 SSRF 测试展示了这种反馈循环的工作方式。测试器不断改变某个云元数据地址的表示方式和出现位置,尝试了十进制、八进制及其他形式。最终,一个使用十进制表示方式的请求遭到拦截。在下一次尝试中,模型保留了相同的请求结构,但将该地址改为末尾带点的表示形式;这一次,客户端遇到的是重定向,而不是 WAF 拦截。Cloudflare 保留了这一结果以供调查,而没有将其视为攻击已经成功的证据。
这种区分在大规模测试中被证明非常重要。在记录的 1,107 次变体尝试中,有 607 次形成了经过筛选后的结果集:其中 558 个请求被 WAF 拦截,49 项发现被认为与进一步的修复工作相关。49 项发现中有 48 项涉及命令注入或服务端请求伪造(SSRF)。
人工审查仍是最终的验证环节。审查人员会检查请求是否真正到达目标、是否仍具有恶意性、是否明确未被拦截、是否属于 WAF 的职责范围,以及能否安全复现。保留下来的案例随后会被重新执行,并作为修改规则、规范化处理或其他缓解措施的候选项进行评估。
这项工作促成了 Cloudflare 托管规则集的三项变更:新增两项检测规则 SSRF - Obfuscated Host 和 SSRF - Restricted Protocol,并改进了现有的 SSRF - Cloud 规则。
相同的测试框架模式也出现在其他安全工程实践中。Cloudflare 的漏洞发现测试框架将漏洞发现与独立验证分离,而 Google Mandiant 的智能体漏洞发现测试框架,则让多个专业智能体依次完成源代码分析、假设生成和验证,之后才将发现交给人工审查人员。
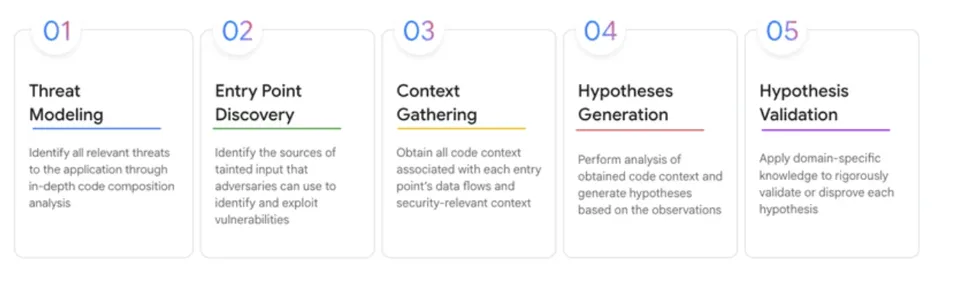
其他系统采用了不同的术语,但遵循类似的发现与验证模式。OpenAI 的 Codex Security 会为代码仓库构建威胁模型、搜索漏洞,并尝试在隔离环境中复现候选漏洞,然后再提出修复方案供人工审查。Google 的 PageBreak 同样侧重于验证 AI 生成的漏洞假设是否确实可以利用,部分目的是避免大量看似合理但未经验证的发现淹没安全团队。
这些系统的共同点是围绕模型构建的测试框架:限制执行、保存状态、验证发现,并将概率性的探索转化为现有安全工作流可以使用的证据。
原文链接:https://www.infoq.com/news/2026/10/cloudflare-sec-harness/