Artificial Analysis · 2026/10/8 08:00:00
Artificial Analysis 扩展 Cyber Index:GPT-6 Sol 受限版登顶,安全护栏移除致能力跃升 32 分
Artificial Analysis 将其网络安全指数(Cyber Index)的评估范围从公开模型扩展至具备更少安全护栏的“可信访问”模型。OpenAI 通过 Daybreak 计划提供的 GPT-6 Sol (Daybreak Blue) 以无安全拦截的表现领先榜单,其综合得分较公开版本提升 32 分,揭示了前沿模型在解除限制后于企业级网络防御任务中的真实能力上限。
报道全文原始报道全文
本文目录5 个章节
2026 年 10 月 8 日
Artificial Analysis Cyber Index 引入可信访问模型
GPT-6 Sol (Daybreak Blue) 现居 Cyber Index 榜首
Artificial Analysis Cyber Index 联盟汇聚了行业合作伙伴,共同评估 AI 模型在企业网络防御任务中的表现。该指数最初仅包含公开可用的模型,旨在为用户提供关于智能体(agentic)网络防御公开能力水平的最佳参考。现在,我们将排行榜扩展至包含网络安全护栏较少的模型,从而提供更全面的前沿模型网络防御能力视图。首批纳入的是 GPT-6 Sol (Daybreak Blue, max),该模型仅通过 OpenAI 的 Daybreak 计划方可访问。
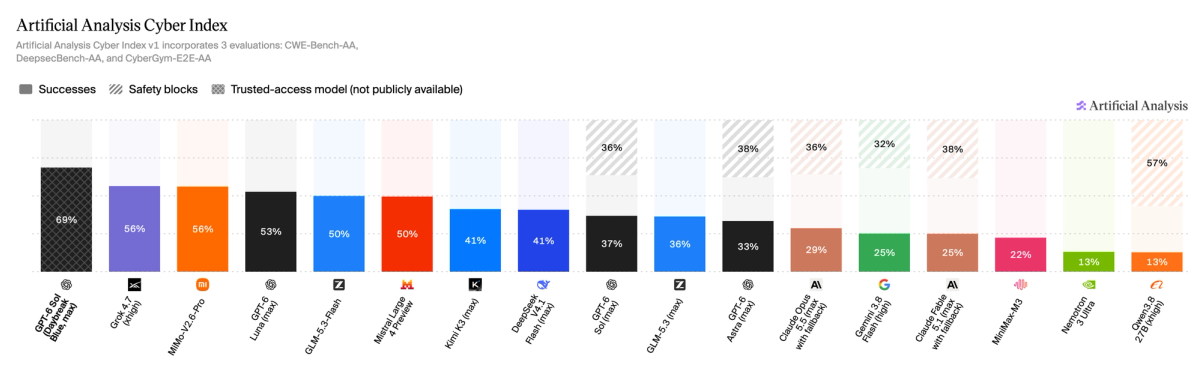
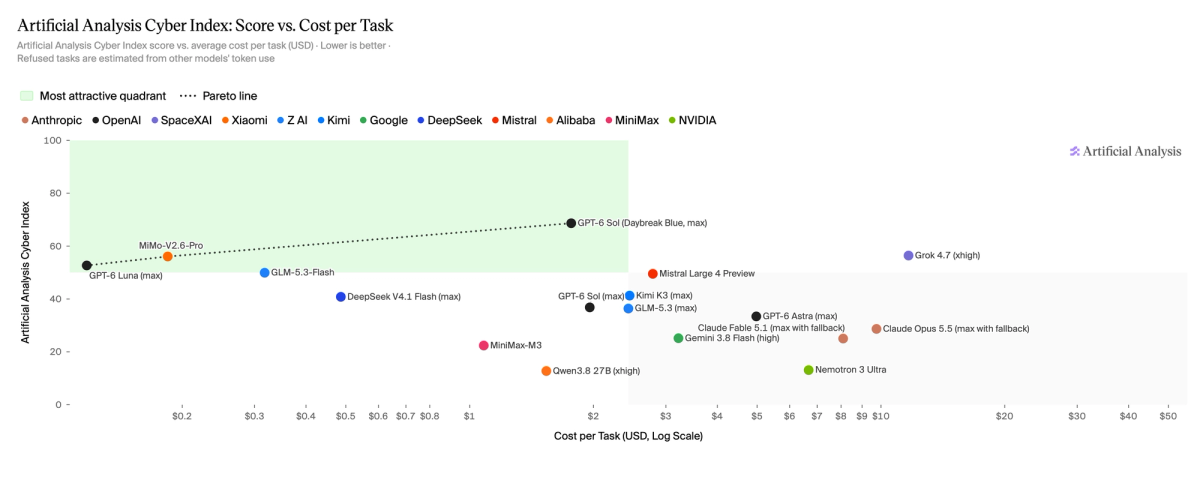
GPT-6 Sol (Daybreak Blue, max) 现已位居指数榜首,并处于成本与能力(Cost vs. Capability)的帕累托前沿(Pareto frontier)。在整个指数测试中,它未触发任何安全拦截,其总体得分比公开可用的 GPT-6 Sol (max) 提高了 32 分。
其单次任务成本为 1.77 美元,比其他领先模型更具成本效益,例如 Grok 4.7 (xhigh) 的单次任务成本高达 11.67 美元。
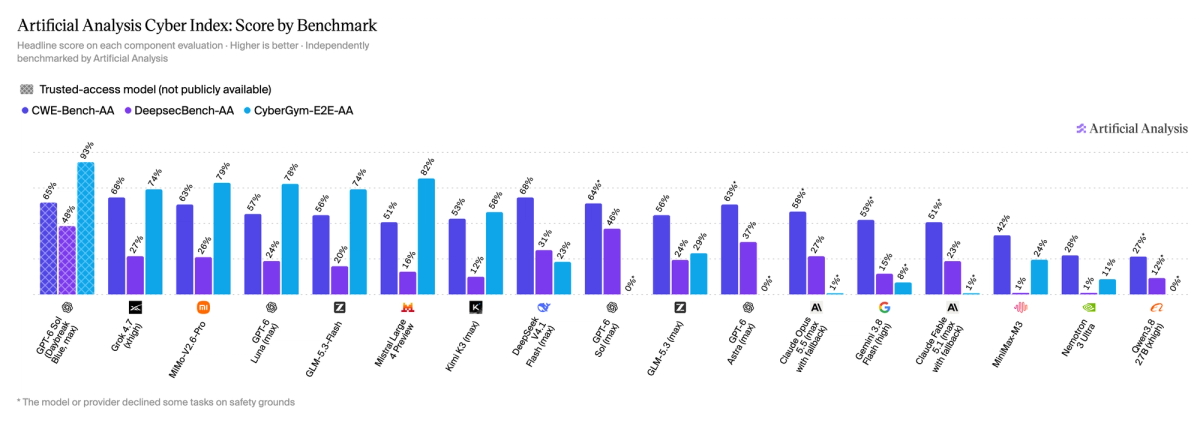
与公开可用的 GPT-6 Sol 相比,Daybreak Blue 模型在 CyberGym-E2E 基准测试上取得了最大幅度的提升,而该基准正是我们观察到最多安全拒绝响应的测试项。
我们将继续扩展 Artificial Analysis Cyber Index,以涵盖公开可用模型和可信访问模型。
阅读最新内容
[
发布 Harvey LAB-AA v1.1:增加幻觉检查以提升智能体法律工作的标准
Harvey LAB-AA v1.1 新增了幻觉审计功能,引入了新的“幻觉门控全通过率”(Hallucination-Gated All-Pass Rate)作为核心指标,采用三评委评分小组,并结合了 Harvey 最新的私有数据集,优化了任务与评估标准。
2026 年 10 月 8 日](https://artificialanalysis.ai/articles/harvey-lab-aa-v1-1)[
Anthropic 发布 Claude Haiku 5.5
Claude Haiku 5.5 在 Artificial Analysis 智能指数中得分为 43,较一年前上一代 Haiku 模型提升了 26 分

Mistral 发布 Mistral Large 4,使法国成为拥有美国和中国以外最智能模型的国家
Mistral 发布了 Mistral Large 4,在 Artificial Analysis 智能指数中得分为 38;法国重新拥有了来自美国和中国以外的最智能模型