哈佛 MIT 研究:禁用 Okay 提升推理模型可控性
原标题:New Harvard and MIT paper finds that reasoning models' poor control over their chain-of-thought part...
78AI 研判分
最新研究发现,推理模型难以遵循思维链指令的主要原因之一是过度依赖以“Okay”开头的生成习惯。通过禁止该起始词并预填充一个合规 Token,模型的平均指令遵循率提升了 34% 至 41%。这一发现表明,思维链监控中的可控性问题需区分“起始词偏差”与“通用控制能力”,为安全对齐提供了新的优化视角。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-03 19
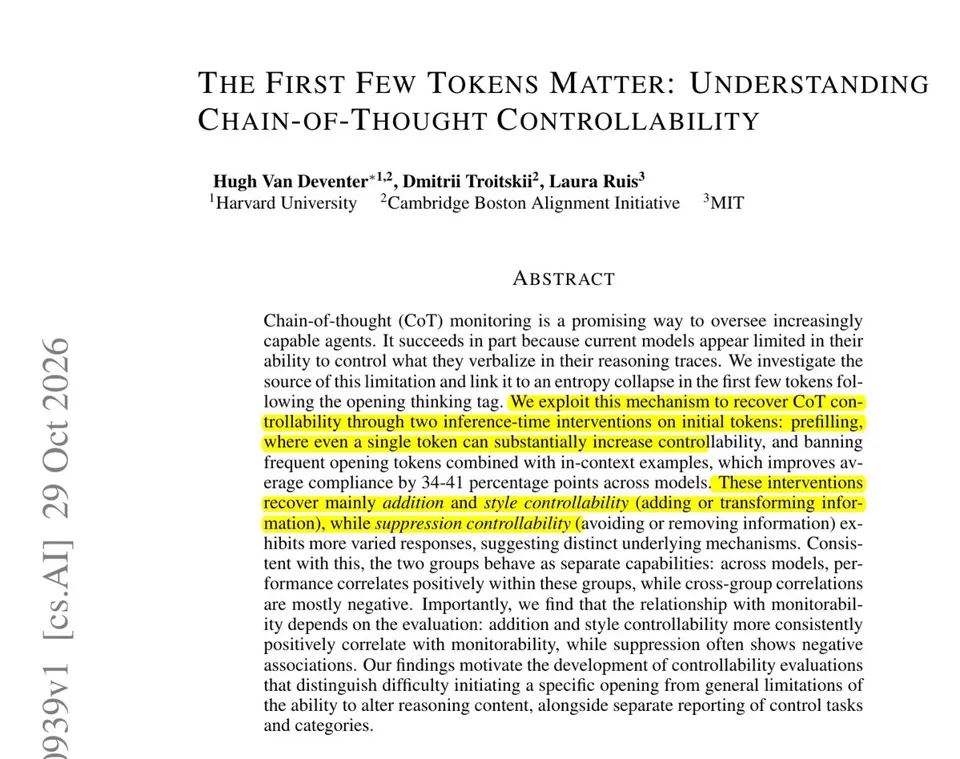
哈佛和 MIT 的最新论文发现,推理模型对思维链(chain-of-thought)控制力不足的部分原因,源于其习惯以“Okay”作为开头。
安全团队通过阅读模型的推理过程来捕捉不当行为,而显示模型无法引导该推理过程的基准测试结果一直令人感到安心。此前,模型为何在此方面失败尚不明确。
作者要求 Qwen3-32B 等模型使用大写字母进行推理或对每个句子编号。Qwen3-32B 和 OLMo-3.1-32B 将约 99% 的首 token 概率分配给了“Okay”,因此作者尝试禁用该词或预填充一个符合要求的 token。
禁用“Okay”和“Alright”并添加一个示例,使平均合规率比仅依靠指令提高了 34 到 41 个百分点。涉及隐藏信息的任务(如避免使用某个单词)响应一致性较差,且在 12 个模型中似乎属于一种独立的技能。
如果你因为可控性评分而信任思维链监控,请将开头词汇问题与一般控制能力区分开来,并单独报告隐藏类任务的结果。