Inception 发布 Mercury 3 扩散语言模型 推理速度提升四至八倍
Inception Labs 推出 Mercury 3,声称在多项基准测试中超越 GPT-6 Luna 和 Claude Haiku 5.5,且推理速度快 4-8 倍。该模型采用扩散架构并行生成文本,但在指令遵循等特定任务上优势显著,整体性能领先幅度较宣传略窄。
报道正文
本文目录3 个章节
Inception 表示,其全新语言模型 Mercury 3 在多项基准测试中超越了 GPT-6 Luna 和 Claude Haiku 5.5,同时运行速度提升了四到八倍。
在其公告中,该公司将 Mercury 3 称为迄今发布的最强大的扩散语言模型。
这种速度优势源于模型的构建方式。GPT 或 Claude 等模型逐词生成文本,因此每个新词都必须等待前一个词完成。扩散模型(Diffusion Models)最广为人知的应用是图像生成:它们首先勾勒出整体答案的粗略版本,然后通过多次迭代进行细化,从而一次性生成多个单词。Google 关于 DiffusionGemma 的技术报告解释了这一基本理念。
Mercury 3 的领先幅度比公告所示更窄
Inception 自家的基准测试表格揭示了更为复杂的情况。在三个模型均设置为中等配置的情况下,Mercury 3 在 12 项测试中赢得了 8 项。其在指令遵循方面的差距最大:在 IFBench 上,Mercury 3 得分为 76.84 分,比 GPT-6 Luna 高出 15 分。在 SWE-Bench Atlas 的自主编码测试中,它也明显领先,得分 51.08 分,而其竞争对手仅分别达到 33.33 分和 32.26 分。
Claude Haiku 5.5 在更长的编码测试 DeepSWE 中胜出,并且在长文本信息检索方面表现更佳。GPT-6 Luna 则在 Artificial Analysis 的两项测试中略占上风。Inception 简短的概述更为谨慎,将 Mercury 3 的质量描述为“持平或更优”。
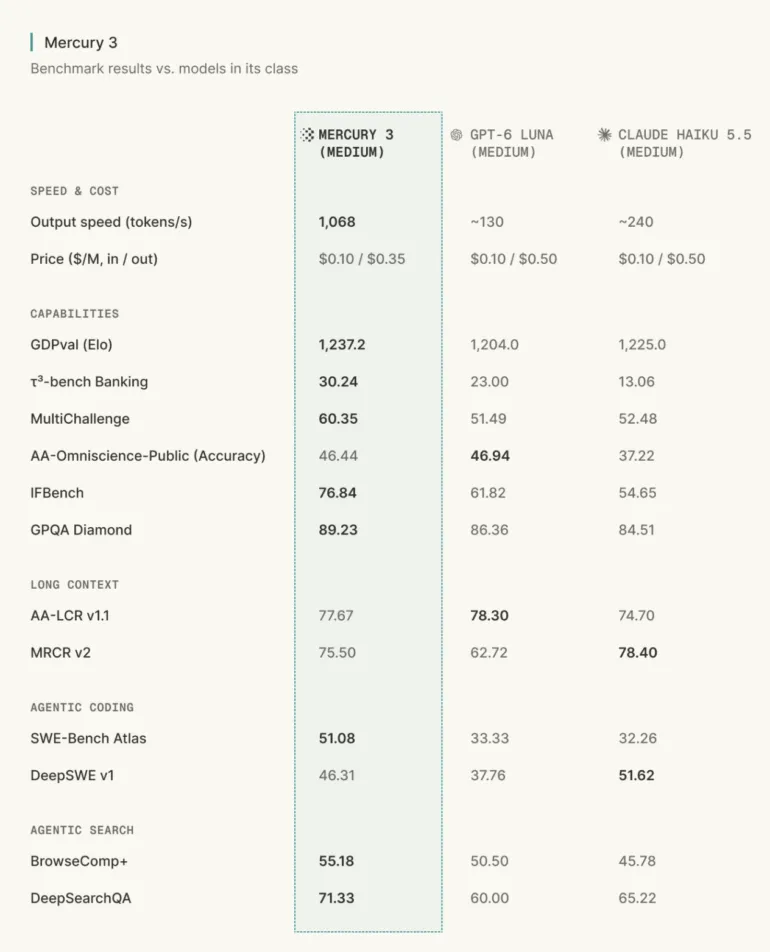
在 Inception 的自家测试中,Mercury 3 在 12 项基准测试中的 8 项领先。| 图片:Inception
据 Inception 称,Mercury 3 在 Nvidia GPU 上的生成速度为每秒 1,068 个 token。在公司的对比数据中,Claude Haiku 5.5 约为每秒 240 个 token,GPT-6 Luna 约为每秒 130 个 token。目前尚无独立第三方测试结果。
Inception 表示,Mercury 3 的参数数量超过 Mercury 1 的 40 倍以上,但运行速度却同样快。自小型的 Mercury 1 mini 以来,性能也提升了两倍。Inception 认为这表明扩散模型能够像标准语言模型一样,随着规模扩大而可靠地提升性能。具体的参数数量尚未披露。
Mercury 3 瞄准微小延迟累积显著的应用场景
Inception 将 Mercury 3 主要定位为适用于 AI Agent、搜索、客户支持和辅导场景的模型。AI Agent 需要通过多个独立步骤来完成任务,并在每一步等待模型的响应。这些微小的延迟会迅速累积。
早期接入合作伙伴在公告中分享了他们的成果,其中大多数也重点关注速度。Octen AI 为智能眼镜构建搜索功能。“在智能眼镜上,如果回答需要五秒钟,用户会觉得系统坏了,”创始人 Kuan Zou 表示。他说,搜索本身仅耗时约 80 毫秒,语言模型才是瓶颈。使用 Mercury 3 后,中位响应时间在 0.9 秒内到达,整个流程耗时 2.2 秒。
教育公司 General Learning 表示,现在它能在大约一秒内向学生提供提示和纠正。客户服务提供商 Lorikeet 报告称,其响应时间更快,且结果更好。在 TinyFish AI,联合创始人 Shuhao Zhang 表示,Mercury 3 在真实网站上被分配了 50 个导航任务。它解决了 25 个,超过了 GPT-6.1-Sol。Zhang 没有给出 OpenAI 模型的具体数字。
Mercury 3 的低启动价格可能不会持续太久
常规定价为每百万输入 token 0.20 美元,每百万输出 token 0.70 美元。Inception 在发布时减半价格。该公司尚未说明折扣何时结束。此后,对于较短的输入(GPT-6 Luna 和 Claude Haiku 5.5 均收费 0.50 美元),Mercury 3 的输出成本将高于这两款竞品。不过,对于非常长的 prompt,两款竞品的收费要高得多。Mercury 3 可以一次性处理多达 100 万个 token。
该模型可在 Inception 自有平台以及 OpenRouter、Baseten 和 Vercel 上使用。它采用与 OpenAI 模型相同的 API,因此 Inception 表示开发者可以轻松切换。
今年二月,Inception 发布了 Mercury 2,称之为首个在回答前通过中间步骤进行推理的扩散模型。在此之前,这家初创公司筹集了 5000 万美元。投资方包括 Nvidia、Microsoft 和 Snowflake 的风险投资部门 NVentures、M12 和 Snowflake Ventures。
Google 也在采用同样的方法。其 Gemini Diffusion 演示之后,6 月又推出了开源模型 DiffusionGemma。Google 表示,该模型的运行速度比标准版 Gemma 4 快至多四倍,但生成的结果略逊一筹。