Kimi K3.1 Pro 发布 逼近 Claude Opus 5.5 性能
月之暗面发布 Kimi K3.1 Pro,在 Artificial Analysis 智能指数中得分 55,较前代提升 11 分并跃居第四。该模型大幅缩小了开源与顶级闭源模型(如 Claude Opus 5.5)的性能差距,若按计划于 11 月开放权重,将成为最强开源模型。
报道正文
本文目录4 个章节
Moonshot AI 的新推理模型 Kimi K3.1 Pro 在 Artificial Analysis 智能指数中位列第四,仅落后于顶级专有模型 3 分。
中国 AI 公司 Moonshot AI 发布了 Kimi K3.1 Pro,这是其前代产品 Kimi K3 的后训练版本,投入了显著更多的后训练算力。该模型在 Artificial Analysis 智能指数 中得分 55 分,较 K3 跃升 11 分,从而跻身第四名。
根据 Artificial Analysis 的数据,仅有 Claude Opus 5.5(58 分)、Claude Sonnet 5.5(56 分)和 Muse Wonder Full(56 分)排名更高。如果 Moonshot 按计划于 2026 年 11 月 4 日开放模型权重,K3.1 Pro 将成为目前得分最高的开源权重模型。假设届时没有其他变化,这将使开源模型与专有模型之间的差距从 12 分缩小至仅 3 分。
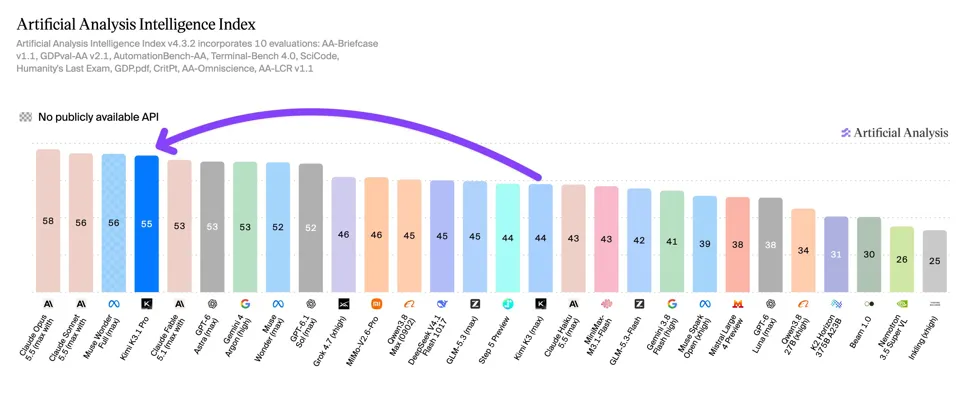
从中游到前四:Kimi K3.1 Pro 在 Artificial Analysis 智能指数上比 Kimi K3 整整提高了 11 分。| 图片:AA
除了 K3.1 Pro,Moonshot 还推出了名为 K3.1 Pro Highspeed 的变体,据该公司称,其运行速度是标准版的两到三倍。这两款模型现已通过 Kimi.ai、Kimi Work、Kimi Code 以及 Kimi API 提供服务。
| 项目 | Kimi-K3.1-Pro | Kimi-K3.1-Pro-Highspeed |
|---|---|---|
| 输入 | $2.00 / MTok | $4.00 / MTok |
| 输出 | $10.00 / MTok | $20.00 / MTok |
| 缓存输入 | $0.20 / MTok | $0.20 / MTok |
智能体任务提升最为显著
K3.1 Pro 最强劲的改进体现在智能体(Agentic)任务上。根据 Artificial Analysis 的数据,在 GDPval-AA 基准测试中,它达到了 1,846 Elo,比 K3 高出 312 分。这使其紧随 Claude Opus 5.5(1,866)和 Muse Wonder Full(1,857)之后。在 Terminal-Bench 4.0 测试中,Moonshot 报告得分为 65.7%,领先于 GPT-6 Astra(58.2%),并略低于 Claude Opus 5.5(66.4%)。而在同一测试中,K3 仅获得了 13% 的分数。
幻觉率也大幅下降。根据该公司称,在 Moonshot 内部的 Kimi Hallu Bench Hard 基准测试中,声明级幻觉率从 K3 的 23.4% 降至 8.3%。Moonshot 表示这是一项压力测试,而非通用错误率的衡量标准。GPT-6 Astra 在同一基准测试中的得分为 5.5%,因此仍具有一定优势。
在内部金融基准测试中,K3.1 Pro 在 Financial Modeling(财务建模)上提升了 7.2 分,在 Financial Research(金融研究)上提升了 11.6 分。对于一般办公任务,据 Moonshot 称,该模型在 OfficeQA Pro v2 上超越了所有受测模型。
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Claude Fable 5.1 | DeepSeek-V4.1-Flash | GLM-5.3 |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 | 57.9 | 42.3 | 41.8 |
| SWE Marathon v1.1 | 51.7 | 46.3 | 42.5 | 45.6 | 40.0 | 42.5 |
| DeepSWE v1.1 | 75.5 | 74.2 | 74.1 | 67.4 | 77.0 | 66.9 |
| BenchCAD (with tools) | 92.7 | 96.2 | 95.9 | 92.6 | 81.6 | -- |
| HLE-Full (with tools) | 70.0 | 67.7 | 57.2 | 65.6 | 58.8 | 62.5 |
| BrowseComp | 92.1 | 90.8 | 91.5 | -- | -- | -- |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | 54.5 | 40.4 | 31.1 |
| Automation Bench-AA | 73.3 | 69.5 | 68.5 | 59.4 | 66.6 | 62.2 |
| GDPval-AA v2.1 (Elo) | 1,846 | 1,866 | 1,573 | 1,754 | 1,746 | 1,650 |
| GPQA-Diamond | 94.2 | 93.9 | 96.1 | 93.7 | 92.2 | 91.7 |
| ExploitBench | 74.7 | 91.0 | 100 | 83.0 | -- | 54.4 |
Moonshot 发布的 Kimi K3.1 Pro 基准测试结果表。所有结果均在推理强度(reasoning effort)设置为“max”的情况下获得。
3D 建模与编程
据 Moonshot 称,K3.1 Pro 可直接与 Unity、Unreal Engine 和 Godot 等游戏引擎协作,既能处理快速修复,也能完成完整的项目构建。在 BenchCAD 基准测试中,启用工具后其得分达到 92.7%,接近 Claude Opus 5.5(96.2%)和 GPT-6 Astra(95.9%)。在不使用工具的情况下,其得分为 72.8%,几乎与 Claude Opus 5.5(73.0%)持平。
Moonshot 表示,该模型在机械零件的参数化建模、建筑模型以及可配置产品方面表现最为强劲。它无需 MCP 连接器即可编写并运行 Blender 和 CAD 软件的脚本。该公司还在 Kimi.com 上推出了一项名为“3D Make”的功能,允许用户预览、编辑和导出 3D 模型。
规模相同,价格更低
K3.1 Pro 保持了与 K3 相同的架构规模,总参数为 2.8 万亿,激活参数为 1040 亿。其上下文窗口支持一百万个 token,且模型能够处理文本和图像。根据 Artificial Analysis 的数据,该模型位于帕累托前沿(Pareto frontier)的顶端。在参数量相当的模型中,没有任何模型在智能指数(Intelligence Index)上的得分高于它。
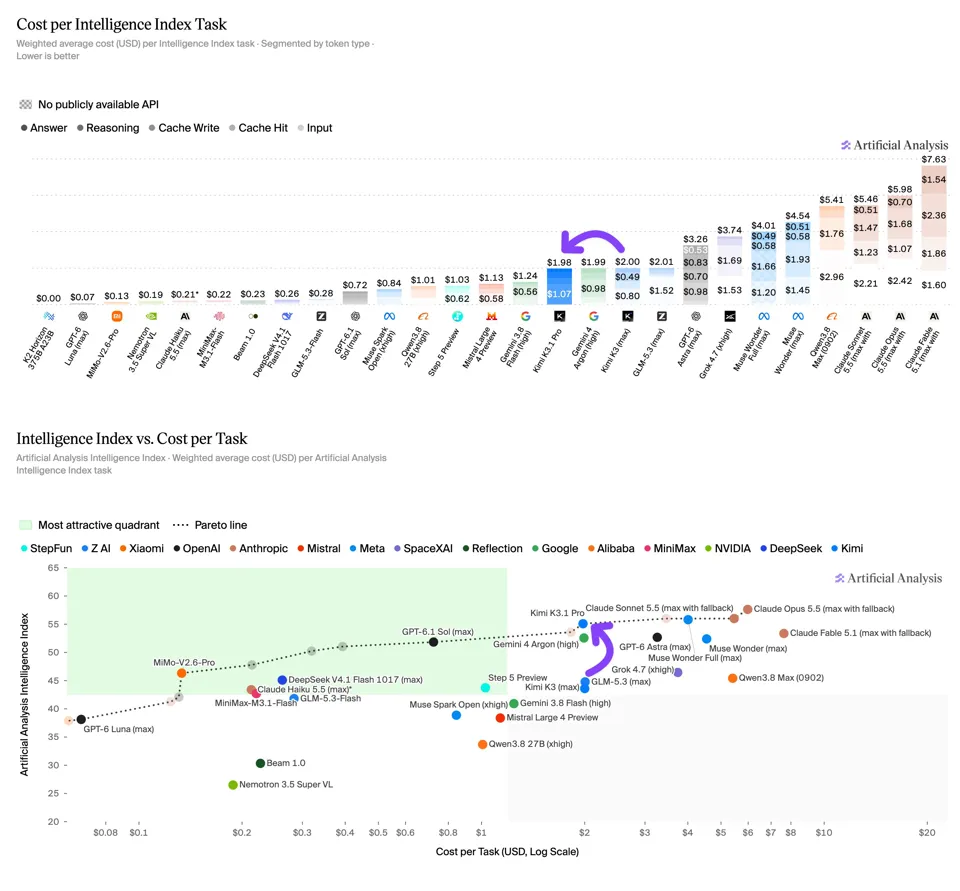
Kimi K3.1 Pro 以略低的单任务成本(1.98 美元 vs. 2.00 美元)实现了远高于 Kimi K3 的性能,使其位于 Artificial Analysis 的帕累托线上。| 图片:AA
Token 价格下降了 33%。输入成本为每百万 token 2 美元(从 3 美元下调),输出成本为 10 美元(从 15 美元下调),缓存命中成本为 0.20 美元(从 0.30 美元下调)。每个智能指数任务的平均成本为 1.98 美元,几乎与 K3(2.00 美元)持平,因为该模型生成的输出 token 数量增加了 14%。
网络安全与对攻击能力的刻意限制
对于开源权重版本,Moonshot 在两个训练阶段均剔除了与网络攻击相关的数据。在其内部的 xdev-bench-hard 基准测试中——该测试复现了 Linux 内核、Node.js 和 JavaScriptCore 等软件中近期披露的漏洞——未经过数据清洗的版本能解决 90.5% 的任务。经过数据清洗后,K3.1 Pro 的任务解决率为 81.0%。DeepSeek-V4.1-Flash 在同一测试中的得分为 85.7%,而 Kimi K3 仅为 33.3%。
Moonshot 表示,任何开源权重模型都不应推动网络攻击绝对前沿能力的发展。与此同时,该公司希望逐步提升开源模型的能力,因为这些模型也服务于审计遗留系统等防御性用途。Anthropic 此前曾展示,即使是在 AA 指数上得分为 45 的 GLM-5.3,也能编写出接近 Claude Mythos 水平的利用代码。