Rohan Paul (@rohanpaul_ai) · 2026/10/23 04:04:24
DeepMind 论文:可解释 AI 文本检测器逼近黑盒性能
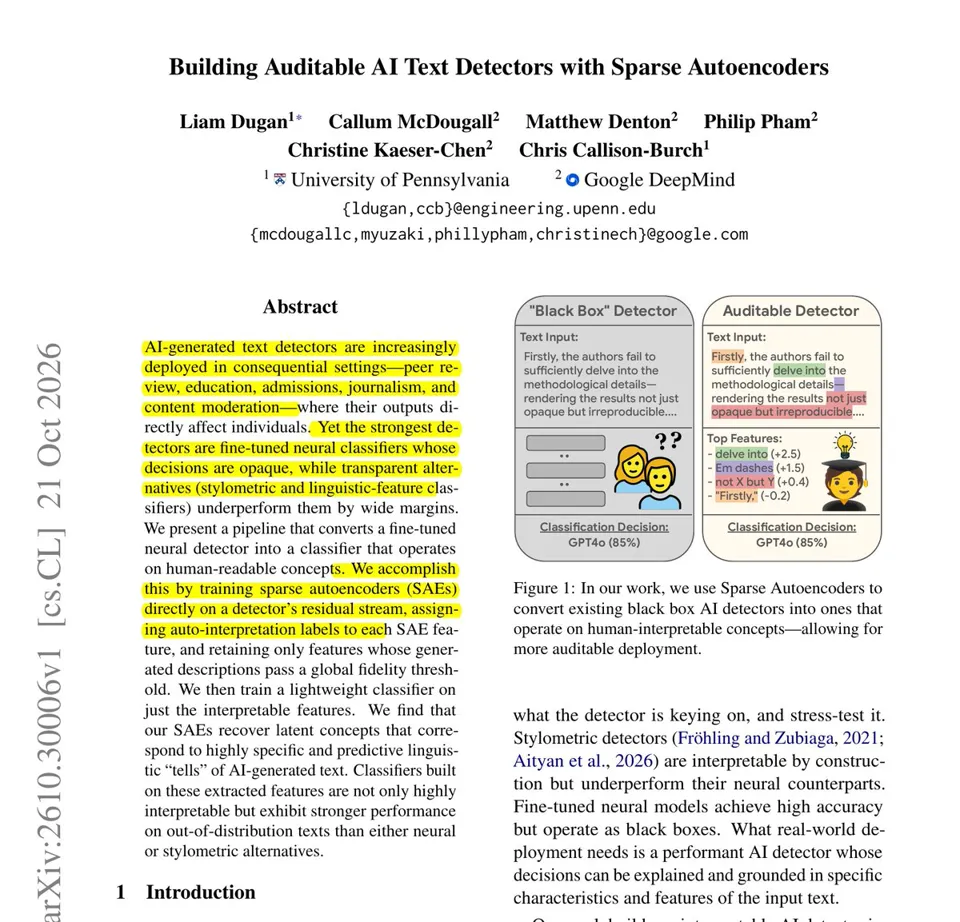
Google DeepMind 与宾夕法尼亚大学联合发表研究,利用稀疏自编码器将 Gemma-2-2B 检测器的内部活动分解为可读特征。该方法在保持高准确率(域内 F1 96.8)的同时,显著提升了泛化能力(未见数据 F1 92.2 vs 黑盒 75.2),使开发者能审查并移除有偏见的判断线索。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-22 20
Google DeepMind 与宾夕法尼亚大学(UPenn)的最新论文表明,AI 文本检测器既能通过可读的写作特征解释其判定结果,又能达到与黑盒检测器相当的性能。
这意味着,任何部署 AI 文本检测器的机构都应能够查看并移除检测器所依赖的具体线索。
目前性能最佳的 AI 文本检测器通常是黑盒分类器,但它们被用于标记学生论文和同行评审文章。虽然存在基于风格计量学(stylometric)的可读检测器,但其性能往往大幅落后于黑盒模型。
研究人员在 Gemma-2-2B 检测器的内部机制上训练了稀疏自编码器(sparse autoencoders),将其激活状态分解为各个特征,随后让一个大语言模型(LLM)对每个特征进行标注。他们仅保留那些标签能准确预测其特征行为的条目,并将这些特征输入到一个简单的分类器中。
仅使用经过良好标注的特征时,该检测器在域内数据上的 F1 分数保持在 96.8,接近黑盒模型的 98.0。而在未见过的测试数据上,基于基础模型特征构建的版本取得了 92.2 的 F1 分数,相比之下,黑盒模型仅为 75.2。
如果你的检测器决策会影响个人,请基于可标注的特征来构建它,以便审核人员能够看到并剔除他们认为不公平的线索。