Hacker News AI · 2026/10/24 01:10:27
月之暗面发布 Kimi K3.1 Pro 开源权重模型 支持百万上下文
月之暗面推出其最强开源权重模型 Kimi K3.1 Pro,具备 100 万 token 上下文窗口,在编码、3D 生成及金融研究等智能体任务上显著提升。该模型提供高速版本并已通过 API 上线,完整权重将于 11 月 4 日开放下载。
报道全文原始报道全文
本文目录11 个章节
我们正式推出 Kimi K3.1 Pro,这是全新 K3.1 系列的首款模型,也是迄今为止我们最强大的 3T 级开源权重模型,支持 100 万 token 的上下文窗口。它在编程、3D 创作、金融研究及其他智能体(Agentic)能力方面均实现了显著提升。
同时,我们还发布了 Kimi K3.1 Pro Highspeed,其速度是 K3.1 Pro 的 2-3 倍,可提供更流畅的交互体验。
Kimi K3.1 Pro 和 Kimi K3.1 Pro Highspeed 今日已在 Kimi.ai、Kimi Work、Kimi Code 以及 Kimi API 上线。完整模型权重将于 11 月 4 日发布。
推动开放智能的前沿发展
Kimi K3.1 Pro 是 Kimi K3 的后训练版本,采用了规模显著更大的后训练算力。为了在数百个下游领域实现大规模联合强化学习(RL),我们对技术栈的每一层进行了优化——包括 RL 框架、长上下文推理、训练效率、沙箱基础设施、Rollout 调度以及用于环境质量检查的共享平台——从而确保每一增量 RL 算力都能带来稳定且可预测的收益。因此,K3.1 Pro 在所有领域均实现了持续的性能提升。
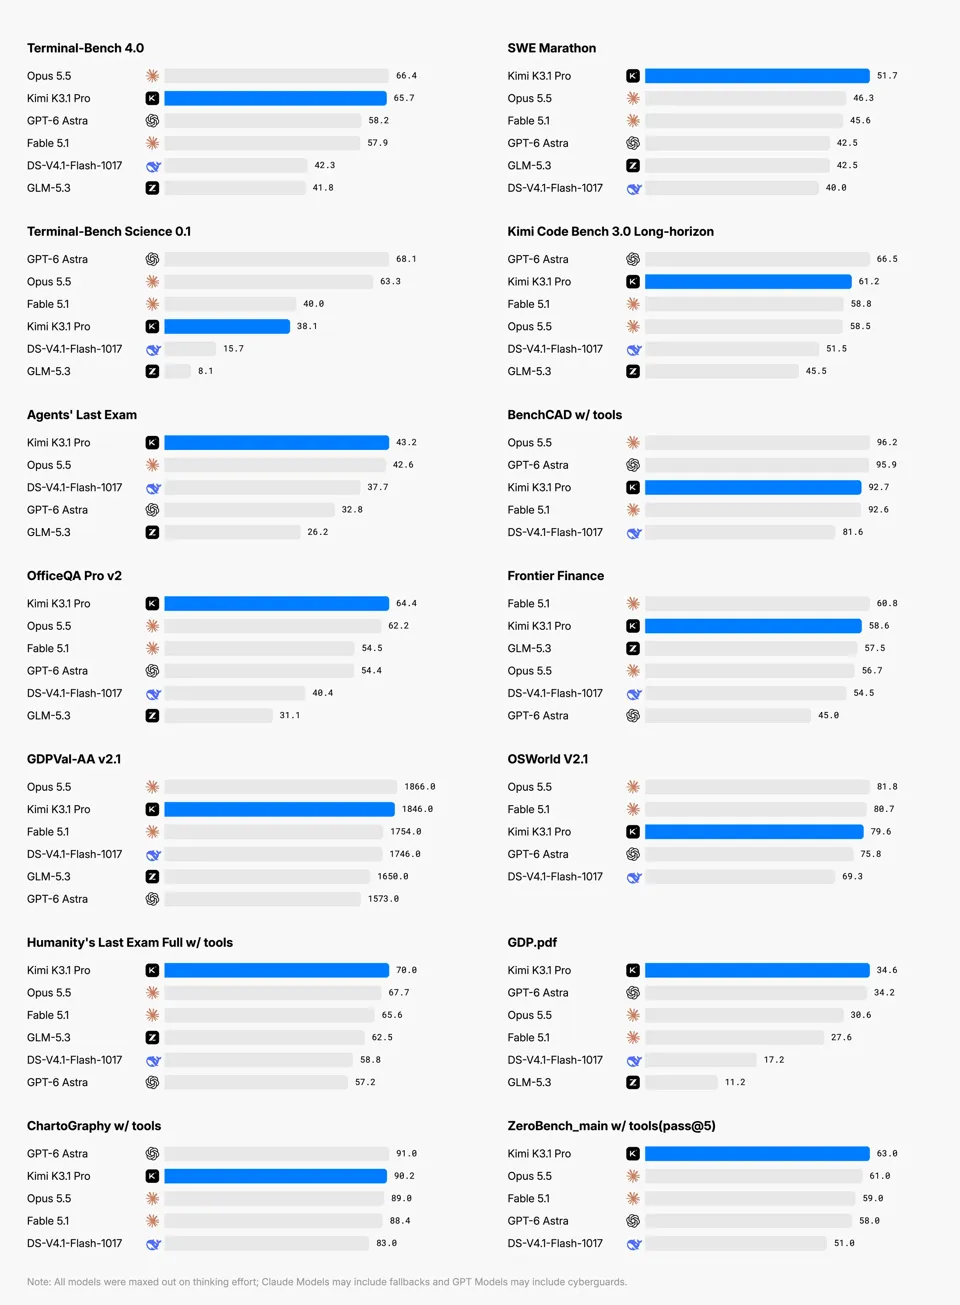
在编程、智能体和知识基准测试中,K3.1 Pro 的表现匹敌甚至接近最强的专有模型。在 Terminal-Bench 4.0 上(该基准使用严格的特定任务测试,评估编程智能体在真实资源受限终端任务中的表现),K3.1 Pro 得分 65.7%,领先于 GPT-6 Astra (58.2%),仅略低于 Claude Opus 5.5 (66.4%)。而在 Kimi Code Bench 3.0 Long-horizon(我们的内部基准,测试编程智能体在多样化工程领域的多步执行、工具使用和端到端问题解决能力)上,K3.1 Pro 得分 61.2%,高于 K3 的 55.95%。
编程
K3.1 Pro 涵盖了从真实代码库中的快速修复到完整项目构建的全方位编程工作。它还为游戏和 Web 体验带来了更具考量性的视觉风格,并懂得如何使用合适的工具来构建它们。
K3.1 Pro 在 Unity、Unreal Engine(虚幻引擎)和 Godot 等游戏引擎中均能高效运行,并结合网络搜索与 3D 生成功能来构建完整的体验。其前端页面、交互式 Three.js 场景以及 3D 资产在构图、排版、动画效果和整体精致度方面表现更为出色。以下示例均由 K3.1 Pro 端到端生成:
通过大规模强化学习,K3.1 Pro 的长周期编码能力也得到了显著增强。 在一项内部测试中,它基于 human-atlas——一个包含 296 个骨骼组件(含软骨)和 402 个肌肉组件的人体解剖学开源模型——构建了集成训练与评估流程的人类行走动力学模拟器。在历经 167 项任务和 420 次独立评审后,该模型分析了实验结果,诊断了问题,并迭代优化了行走控制器,使模拟人类从最初几秒内即摔倒的状态,进步到能够以交替步态连续行走 11.2 秒。当奖励塑形(reward shaping)未能改善手臂运动时,K3.1 Pro 并没有简单地持续调整奖励函数,而是对模拟器的动力学进行了开环探测,识别并修正了肩部肌肉力臂计算中的 36 处错误,随后重新训练了控制器。
3D 建模与设计
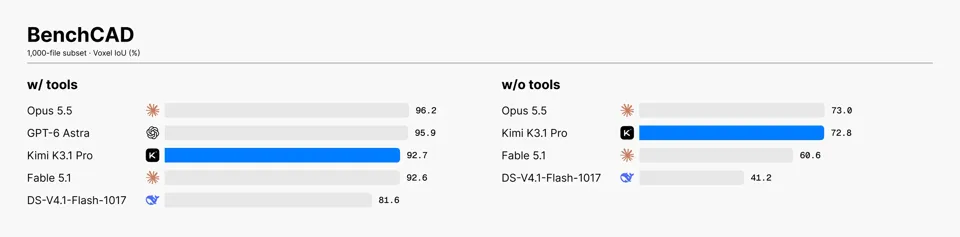
K3.1 Pro 在 3D 创建和空间推理方面表现出色。 在 BenchCAD 基准测试中(该测试旨在评估通过 CAD 代码生成从多视图渲染进行 3D 重建的能力),K3.1 Pro 借助工具取得了 92.7% 的成绩,接近 Claude Opus 5.5 (96.2%) 和 GPT-6 Astra (95.9%) 的表现。仅凭文本简报、草图或参考图像,它就能推断形状、比例和空间关系,从而创建可用的 3D 模型。此外,它对现有资产库和模型集合的理解也更为深入。
 K3.1 Pro 在参数化建模方面表现尤为出色,涵盖机械零件、建筑模型、可配置产品及定制家具等领域。 即使没有 MCP 连接器,它也能编写并运行 Blender 和 CAD 软件等工具的脚本,以构建和优化资产、编辑组件以及调整几何结构、材质和场景布局。
以下是 K3.1 Pro 为品牌影片、游戏和交互式 Web 体验创建的 3D 资产示例:
3D Make 现已在 kimi.ai 和 Kimi App 上线——你可以在线预览和编辑 3D 模型,下载可直接用于 3D 打印的文件,或将其导出为视频或 Live Photos(实况照片)以便随处分享。
金融
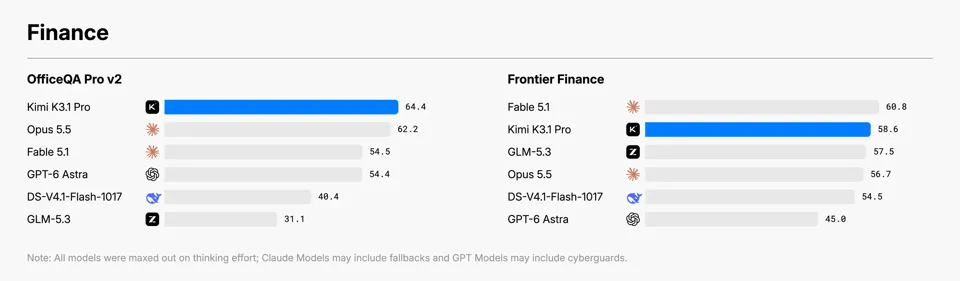
凭借更强的推理能力和 Agent 能力,K3.1 Pro 能够端到端地交付完整的金融工作流。K3.1 Pro 在 OfficeQA Pro v2 上取得了 SOTA(当前最佳)成绩(64.4), 该基准测试通过检索、跨文档验证和多步数值推理,考察基于真实金融文档的复杂财务数据分析能力。此外,K3.1 Pro 在 Frontier Finance 上也优于 K3,该基准衡量的是从筛选到盈利分析的完整投资工作流支持能力。
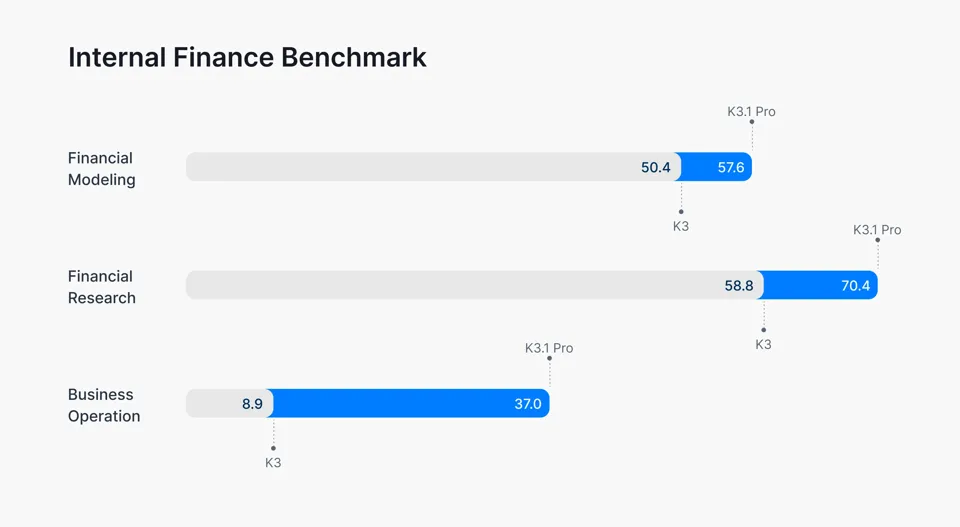
 K3.1 Pro 在我们所有的内部金融基准测试中也均有显著提升:
- 财务建模:评估真实世界建模任务中的公式关联、财务逻辑及最终工作簿质量。K3.1 Pro 较 K3 提升 7.2 分。
- 金融研究:评估模型在证据约束和截止日期限制下,能否产出可审计的研究成果。K3.1 Pro 较 K3 提升 11.6 分。
- 业务运营:评估在模拟商业环境中的长周期管理与决策能力。K3.1 Pro 的性能约为 K3 的 4.2 倍。
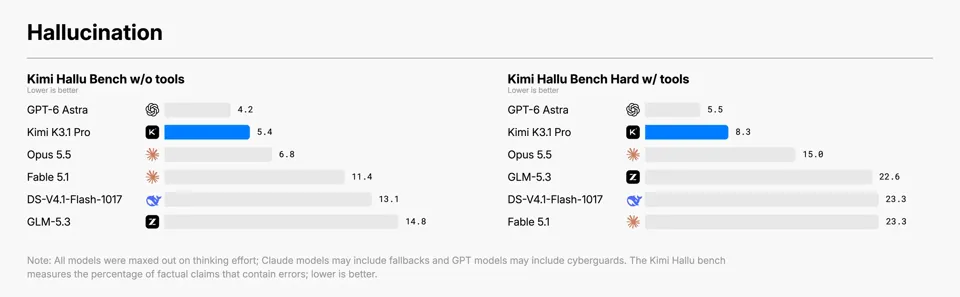
 财务分析和投资研究对事实准确性有着极高的要求。为此,我们针对 K3.1 Pro 在真实世界任务和复杂提示词下的事实准确性进行了定向优化。在 Kimi Hallu Bench Hard 基准测试(一项旨在压力测试事实准确性的内部基准)中,其声明级幻觉率从 K3 的 23.4% 降至 8.3%,而包含至少一处事实错误的回复占比仅为前代模型的 42.4%。(该评估是对事实准确性的压力测试,示例经过精心设计以探测模型易出错的场景。所报告的比率并不代表日常使用中的整体错误率。)
 以下案例展示了 K3.1 Pro 在实际操作中如何处理财务建模、投资分析以及基于来源的研究:
网络安全
随着 K3.1 Pro 能力的增强,我们也投入了相应比例更多的精力来理解网络攻击能力的来源,以及我们可以对其施加多大程度的控制。因此,我们分析并评估了 K3.1 Pro 的漏洞挖掘能力,并在训练过程中实施了针对性管控措施,以降低潜在的滥用风险,同时保持其通用实用性。
识别并移除网络相关数据。 在开发过程中,我们观察到随着后训练规模的扩大,漏洞研究性能稳步提升。追溯这一趋势的根源,我们发现网络相关内容嵌入在通用中期训练语料库中,且 RL 环境组合中存在网络相关任务——这是在广泛数据上训练的自然副产品。在内部模型的初步实验中,我们发现如果不在中期训练或 RL 阶段移除数据,下游的网络能力将大幅提升。这些发现为我们提供了具体的控制手段。对于 K3.1 Pro 的开放权重版本,我们从两个训练阶段中识别并移除了网络相关数据,同时保留了模型实用性所需的通用编程任务。我们将继续在每一个训练阶段实施适当的控制措施,其中网络相关数据的识别与限制便是其中一个示例。
评估与结果。 数据清洗完成后,我们在 xdev-bench-hard 上对 K3.1 Pro 进行了评估。这是我们的内部基准测试,包含专家精心策划的、基于源代码的漏洞发现和利用任务,经过校准以在当前能力水平下提供有意义的区分度。大多数任务忠实复现了近期披露的软件漏洞(如 Linux 内核、Node.js、JavaScriptCore、Exim 和 VirGL),并启用了缓解措施。每个任务提供易受攻击的源代码、简短的错误提示以及相应的二进制文件;智能体必须开发一个利用程序,在独立的沙箱中实现任意代码执行,并检索一个秘密字符串以供自动验证。我们报告的是随机子集运行中的 pass@3 指标,不设硬性超时或输出令牌限制。
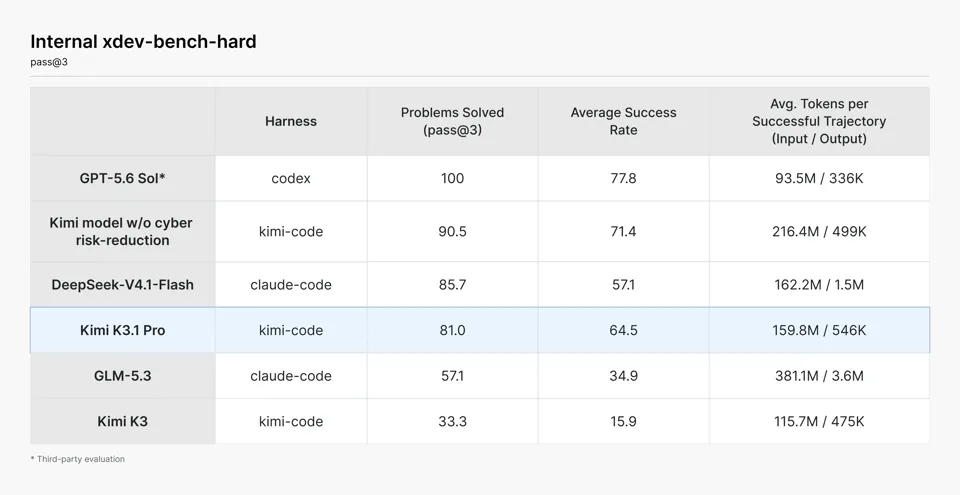
在 xdev-bench-hard 上,未采取这些风险削减措施的检查点——即在中期训练阶段未移除网络相关数据,且在强化学习环境中未过滤网络相关内容——在 pass@3 条件下解决了 90.5% 的问题;而最终的 K3.1 Pro 达到了 81.0%。这一对比表明,数据移除显著降低了网络能力,相较于同一训练流程原本可能产生的效果而言。同时,K3.1 Pro 相比其前代版本有了大幅提升,这表明即使在经过针对性的数据移除后,更强的通用编码和长周期调试能力仍能泛化到网络任务中。K3.1 Pro 的网络能力仍落后于那些已公开至少三个月的前沿专有模型。我们将持续演进内部基准测试,以确保随着模型能力的不断提升,评估结果依然具有参考价值。
开源权重原则。 这些评估为我们发布开源权重的决策提供了框架。首先,我们旨在不发布会拓展网络能力绝对前沿的开源权重。K3.1 Pro 的攻击性网络能力在设计上低于我们训练流程所能达到的水平,且仍落后于前沿专有模型。其次,我们计划逐步提升开源权重中可用的网络能力。我们认为,以非歧视性的方式提供 K3.1 Pro,有利于那些出于防御目的需要双用途能力的人群。当一个强大的模型是开源的,并且运行在用户自己控制的基础设施上时,更多的团队将获得审计其所维护代码的手段——包括那些很少接受专门安全审查的遗留系统。我们相信,让这种能力逐渐扩散——而不是将其集中在少数专有系统中——最终会使所有软件更加安全。
可用性
Kimi K3.1 Pro 今日已在 Kimi 产品家族中全面推出:包括 Kimi.ai 和 Kimi 移动应用、Kimi Work 和 Kimi Code,以及通过 Kimi API 提供服务。
完整模型权重将于 2026 年 11 月 4 日前发布。
Kimi 企业版管理员可以为其组织启用 K3.1 Pro;发布时默认关闭访问权限。
各渠道详情如下:
- Kimi Agents: 从移动应用商店下载或更新到最新的 Kimi App,支持 iOS、Android 和 HarmonyOS,或访问 kimi.ai。
- 使用 Kimi K3.1 Pro 工作: 下载最新的 Kimi Work 桌面应用,版本需为 3.1.0 或更高,支持 Windows 和 Apple Silicon Mac。
- 使用 Kimi K3.1 Pro 编码: 运行 Kimi Code,并使用
/model命令选择 Kimi K3.1 Pro。 - 通过 Kimi API 构建: 访问 Kimi API 平台,选择 kimi-k3.1-pro / kimi-k3.1-pro-highspeed。API 客户可使用零数据保留(Zero Data Retention)功能。
- 将 Kimi 引入您的组织:Kimi Business 提供企业级数据隐私保护和成员管理,个人账户与组织账户完全隔离。访问定价页面并选择“获取 Kimi Business”为您的团队订阅。
基准测试
脚注
除非另有说明,下文报告的所有 Kimi K3.1 Pro 结果均在推理努力度(reasoning effort)设为 'max'、温度 = 1.0、top-p = 0.95 的条件下获得。
编码基准测试
-
Terminal-Bench 4.0。Kimi K3.1 Pro 使用 Claude-Code harness 进行评估。DeepSeek-V4.1-Flash-1017 的数据取自其发布博客(https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017)。其余所有分数均取自其官方博客或官方 Terminal-Bench 4.0 排行榜中报告的最高值(https://www.tbench.ai/)。
-
Terminal-Bench Science 0.1。Kimi K3.1 Pro 使用 Claude-Code harness 进行评估。我们对 DeepSeek-V4.1-Flash-1017 的内部评估得分为 9.3;然而,旧版本 DeepSeek-V4.1-Flash 在官方 Terminal-Bench Science 上的得分为 15.7,因此我们在此处报告 15.7;其余所有分数均来自官方 Terminal-Bench Science 排行榜(https://www.terminal-bench-science.ai/)。
-
SWE-Marathon v1.1。Kimi K3.1 Pro 使用 Claude-Code harness 进行评估。DeepSeek-V4.1-Flash-1017 使用 ClaudeCode harness 进行评估。其他所有分数均来自官方 SWE-Marathon 排行榜(https://www.swe-marathon.org/)。
-
PostTrainBench。Kimi K3.1 Pro 和 DeepSeek-V4.1-Flash-1017 在 v1.2 版本上进行了内部评估,使用 Claude-Code harness 以及 H20 GPU(而非 H100 GPU)。为了确保评估稳定性,所有裁判模型(judge models)均以最大努力程度(maximum effort)使用 DeepSeek-V4.1-Flash-1017,这在测试中与官方 GPT-5.6-Terra (xhigh) 裁判模型最为匹配。其他分数来自官方排行榜(https://posttrainbench.com/)。
-
ProgramBench(二元评分)。我们报告的是二元评分而非原始 ProgramBench 分数:如果任务的 ProgramBench 得分 ≥95%,则记为 1 分,否则记为 0 分。Kimi K3.1 Pro 使用 Claude-Code harness 进行评估。DeepSeek-V4.1-Flash-1017 和 GLM-5.3 的分数取自发布博客(https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017);其余所有分数均来自 Vals ProgramBench 排行榜(https://www.vals.ai/benchmarks/programbench)。
-
内部编码基准测试:Kimi Code Bench 2.0 和 Kimi Code Bench 3.0 Long-horizon。Kimi K3.1 Pro 使用 Claude-Code harnesses 进行评估;所有其他模型均在最大努力程度设置下进行评估。请注意,专有模型的测试可能涉及一定的回退行为(fallback behavior)。
-
BenchCAD。我们在从完整的 17,900 例 Vision2Code 数据集中随机抽取的 1,000 例子集上,以最大推理强度(maximum reasoning effort)评估开源模型。带工具(with-tools)的结果使用 Claude Code harness;不带工具(without-tools)的结果则使用官方 BenchCAD 提示词和评分流程进行单次生成(single-shot generation)。Claude Fable 5.1 和 Claude Opus 5.5 的分数取自 Claude Opus 5.5 System Card;GPT‑6 Astra 的带工具分数取自其官方报告。GPT‑6 Astra 未报告不带工具的分数,因此标记为“—”。
智能体基准测试
-
BioMysteryBench 数据集源自 官方 v11 版本,并以 Kimi K3 作为评判模型。我们使用 Kimi Code 评估 Kimi K3.1 Pro,使用 Claude Code 评估 GLM-5.3 和 DeepSeek-V4.1-Flash-1017,并使用 Codex 评估 GPT-6 Astra。Claude 系列模型的分数直接取自其官方系统卡(System Cards)。
-
我们的 Agents’ Last Exam 数据集源自 官方 v1.1 版本,包含 122 个任务(其中 86 个为 CLI 任务),环境镜像与官方 Hugging Face 发布版本保持一致。对于绕过任务既定要求(例如在线检索答案而非在 Wireshark 中执行所需分析)的运行结果,我们额外赋予零分。DeepSeek 和 Kimi 分别使用 Claude Code 和 Kimi Code 进行评估。所有其他结果均取自官方基准测试网站。
-
OfficeQA Pro 及 OfficeQA Pro v2:GPT-6 Astra 使用 Codex 进行评估,而其他所有模型均使用 Claude Code 进行评估。每个任务向智能体提供完整的 PDF 语料库,所有 PDF 均渲染为图像,且不提供机器可读文本。我们在某些外部模型的轨迹中观察到它们在线检索参考答案的情况;因此,我们将这些任务判定为零分。
-
Frontier Finance 使用官方金融智能体 v2 测试框架(harness)进行评估。
-
HANDBOOK.md 使用基于 OpenHands 构建的官方测试框架进行评估,评估任务取自该基准测试早期的开源 v1 版本。
-
Harvey Legal Agent 在一个包含 1,251 个任务的公开数据集上进行评估,使用 Artificial Analysis 的 Stirrup 测试框架,性能以全通过率(all-pass rate,即通过所有评分标准细则的任务百分比)报告。
-
OSWorld V2.1 在官方 OSWorld v2 仓库中使用 Kimi Agent 测试框架进行评估,而 GPT-6 Astra 的分数取自 Muse Wonder 的技术报告。
-
DECK-Arena 针对真实世界查询评估演示文稿生成能力,而 Design Bench 则通过直接提示和参考图像少样本提示(few-shot prompting)涵盖平面设计领域;两者均在集成了搜索和图像生成功能的测试框架中,跨 python-pptx、pptxjs 以及 Kimi 内部 DSL 运行模型,并使用经过 10,000+ 人工判断校准的自动评分器进行评分。
-
MCP Atlas:所有模型均在包含 500 个任务的公开子集上进行评估,限制为 100 轮对话,并使用 Gemini 3.1 Pro 作为评判模型。
-
BrowseComp。我们采用 Claude 模型卡片中使用的上下文压缩策略,触发阈值为 200K tokens。我们允许最多 500 个步骤;如果在任务完成前达到此限制,我们将强制 agent 提供答案,随后对其进行评判。所有 BrowseComp 运行均设置 temperature=1.0 和 top-p=1.0。
-
GDPval-AA v2.1、AA-Briefcase v1.1 和 AutomationBench-AA 的分数引自 https://artificialanalysis.ai/,Apex Agents 的分数引自 https://www.mercor.com/apex/apex-agents-leaderboard/
-
GDP.pdf w/ python、ZeroBench w/ python 和 ChartoGraphy w/ python 的结果为五次运行的平均值。其他多模态基准测试(w/ python)的结果为四次运行的平均值。对于 GDP.pdf w/ python:每个原始 PDF 文件被发送到沙箱中,模型可在其中使用 IPython 工具进行处理。最终回复依据每项评分标准(rubric criterion),使用 Gemini-3.5-Flash(中等推理努力程度)和官方评判提示词进行打分。我们报告任务宏平均评分通过率:对于每个任务,我们在五次独立运行中对通过的评分标准比例取平均值,然后对所有任务的这些任务级得分进行等权平均。
推理、知识与多模态基准测试
- GDP.pdf:每个 PDF 均以页面图像形式提供,最长边缩放至 1,152 像素,并按页面顺序与 Docling 提取的文本交错排列。响应依据每项评分标准(rubric criterion),使用 Gemini-3.5-Flash Medium 和官方评判提示词进行打分。我们报告在完全评分响应中的严格通过率。
- HLE 和 HLE-Diamond:评估通用知识和推理能力。我们报告完整评估集上的准确率,其中 HLE 包含 2,500 个问题,HLE-Diamond 包含 1,000 个问题。对于标有星号 (*) 的模型,准确率仅基于纯文本子集的问题进行报告。
- GDP.pdf、ZeroBench 和 ChartoGraphy:结果取五次运行的平均值。其他多模态基准测试结果取四次运行的平均值。GLM-5.3 Max 和 DeepSeek-V4.1-Flash-1017 Max 的 GDP.pdf 分数引自 https://artificialanalysis.ai/。
- MMMU-Pro:遵循官方协议进行评估,保留原始输入顺序,并将图像前置到文本输入之前。
- Kimi 幻觉基准测试:评估在一组源自实际工作任务的内部高难度、去标识化提示词上的事实准确性。我们报告由事实核查智能体(fact-checking agents)评估的声明级幻觉率。