Cohere 论文证实投机解码在 MoE 模型低批次下显著提速
Cohere 最新研究推翻了“投机解码在混合专家(MoE)模型小批次场景收益有限”的传统观点。实验表明,相邻 Token 的专家路由重合度高达 20%-45%,远超理论预期,使得验证步骤开销极低。在 Qwen3-235B 等模型上,验证速度可达正常解码的 89%,为智能体工作负载提供了高效的推理优化方案。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-02 21
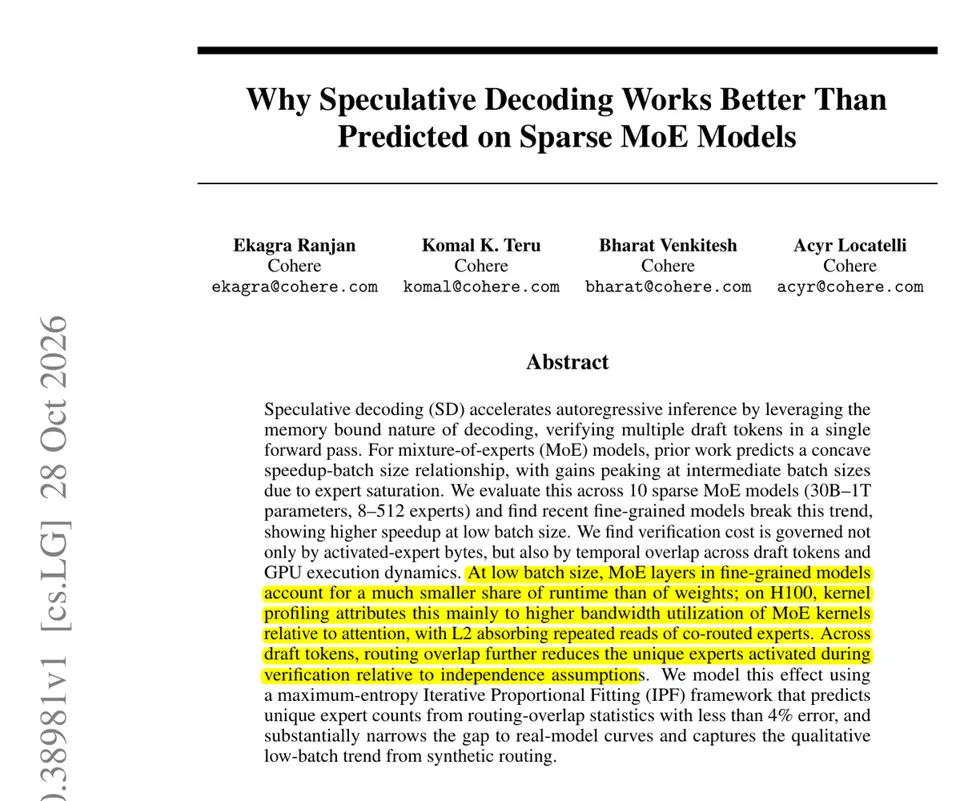
@cohere 的新论文发现,即使在 batch size 为 1 的情况下,投机解码(speculative decoding)在细粒度 MoE 模型上也能取得良好效果,而此前研究预测其收益甚微。
研究发现,在混合专家(mixture-of-experts, MoE)模型中,相邻 token 共享 20% 到 45% 的专家,远高于预期的 4% 到 12%,这使得投机解码的成本低于预期。
投机解码允许一个小型草稿模型(drafter)提出候选 token,由大模型在一次前向传播中进行验证。对于 MoE 模型,此前研究认为验证多个 token 会加载大量额外专家,从而限制了低 batch size 下的性能增益。
他们测试了从 30B 到 1T 参数的 10 个 MoE 模型,并在 H100 GPU 上进行了性能剖析。结果显示,连续 token 会复用大量专家,且较小的专家能充分利用 GPU 带宽,因此验证额外 token 的成本很低。
相邻 token 共享了其专家的 20% 到 45%,而基于独立路由的预期值仅为 4% 到 12%。以 FP8 精度下的 Qwen3-235B 为例,验证步骤的速度达到了正常解码步骤速度的 89%,而预测值仅为 52%。
对于低 batch size 的 MoE 服务场景(例如 Agent 工作负载),建议在你的硬件上对投机解码进行基准测试,而不是直接排除这一方案。