Rohan Paul (@rohanpaul_ai) · 2026/10/21 08:47:39
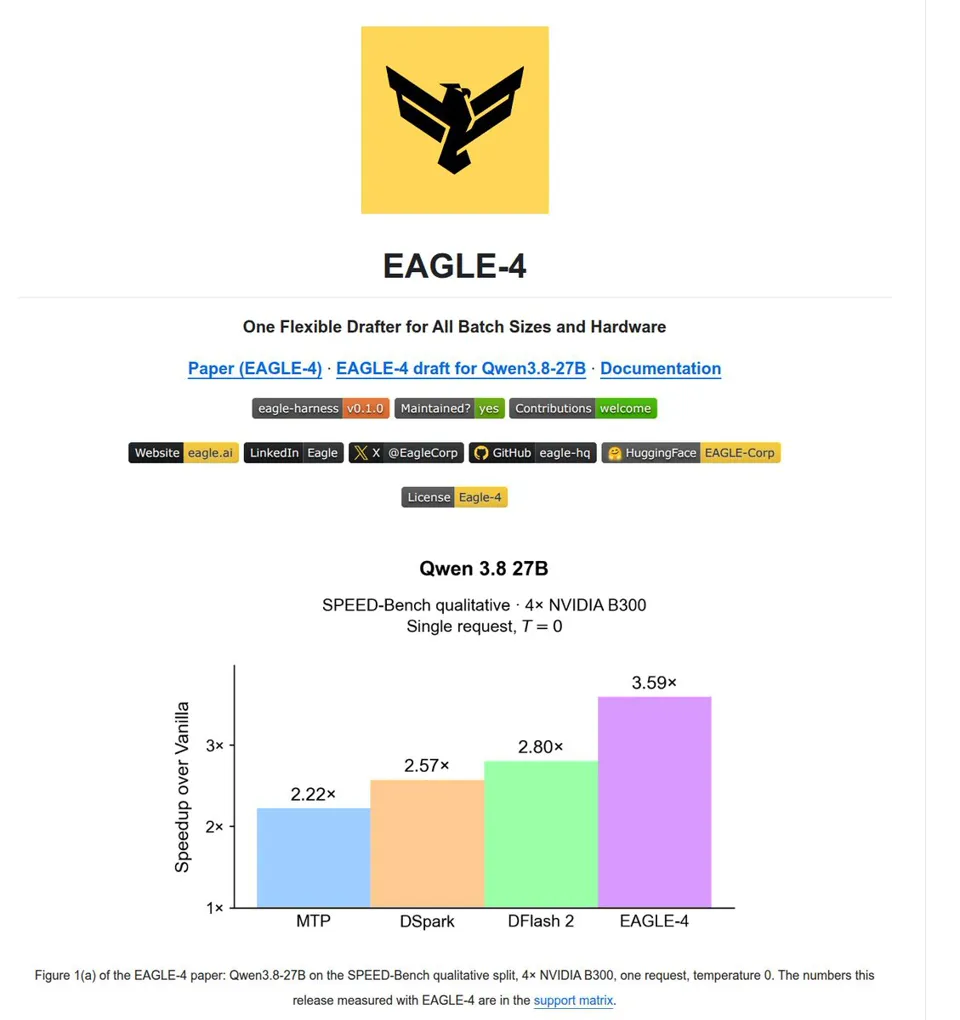
EAGLE-4 发布 投机解码提速至 961 tokens/s
出处作者 / 发布主体:Rohan Paul (@rohanpaul_ai)原标题:Some of the most useful inference work right now is happening in the speculative decoding component.
78AI 研判分
核心综述
EAGLE-4 作为最新的投机解码加速组件,在 Qwen3.8-27B 模型上实现了单请求 961.6 tokens/s 的推理速度。它通过优化草稿模型结构和降低 LM Head 成本,在保持输出一致性的前提下显著提升了生成效率,成为当前大模型推理优化的重要工具。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-21 00
目前,最具实用价值的推理优化工作正集中在投机解码(Speculative Decoding)组件上。
它已成为在已选定模型的基础上提升每秒生成 Token 数最可靠的方法之一。
EAGLE-4 在单请求场景下,于 27B 模型上实现了 863.8 tokens/s 的解码速度,分别是 DFlash 2 的 1.28 倍和 DSpark 的 1.40 倍。
EAGLE-4 是用于加速 AI 聊天机器人运行的插件:一个微型辅助模型会猜测接下来的几个词,而大模型则一次性验证所有猜测,而非逐字生成。在测试配置下,输出结果完全一致,但速度提升了约 3 倍。
EAGLE-4 保留了“草稿-验证”循环机制,并将优化重点放在草稿生成端,采用了自适应草稿结构和更轻量的草稿 LM Head。
该循环流程如下:
- 小型草稿模型提前提议多个 Token
- 目标模型在一次前向传播中验证所有这些 Token
- 保留匹配的 Token,并用目标模型生成的 Token 替换第一个不匹配的 Token
- 从此处继续重复上述过程
↳ 引用 @EagleCorp (Eagle): EAGLE-4 来了。
从 EAGLE-1 到 EAGLE-3,我们一直在让推理更快。
EAGLE-4 是我们迄今最快的版本。
在 @Alibaba_Qwen 的 Qwen3.8-27B 上使用 TokenSpeed 达到 961.6 tokens/s(BF16,4× @NVIDIA B300,TP4,单请求,T=0)。