NVIDIA 研究证实智能体频繁压缩上下文可大幅降本且精度几乎无损
原标题:New NVIDIA paper finds that AI agents barely lose accuracy when they keep contexts short by compacti...
78AI 研判分
NVIDIA 最新论文指出,AI 智能体通过定期将历史对话压缩为简短交接笔记并重启会话,可在保持精度的同时显著降低推理成本。实验显示,在长文档处理中结合文件搜索工具而非全量读取,多数基准测试下精度损失不超过 2 分,而长上下文窗口会导致每 Token 生成成本增加 3.6 至 7 倍。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-04 18
NVIDIA 最新论文发现,AI Agent 通过频繁压缩历史记录以保持上下文简短,几乎不会损失准确率。
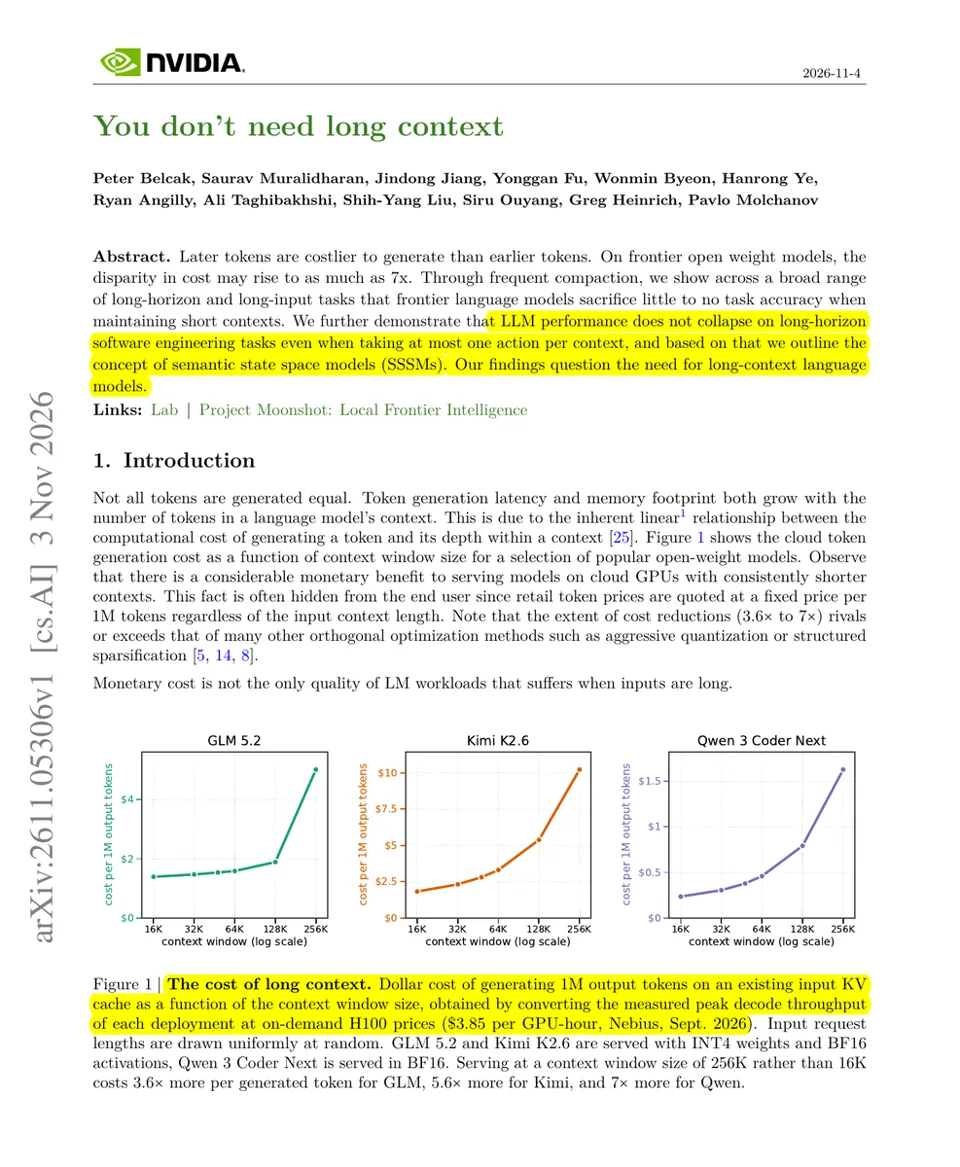
随着上下文增长,生成每个新 token 的成本也随之增加。以 256K 上下文窗口而非 16K 来服务开源模型,每生成一个 token 的成本高出 3.6 到 7 倍。
研究人员让 Agent 在达到设定限制时停止,撰写一份简短的交接笔记(handoff note),然后仅基于该任务和笔记重新启动。对于长文档,Agent 使用 Bash 工具搜索文件,而不是一次性读取所有内容。
在 6 个长周期基准测试中,每个模型最多仅有 22 种压缩设置中的 5 种相比完整历史记录的准确率下降超过 2 个百分点。在每次行动后都进行压缩,使 Claude Opus 4.5 在 SWE-bench Verified 上的准确率达到 70.2%,而使用完整历史记录时为 70.0%。
在为长上下文付费之前,先给 Agent 提供结构化的交接笔记和文件搜索工具,然后检查短上下文是否能满足你的准确率要求。