实证研究:AI 编程助手自我复盘优化效果有限
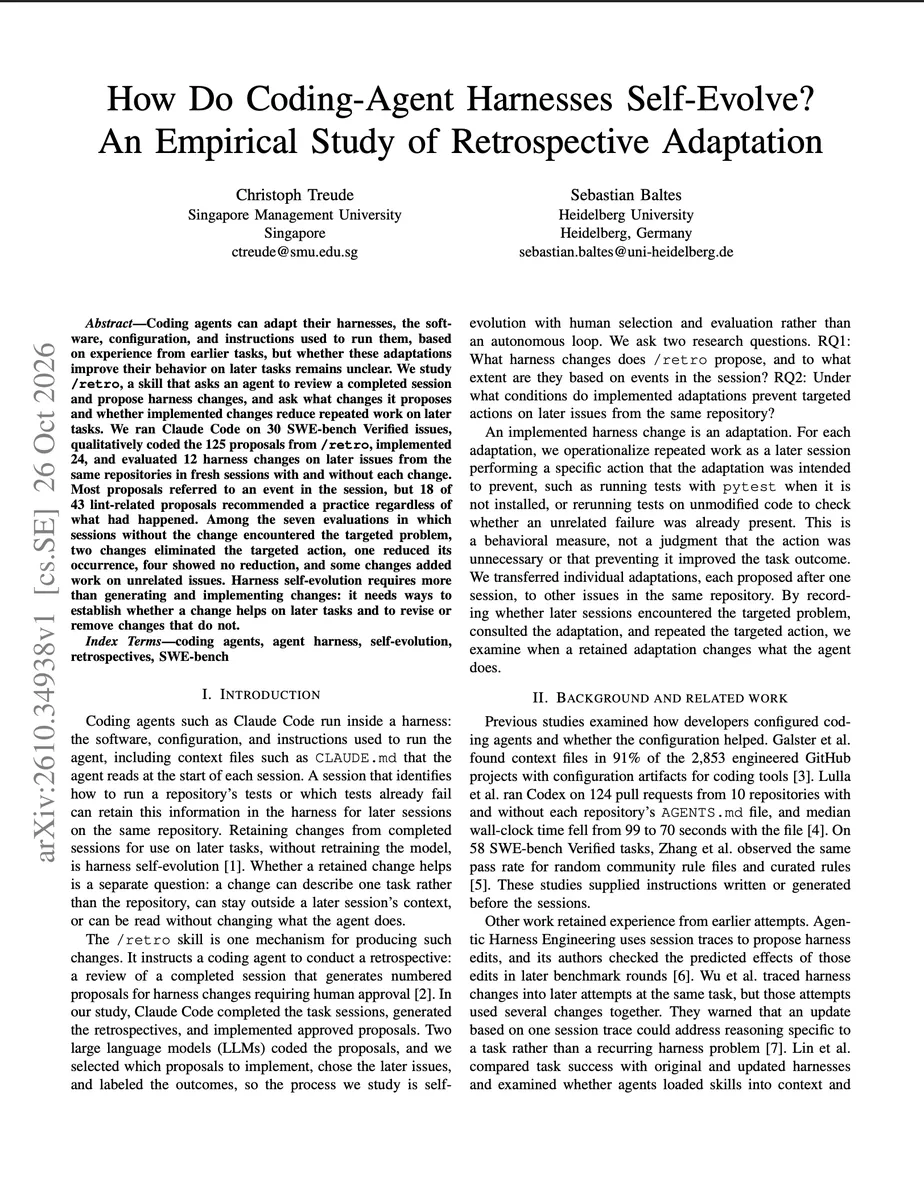
最新论文《How Do Coding-Agent Harnesses Self-Evolve?》通过 SWE-bench 测试发现,让 Claude Code 等智能体在任务后自动复盘并修改 Skill 文件的“自我进化”机制效果不佳。在 125 条建议中,仅少数改动彻底解决了目标问题,且部分优化导致无关任务出现冗余检查。研究表明,缺乏清晰验收标准时,完全依赖 AI 自我迭代难以实现稳定提升,仍需人工介入指导方向。
报道正文
宝玉 (@dotey) · 2026-11-03 19
不知道你有没有用过 /retro Skill,就是在编码任务完成后,让 AI 复盘刚结束的工作,列出几条修改建议,由人决定采不采纳。
除了 /retro 这个用在写代码上的,还有一些其他类似的复盘自我进化的 skill,听起来很美好:AI 干完一个任务后,回头看自己哪里卡住了,再提议修改 Skill,下次就不用再重复同样的弯路。这样不用重新训练模型,只修改 Skill 文件。
其实我一直是抱怀疑态度的,如果没有清晰的标准还是挺难自我优化好的。完全依赖人的话也难,一方面对人的要求有点高,另一方面每次这么做一下也挺累。
有篇论文《How Do Coding-Agent Harnesses Self-Evolve? An Empirical Study of Retrospective Adaptation》,专门测试了"让 AI 编程助手干完活后自己复盘、修改工作手册"的做法。
结果是,7 次有效测试里只有 2 项改动彻底消除了想解决的问题,有的改动还让 AI 在不相关的任务上多做了检查。
论文作者是新加坡管理大学的 Christoph Treude 和德国海德堡大学的 Sebastian Baltes,论文 10 月 26 日发布在 arXiv 上。
研究方法是这样的。
作者从 SWE-bench Verified 中选了 30 个问题,这是一套从真实开源项目里收集的代码修复题目,涉及 Django、SymPy、Astropy 等 Python 项目。
前 10 个是随机抽的,后 20 个专门从之前碰到过环境问题的项目里挑,比如项目里本来就有测试失败。Claude Code 每修完一个问题就运行一次 /retro,一共得到 125 条建议。
作者挑出 24 条让 Claude Code 落实,其中 11 项能拿来测试,再加上作者自己写的 1 项对照,共 12 项。测试时,在同一个项目里找另一个确认会出现同样问题的任务,用原来的设置跑 5 次,用改过的设置再跑 5 次,比较 AI 会不会再做那个本想避免的动作。
这次研究用的是 Anthropic 的 Claude Code,背后的模型是 Opus 5.5。
主要发现有四点:
- 大部分建议有依据。
125 条里有 101 条针对的是任务中真实发生的事。另有 19 条的理由跟这次任务里发生的事无关,其中 18 条是建议加代码格式检查。
原因之一是 /retro 的指令本身就规定,项目里没有提交前检查、也没有自动化检查流程的,算作一个"发现"。作者把其中一条"提交代码前自动跑格式检查"配置好后测试,5 次里 AI 一次都没读它,也没运行它。
- 13 次测试里,只有 7 次在原设置下真的碰到了目标问题,结果才有参考意义。
这 7 次里,彻底消除问题的有两项。
一项是在 CLAUDE.md 里写明 SymPy 项目要用 bin/test 跑测试,并说明没有安装 pytest。改之前,5 次里 5 次都先去试 pytest 然后失败;改之后是 0 次。
另一项是给 Astropy 项目写了一份"本来就会失败的测试清单"。
以前 AI 遇到测试失败,会在没改过的原始代码上再跑一遍测试做对比,确认失败是不是自己造成的;有了清单,它直接查清单,这种对比从 5 次中的 3 次降到 0 次。
- 剩下 5 项改动,都没覆盖下一个任务里实际遇到的情况,比如清单里列的失败测试和下次碰到的不是同一批。
这 5 项里只有 1 项让对比次数减少,从 5 次降到 2 次,另外 4 项没有变化。
- 有的改动增加了工作量。
Sphinx 项目的一份失败清单写着"不在清单里的失败,都当成是你自己的修改造成的"。
结果在一个不相关的任务上,5 次里有 4 次 AI 额外做了对比检查(原来是 0 次),用时中位数从 82 秒涨到 245 秒。前面那份有效的 CLAUDE.md 还顺带加了一句"完成前运行格式检查",AI 每次都照做,用时中位数从 88 秒涨到 156 秒。
至于最后有没有修好问题,用不用这些改动,每组 5 次里的成功次数最多差 1 次,看不出成功率有提高。
作者的结论是,这个项目用什么命令跑测试这类全项目通用的信息,记下来以后一直有用;在某个环境里哪几个测试失败这类信息,换个任务就可能对不上。
评估一项改动,要看问题有没有出现、AI 有没有读这项改动、行为有没有变。保留下来的改动也要持续评估,因为过时或不完整的说明可能不起作用,甚至增加工作量。
作者也说明了研究的局限:每种设置只跑了 5 次,样本小;测试任务是特意挑的会重现问题的任务,可能高估改动的效果;只测了一个 AI 工具、一个版本的 /retro,而且只涉及环境类问题。
↳ 引用 @dotey (宝玉): 以我的经验,只有明确的可以程序自动验收标准的 Skills 才能自我进化,比如说你写个 Skill 去优化代码性能,这个代码性能是可测量可量化的,那么给一些测试样例去优化 Skill,那么能越来越好。
对于一些没有明确的验收标准的 Skill,比如你写一个写作的 Skill,写作的好坏并没有很明确的验收标准,只能是 AI “自己打分”,但是这个打分其实和真实人类的体感还是有差距,AI 打分很好的稿子可能真人看起来一股 AI 味。
真想写好 Agent Skills,还是要人去用,人去指出优化的方向,才能优化好。
但有一点,没必要人自己去写 Skill,最好是人指挥 AI 去优化 Skill,AI 在具体执行上是做的蛮好的。
另外做好版本管理,一轮一轮迭代,有时候还会出现负优化,得回退到旧的版本。