英伟达新方法将推理轨迹缓存为 CPU 代码 成本降 291 倍
原标题:New NVIDIA paper finds that once an LLM has reasoned through a problem, the solution can run as CPU ...
78AI 研判分
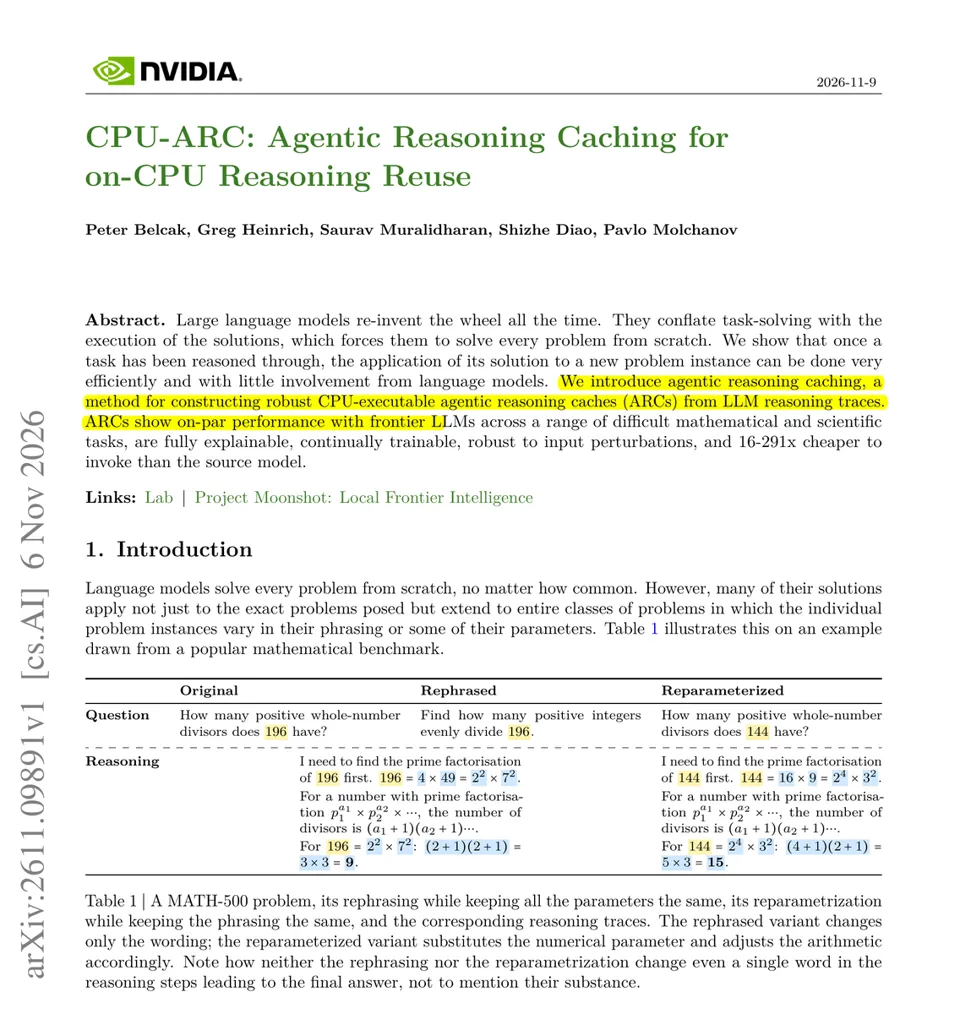
英伟达论文提出将大模型的推理轨迹编译为带参数的小型 Python 函数,在 CPU 上执行以复用推理结果,仅在抽取数值等轻量文本任务时调用微调的 1B 小模型。该方法在 8 个数学与科学基准中的 7 个达到或超过原模型精度,AIME '25 上为 93.3% 对 83.3%,对改写或换数的变体覆盖至少 90%,成本降低 16 至 291 倍。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-11-21 16
NVIDIA 的新论文发现,一旦 LLM 推理清楚了一个问题,其解法就能以 CPU 代码的形式运行,用于处理该问题的改写版和重新编号版。
这样一来,回答类似问题的成本降低了 16 倍到 291 倍。
LLM 每次都会从头重新求解每个问题,即使只是措辞或数字发生变化。智能体用新数据发送相同指令时,每次都要为这种重复推理付费。
他们的方法让 Claude Opus 4.5 把推理轨迹转成小型 Python 函数,并将可变的输入作为参数。运行时他们在 CPU 上执行,只在提取数值这类小型文本任务上调用一个微调过的 1B 模型。
在 8 个数学和科学基准测试中,该缓存有 7 个达到或超过了源模型的准确率,在 AIME '25 上得分为 93.3%,而源模型为 83.3%。它处理了至少 90% 的改写版或重新编号版变体。
如果你的智能体整天用新输入运行相同的提示词,就把推理缓存为代码,只在未命中时才使用 LLM。