Meta 发布 Muse Ember 以三分之一成本对标 Claude Haiku
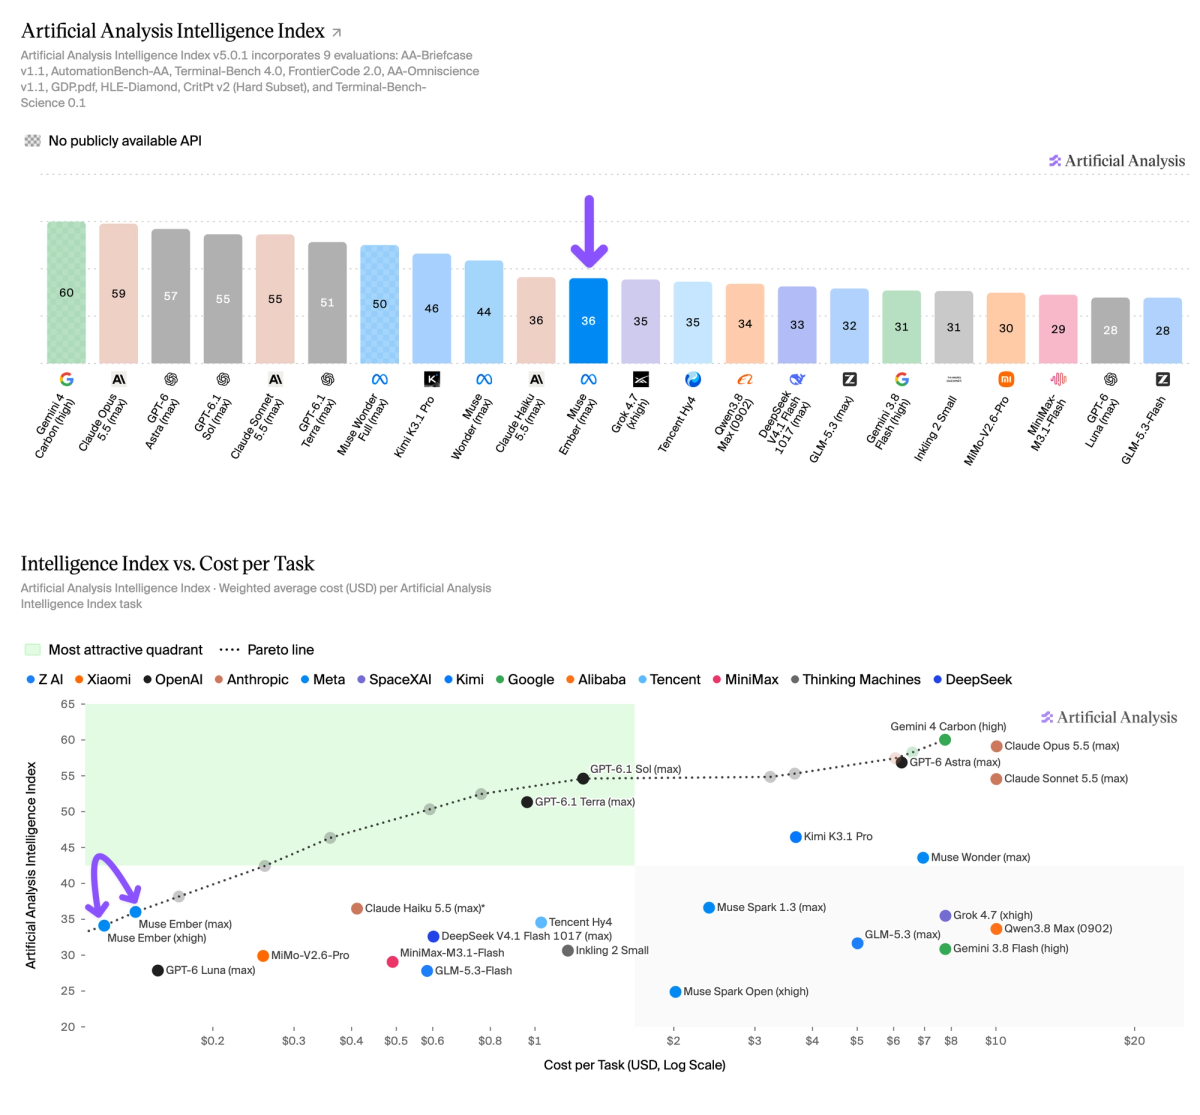
Meta 推出高效能模型 Muse Ember,在 Artificial Analysis 智能指数上得分 36,与 Claude Haiku 5.5(max)持平,但单任务成本仅 0.14 美元,约为后者的三分之一。该模型在 AutomationBench-AA 上得分 68.1%,与自家旗舰 Muse Wonder 持平,但整体智能水平落后旗舰 8 分,成本却仅为旗舰的约五十分之一。
报道正文
本文目录3 个章节
Meta 最新模型 Muse Ember 在 Artificial Analysis 智能指数上得分 36,与 Claude Haiku 5.5(max)持平,而每任务成本仅为其三分之一
Muse Ember 是 Meta 最新的高效级模型系列,其输入和输出 token 价格与 Claude Haiku 5.5 和 GPT-6 Luna 相同
关键要点:
➤ 在 max 和 xhigh 两种推理强度下,均位于智能指数与每任务成本帕累托前沿。 Muse Ember(max)是得分 36 或以上模型中最便宜的一款,每任务成本为 $0.14;Muse Ember(xhigh)以 $0.12 的每任务成本得分 34。Claude Haiku 5.5(max)在取得与 Muse Ember(max)相同分数的情况下,成本几乎高出 3 倍,为 $0.41。Muse Ember(max)的成本也约为 DeepSeek V4.1 Flash 1017(max,33 分,$0.60)和 GLM-5.3-Flash(28 分,$0.58)的四分之一
➤ 比 Muse Wonder 低 8 分,但每任务成本约为其 1/50。 Muse Wonder(max)得分 44,每个智能指数任务成本为 $6.95
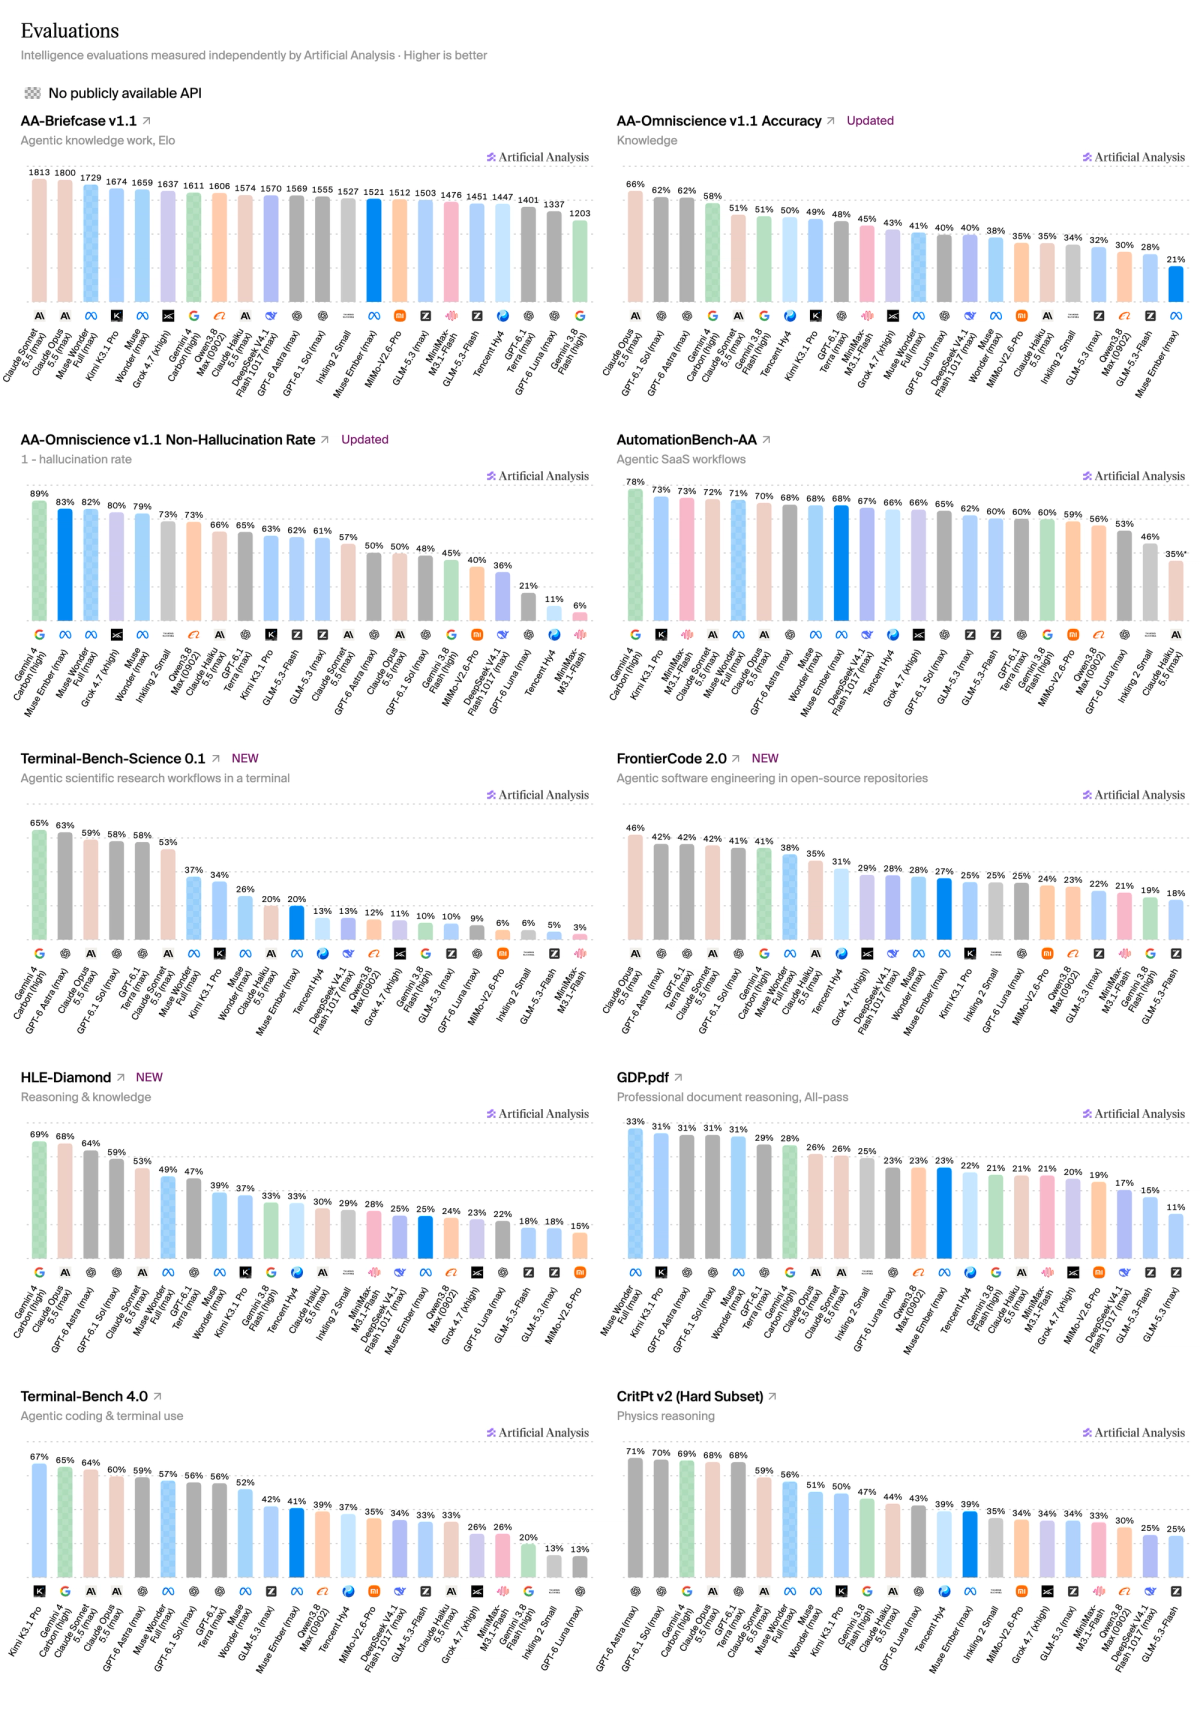
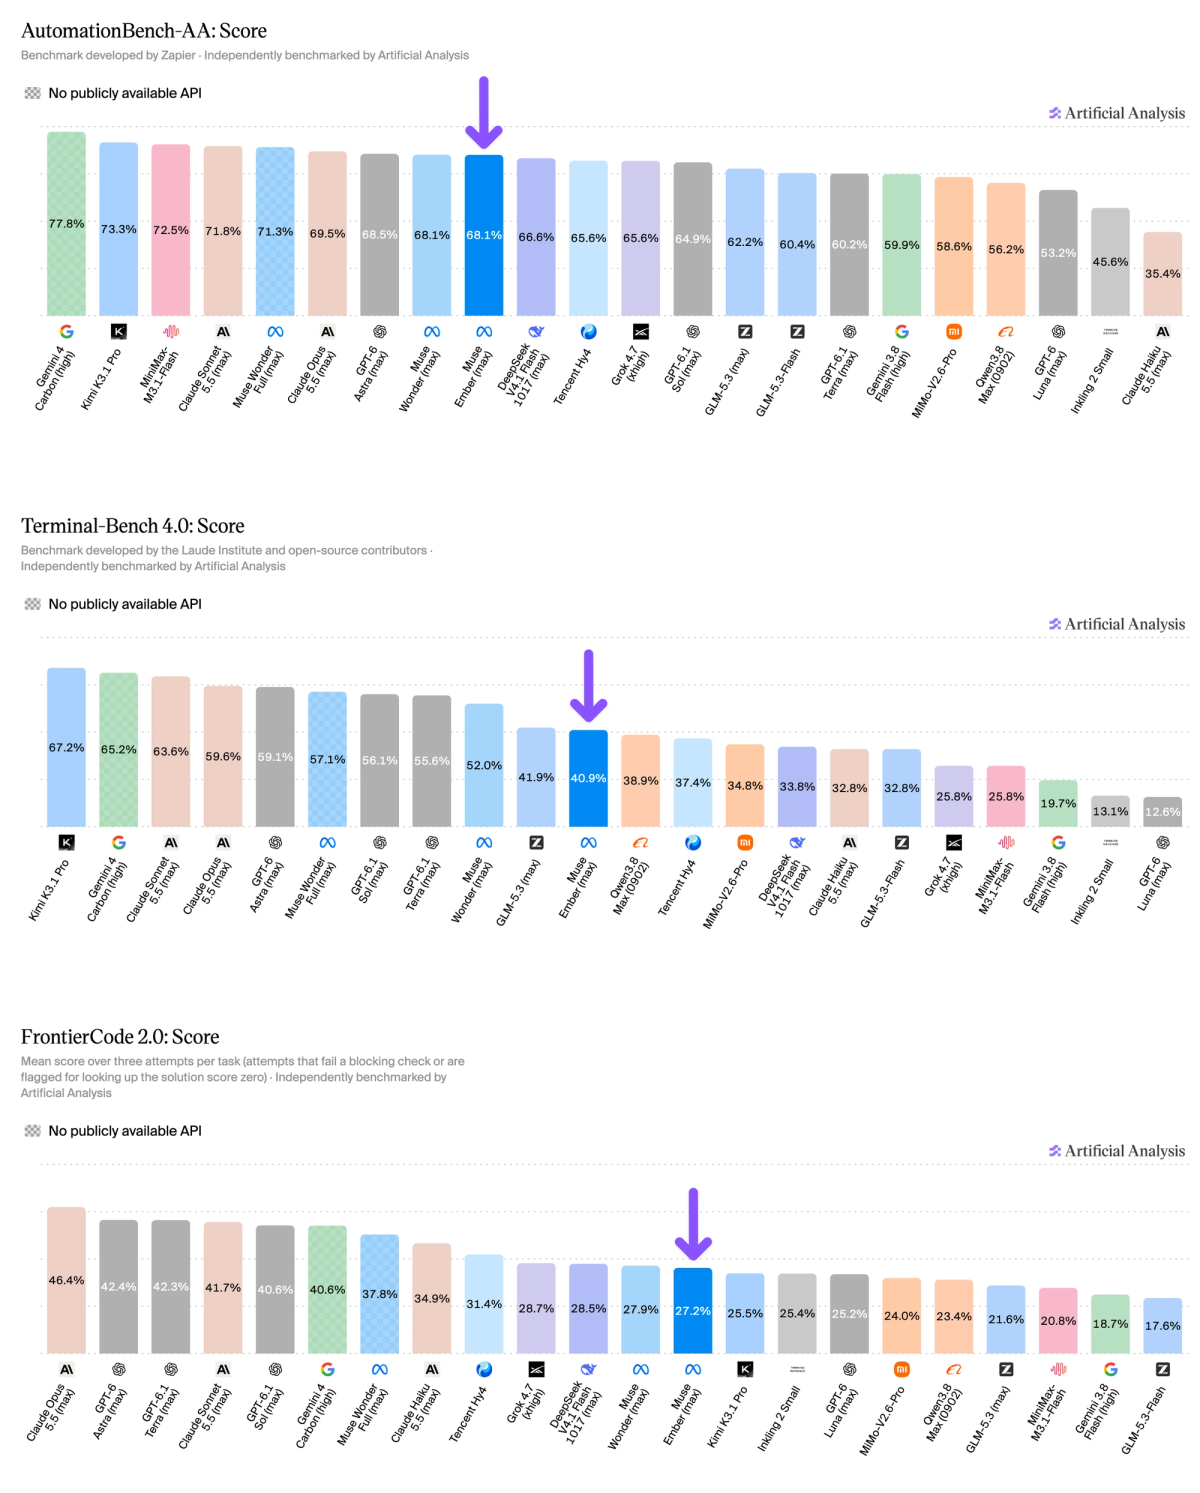
➤ 在 AutomationBench-AA 上表现突出。 Muse Ember(max)在 AutomationBench-AA 上得分 68.1%,与 Muse Wonder(max)持平,并在 GDP.pdf 上超过 Claude Haiku 5.5(max)(22.8% 对 20.8%),但在 AA-Briefcase 上落后于它(1521 对 1574 Elo)
➤ 在我们的智能指数评估中,智能体编程表现参差不齐。 它在 Terminal-Bench 4.0 上超过 Claude Haiku 5.5(max)(40.9% 对 32.8%),但在 FrontierCode 2.0 上落后于它(27.2% 对 34.9%)
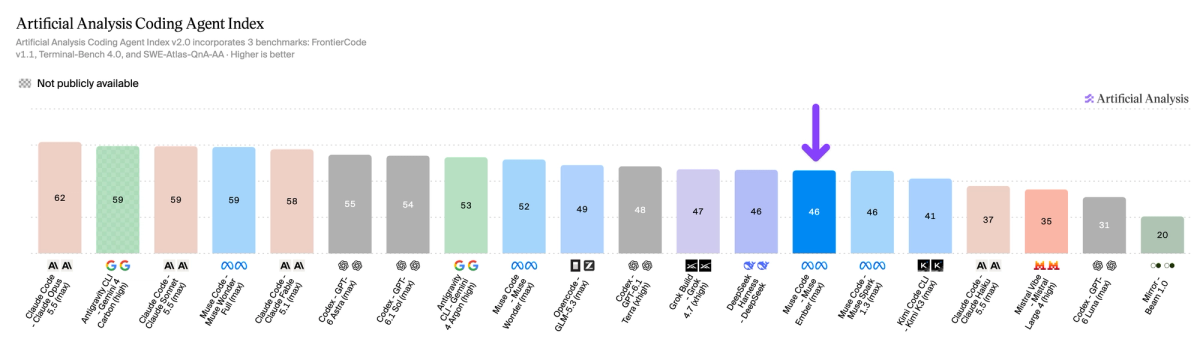
➤ 在自有编程智能体中运行时领先于同价位模型。 在 Muse Code 中,Muse Ember(max)在 Artificial Analysis 编程智能体指数上得分 46,领先于 Claude Code 中的 Claude Haiku 5.5(max,37)和 Codex 中的 GPT-6 Luna(max,31)
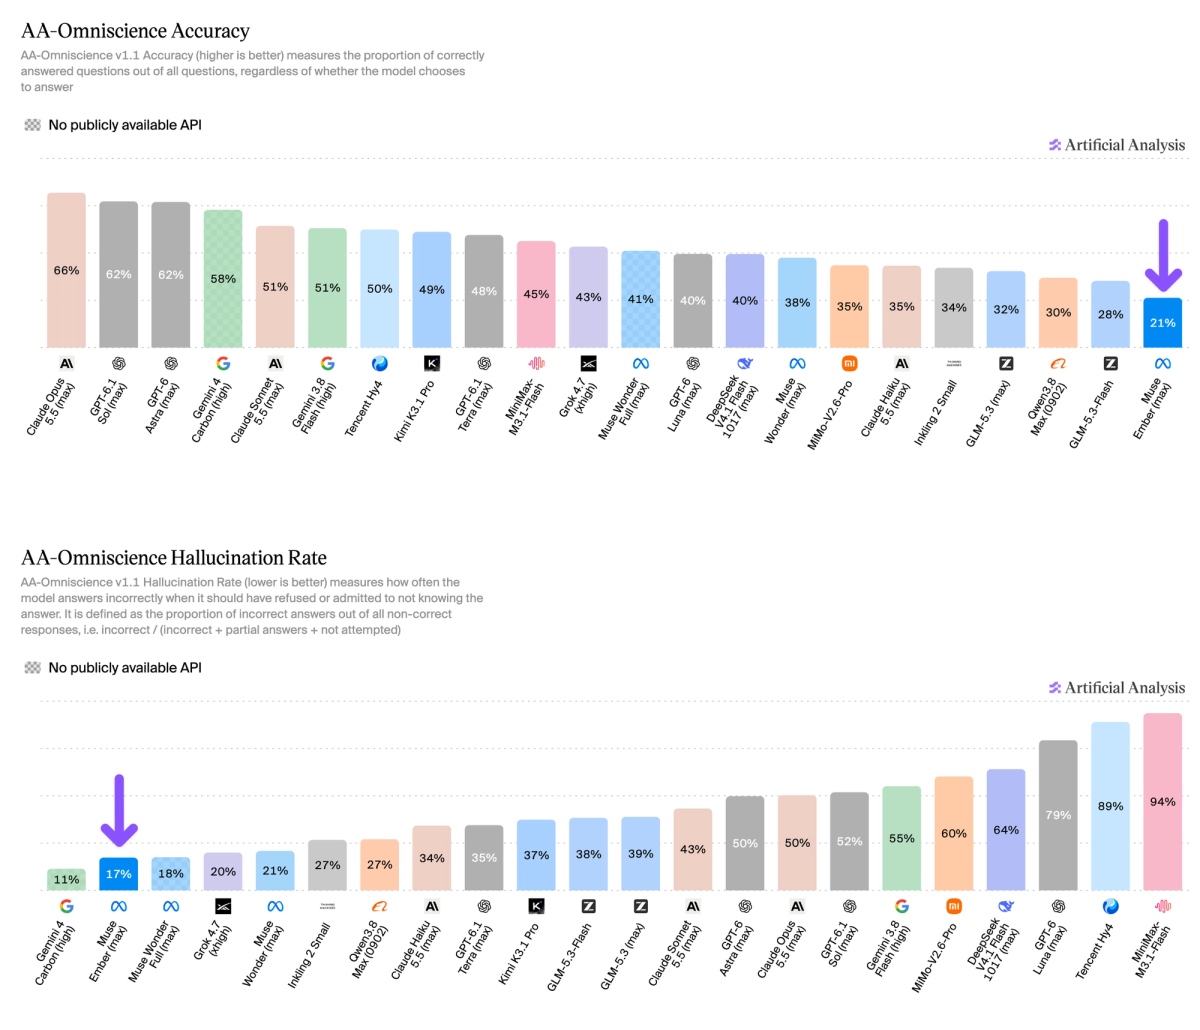
➤ 知识是主要短板,但很少产生幻觉。 其 AA-Omniscience 准确率为 21.1%,是我们所比较的同等智能水平模型中最低的,而 Claude Haiku 5.5(max)为 34.7%,Gemini 3.8 Flash(high)为 50.5%。这主要是因为它对 64% 的问题拒绝作答,从而将其幻觉率保持在 17.4%,仅为 Claude Haiku 5.5(max)的一半
其他细节:
➤ 定价: 每 100 万 token 输入 0.004 / 输出 $0.50 ➤ 推理强度: 结果以 max 强度展示,xhigh 也显示在智能与成本图表中 ➤ 可用性: Meta 第一方 API 和 Muse Code
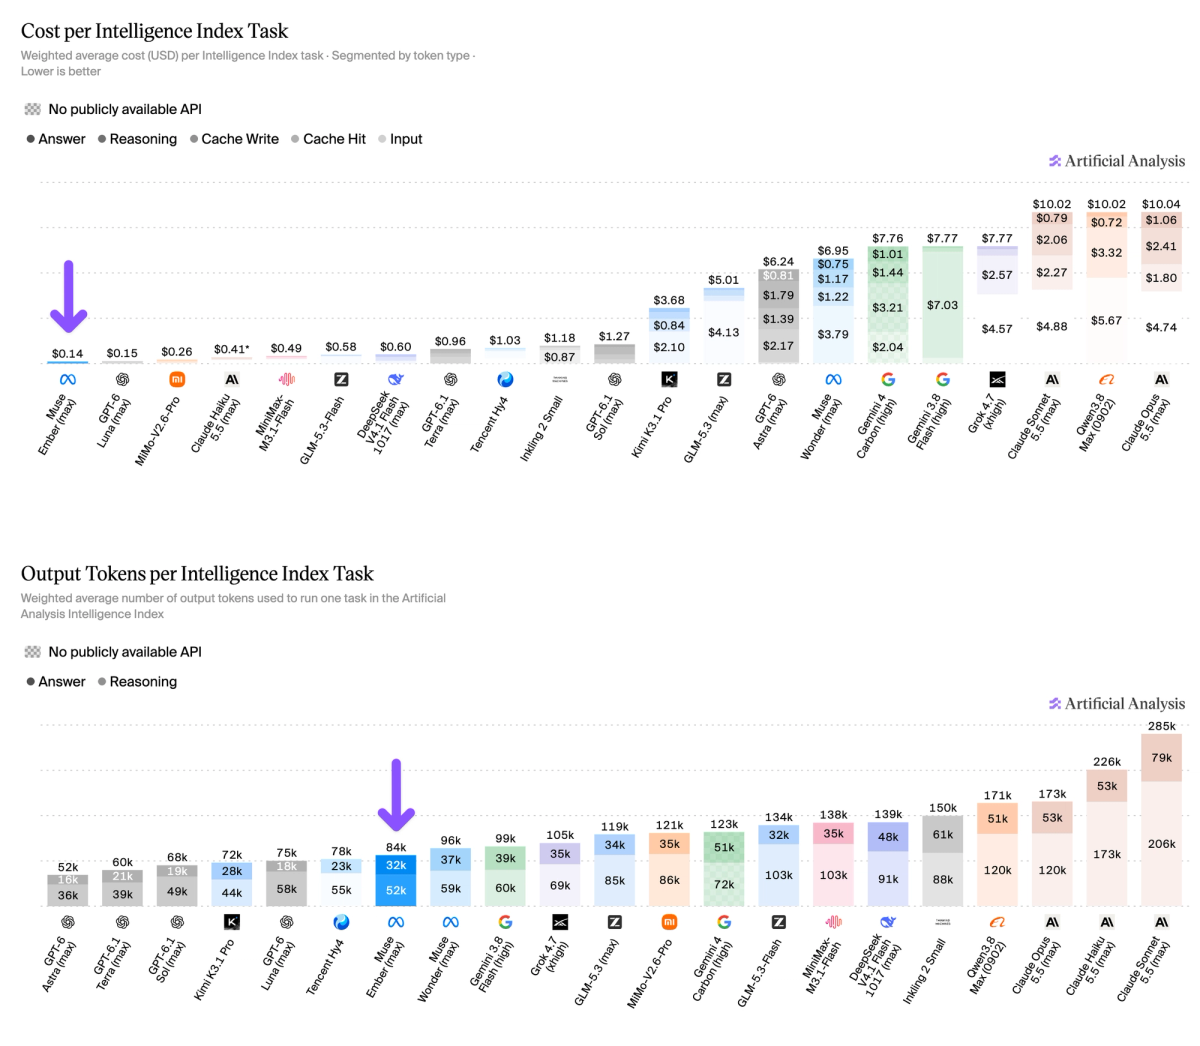
Muse Ember 的每任务成本低于同价位模型
Muse Ember (max) 的输入和输出 token 价格与 Claude Haiku 5.5 (max) 和 GPT-6 Luna (max) 相同,但其缓存输入的价格便宜 60%,而缓存输入在我们的 agentic 评测中占据了大部分成本。Muse Ember (max) 使用的输出 token 数量也大约只有 Claude Haiku 5.5 (max) 的三分之一
Muse Ember 最突出的 agentic 成绩是 AutomationBench-AA,得分 68.1%,与 Muse Wonder 和 GPT-6 Astra 持平
Agentic 编程表现参差不齐。Muse Ember 在 Terminal-Bench 4.0 上击败 Claude Haiku 5.5(40.9% 对 32.8%),但在 FrontierCode 2.0 上落后于它(27.2% 对 34.9%)
作为编程 agent,Muse Ember 领先于价格相近的模型
在 Muse Code 中,它在 Artificial Analysis Coding Agent Index 上得分 46,领先于 Claude Code 中的 Claude Haiku 5.5(37)和 Codex 中的 GPT-6 Luna(31)。其领先优势来自 SWE-Atlas-QnA-AA 和 Terminal-Bench 4.0,而在 FrontierCode 上它落后于 Claude Haiku 5.5,这与它在我们的 Intelligence Index 上的表现一致
知识是 Muse Ember 的主要短板,但它很少产生幻觉
其 AA-Omniscience 准确率为 21.1%,是我们所比较的同等智能模型中最低的,主要原因是它对 64% 的问题拒绝作答。这使其幻觉率保持在 17.4%,仅为 Claude Haiku 5.5 的一半
Muse Ember (max) 的完整 Artificial Analysis Intelligence Index 结果