Artificial Analysis (@ArtificialAnlys) · 2026/10/21 23:53:56
MLCR-AA 更新:Claude Sonnet 5.5 与 GPT-6 Astra 并列医疗长文本推理榜首
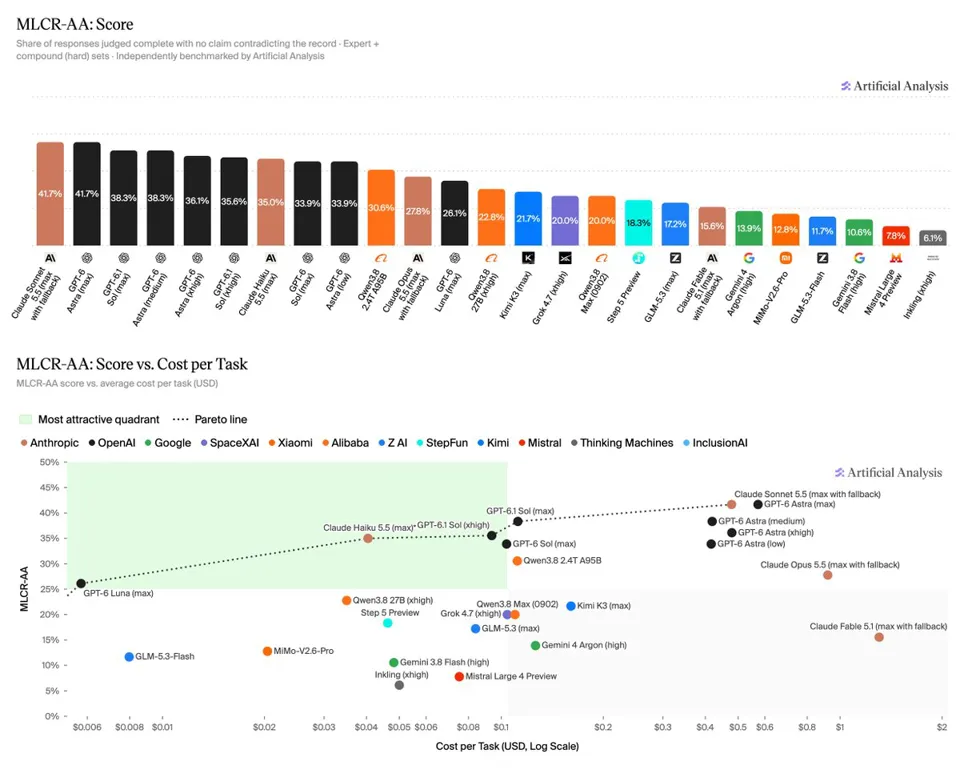
Artificial Analysis 更新了 MLCR-AA 榜单,采用更贴近实际病历审查的提示词与三模型评审机制。Claude Sonnet 5.5 和 GPT-6 Astra 以 41.7% 的通过率并列第一,但整体表现显示医疗长文本推理远未被解决,中位模型通过率不足 15%。Qwen3.8 2.4T A95B 领跑开源权重模型。
报道全文原始报道全文
Artificial Analysis (@ArtificialAnlys) · 2026-10-21 15
我们更新了 MLCR-AA,即针对 Wisedocs 医疗长上下文推理(Medical Long Context Reasoning)基准测试的排行榜。目前,Claude Sonnet 5.5 和 GPT-6 Astra 并列第一。
我们更新了 @wisedocsai 基准测试中 MLCR-AA 对模型的提示(prompt)和评分方式,以更好地反映实际医疗病历审查的工作流程。现在,模型被设定为“病历审查员”的角色进行提示,并被要求用一段话回答问题的每个部分,给出结论以及来自病历的支持性证据。答案由一个新的三模型评审团(judge panel)进行评分,并且我们对照原始病历审查了全部 60 个专家参考答案,其中优化了 15 个。
来自 @AnthropicAI 的 Claude Sonnet 5.5(max 模式带 fallback)和来自 @OpenAI 的 GPT-6 Astra(max 模式)以 41.7% 的成绩并列榜首,紧随其后的是 GPT-6.1 Sol(max 模式),成绩为 38.3%。来自 @Alibaba_Qwen 的 Qwen3.8 2.4T A95B 是表现最好的开源权重模型,成绩为 30.6%。
更新后的 MLCR-AA 关键结果如下:
➤ 医疗病历审查远未被解决: 只有当答案既完整又准确时才算通过,没有任何模型能通过超过 42% 的问题,且中位数模型的通过率低于 15%。
➤ Anthropic 模型在完整性方面领先,能够凭借正确的医学推理得出专家结论: 在我们测试的所有模型和努力程度(effort level)中,Claude 系列模型占据了前 18 名的完整性得分,其中 Claude Sonnet 5.5(max 模式带 fallback)以 64.8% 居首。表现最好的非 Anthropic 模型是 GPT-6 Astra(max 模式),得分为 42.2%。
➤ OpenAI 模型在准确性方面领先,引用病历时无夸大或幻觉: OpenAI 模型占据了前 27 名的准确性得分,其中 GPT-6.1 Sol(max 模式)以 96.7% 居首,但其完整回答问题的比例较低:GPT-6.1 Sol(max 模式)仅在 40.0% 的问题上实现了完整回答。
我们要感谢 Wisedocs 构建了 MLCR,并感谢他们与 Artificial Analysis 的合作。