GitHub 发布 Copilot Fusion 编排多模型平衡性能与成本
GitHub 推出 Copilot Fusion,这是一种运行时编排系统,能动态协调 Anthropic 和 OpenAI 的多个模型以优化任务表现。基准测试显示,其最大设置模式在编码代理指数中仅比 Claude Opus 5.5 低 2 分,但单任务成本降低约 51%($5.59 vs $11.42),为开发者提供了高性价比的近前沿能力选择。
报道正文
本文目录5 个章节
2026 年 10 月 28 日
GitHub 在 GitHub Copilot 中发布了 Copilot Fusion,该系统可协调 Anthropic 和 OpenAI 的模型。在 Coding Agent Index 中,其得分比 Claude Code 中的 Opus 5.5 低 2 分,但每个任务的成本仅为后者的一半
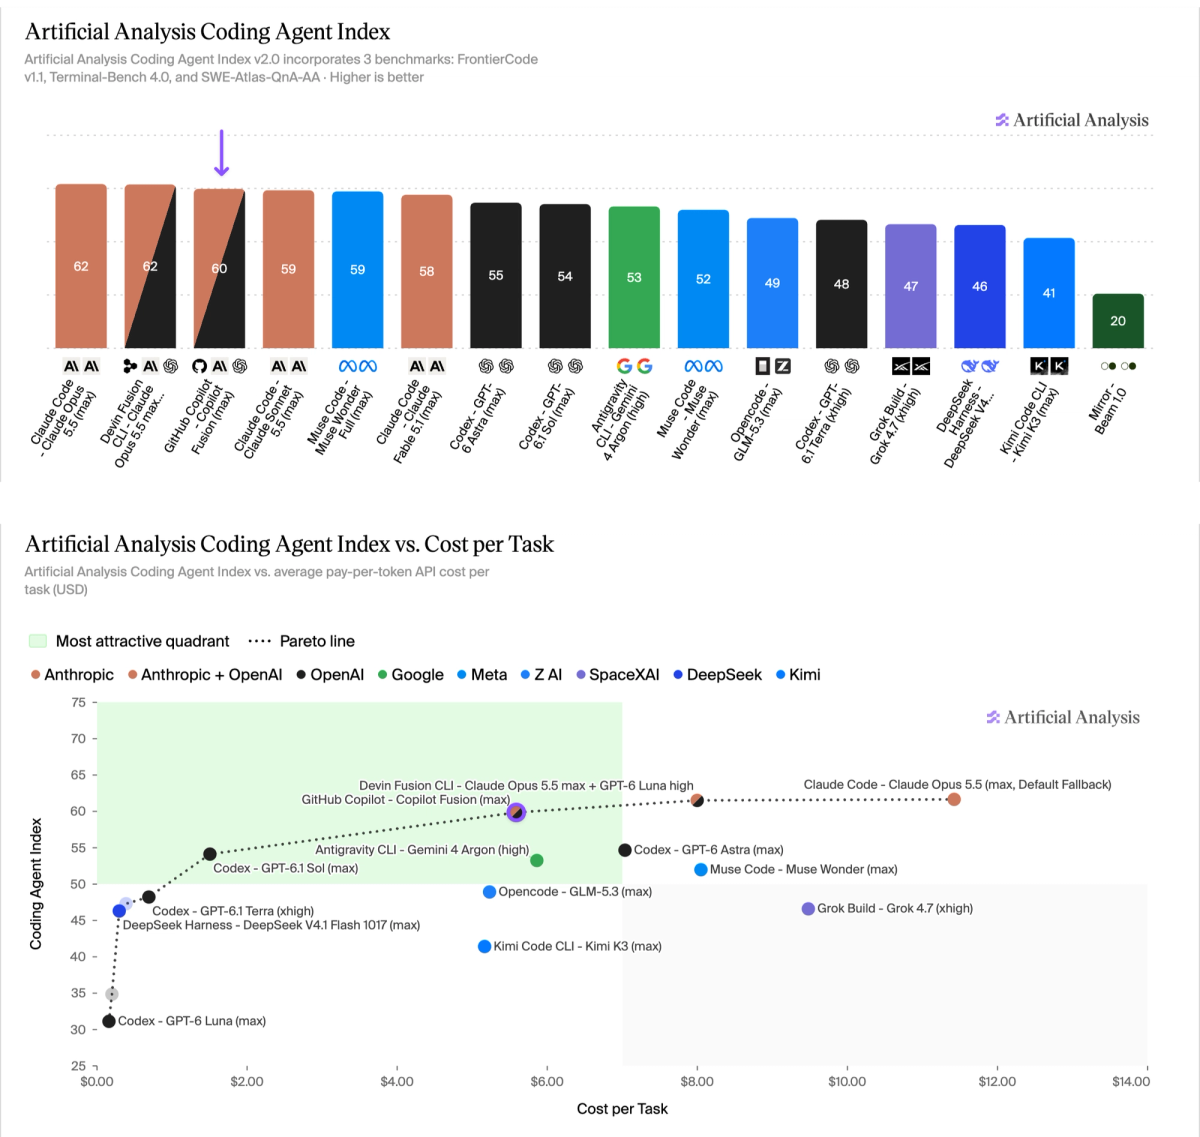
GitHub 将 Copilot Fusion 描述为一种运行时编排系统,它通过选择和协调模型来针对每个任务优化性能、成本和延迟。Copilot Fusion 会在来自 Anthropic 和 OpenAI 的多个模型中进行选择,包括 Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Astra 和 GPT-6 Sol。我们在 Artificial Analysis Coding Agent Index v2.0 中对 GitHub Copilot CLI 中的最高设置进行了基准测试。
Token 成本根据完成请求所使用的底层模型进行计费。
关键要点:
➤ 以接近前沿的性能实现高性价比: GitHub Copilot 中的 Copilot Fusion 每个任务花费 $5.59,而使用 Opus 5.5(max)的 Claude Code 每个任务花费 $11.42。使用 Opus 5.5(max)+ GPT-6 Luna(high)的 Devin Fusion 得分为 62,每个任务花费 $8.00。
➤ 在 Terminal-Bench 4.0 中略微领先: Coding Agent Index v2.0 对其三个组成基准测试赋予同等权重。GitHub Copilot 中的 Copilot Fusion 在 Terminal-Bench 4.0 中以 71 分领先。在图表所示的 FrontierCode 中,它排名第三,得分为 51,落后于使用 Opus 5.5(max)的 Claude Code(56 分)和使用 Opus 5.5(max)+ GPT-6 Luna(high)的 Devin Fusion(54 分)。其 SWE-Atlas-QnA-AA 得分较低,为 57,介于 Codex 中的 GPT-6 Astra 和 Antigravity CLI 中的 Gemini 4 Argon 之间。
➤ Token 用量仅为 Claude Code 中 Opus 5.5 的一半: 在 Coding Agent Index 中,GitHub Copilot Fusion 每个任务使用了 720 万 tokens,约为 Claude Code 中 Claude Opus 5.5 所用 token 量的一半,比使用 Opus 5.5(max)+ GPT-6 Luna(high)的 Devin Fusion 少 30%。
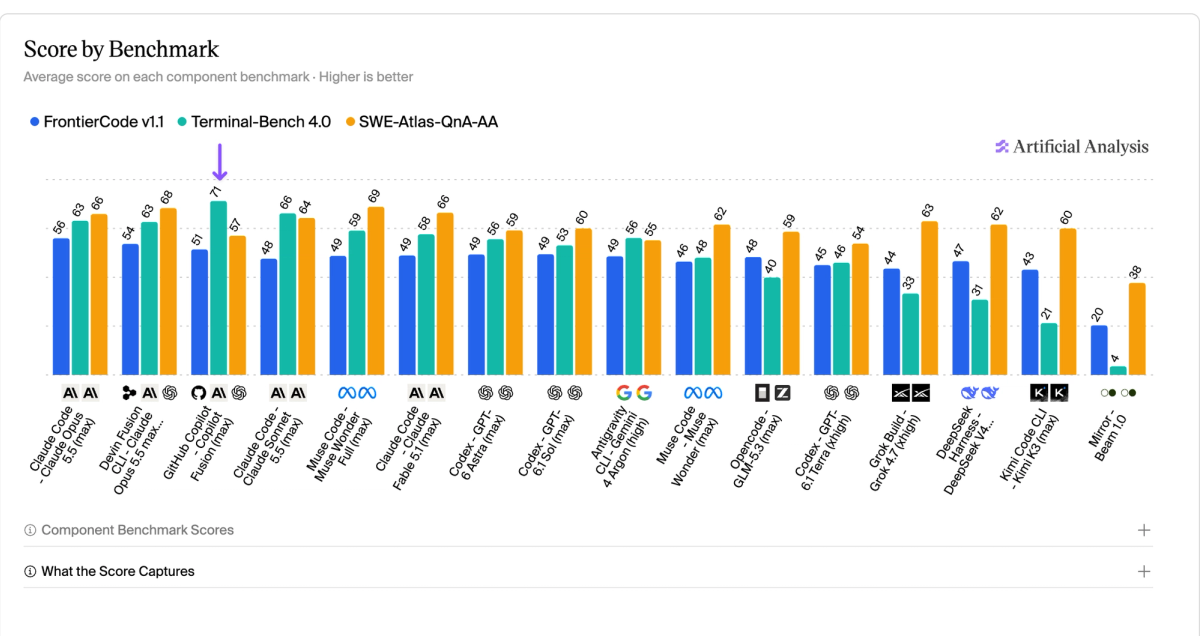
GitHub Copilot 中的 Copilot Fusion 在 Terminal-Bench 4.0 中以 71 分略微领先。在图表所示的 FrontierCode 中,它排名第三,得分为 51,落后于使用 Opus 5.5(max)的 Claude Code(56 分)和使用 Opus 5.5(max)+ GPT-6 Luna(high)的 Devin Fusion(54 分)。其 SWE-Atlas-QnA-AA 得分较低,为 57,介于 Codex 中的 GPT-6 Astra 和 Antigravity CLI 中的 Gemini 4 Argon 之间。
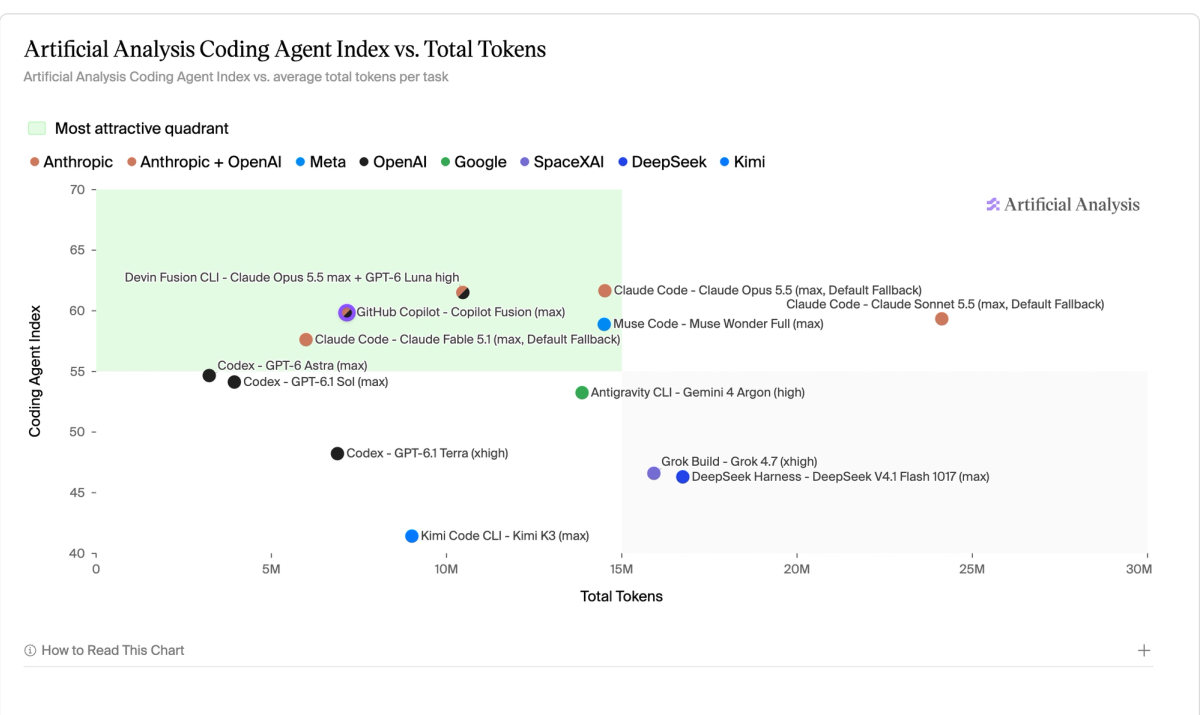
GitHub Copilot Fusion 在 Coding Agent Index 中每个任务使用了 720 万 tokens,约为 Claude Code 中 Claude Opus 5.5 所用 token 数量的一半。
探索 Coding Agent Index、任务成本及基准测试结果:
https://artificialanalysis.ai/agents/coding-agents?routers=true
阅读最新动态
[
Gemini 4 Carbon 成为 Artificial Analysis Intelligence Index v5 的新榜首
Google 的 Gemini 4 Carbon 成为 Artificial Analysis Intelligence Index v5 的新榜首,并在 Artificial Analysis Coding Agent Index 中仅次于 Claude Opus 5.5
October 28, 2026](https://artificialanalysis.ai/articles/gemini-4-carbon-new-number-1)[

发布 Artificial Analysis Intelligence Index v5
Index v5 包含 2 个新基准测试和 3 项升级。首次情况下,该指数的大部分构建基于私有数据集
October 27, 2026](https://artificialanalysis.ai/articles/artificial-analysis-intelligence-index-v5)[
Code2Video-AA:AI 模型通过代码设计视频的效果如何?
Artificial Analysis 实现了 HeyGen 的 Code2Video Bench,评估模型使用 HyperFrames HTML 根据 114 份设计简报创建简短产品和品牌视频的能力
October 26, 2026](https://artificialanalysis.ai/articles/code2video-aa){"@context":"https://schema.org","@type":"NewsArticle","headline":"GitHub Copilot Fusion 协调 Anthropic 和 OpenAI 模型以平衡性能与成本","description":"GitHub 在 GitHub Copilot 中发布了 Copilot Fusion,该功能可在 Anthropic 和 OpenAI 模型之间进行协调。在 Coding Agent Index(编码代理指数)中,其得分比 Claude Code 中的 Opus 5.5 低 2 分,但每项任务的成本仅为后者的一半","datePublished":"2026-10-28","dateModified":"2026-10-28","image":"https://cdn.sanity.io/images/6vfeftx9/articles/0968ba533e8f3599faae4925bcf3781fbbd52fed-1024x1024.webp?w=1200&auto=format","author":{"@type":"Organization","name":"Artificial Analysis","url":"https://artificialanalysis.ai"},"publisher":{"@type":"Organization","name":"Artificial Analysis","url":"https://artificialanalysis.ai"},"mainEntityOfPage":{"@type":"WebPage","@id":"https://artificialanalysis.ai/articles/github-copilot-fusion-orchestrates-anthropic-and-openai-models-to-balance-performance-and-cost"}}
