Rohan Paul (@rohanpaul_ai) · 2026/10/24 08:28:33
Meta 与 CMU 研究:RL 训练小模型工具选择优于超大模型
Meta 与卡内基梅隆大学最新论文显示,经过强化学习(RL)训练的 Qwen3-8B 小模型在工具选择任务上表现优于提示工程优化的 402B Llama-4-Maverick。该研究提出将请求分解为步骤并结合关键词搜索的策略,在 ToolBench 基准测试中准确率达到 41.5%,显著高于大模型的 30.6%。这一发现表明,在大规模工具目录场景下,专用小模型可替代昂贵的大模型进行高效决策。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-24 00
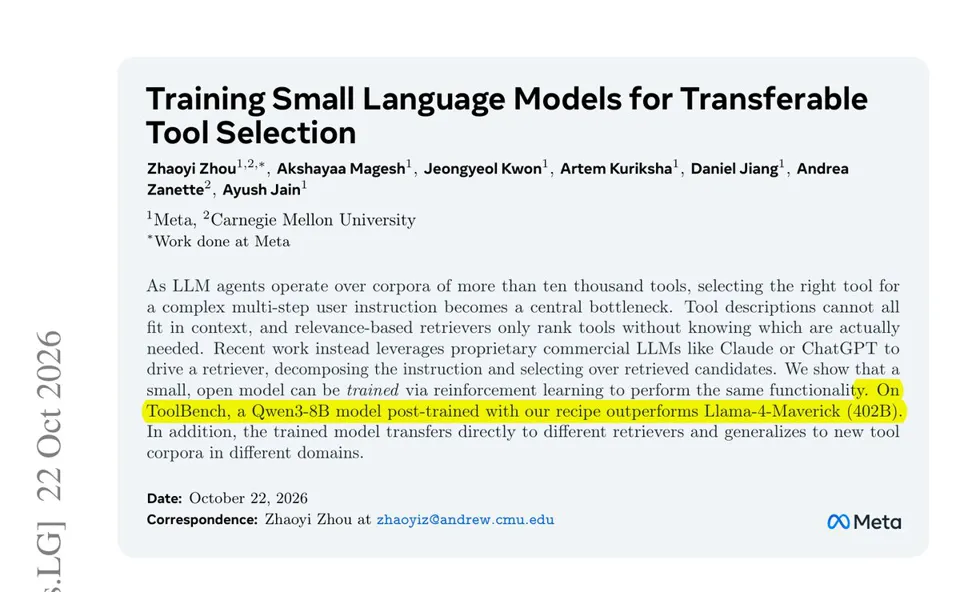
Meta 与卡内基梅隆大学(Carnegie Mellon)的新论文发现,经过 RL(强化学习)训练的小模型在工具选择上的准确率高于通过 Prompt 引导的 402B Llama-4-Maverick。
Agent 可能面临超过 10,000 个工具,且这些工具的描述无法全部放入上下文窗口中。检索器仅按相关性排序,因此近期的方案通常让 Claude 或 ChatGPT 来挑选工具。
研究人员对 Qwen3 模型进行了训练,使其能够将请求拆分为多个步骤,使用简单的关键词搜索检索每个步骤,并为每个步骤选择一个工具。训练过程首先利用教师模型生成的示例,随后采用 RL,奖励那些有用的搜索步骤和精确的工具选择。
在 ToolBench 基准测试中,经过训练的 8B 模型有 41.5% 的时间能准确选中正确的工具,而 Maverick 最佳 Prompt 设置下的准确率仅为 30.6%。无需重新训练,该模型在 4 个新工具基准测试中的 3 个上超越了 Maverick,并且在配备更强的检索器时表现进一步提升。
如果你的 Agent 需要从庞大的工具目录中进行选择,一个经过 RL 训练的小模型可以替代通过 Prompt 引导的大模型来处理选择任务。