Rohan Paul (@rohanpaul_ai) · 2026/10/12 23:39:55
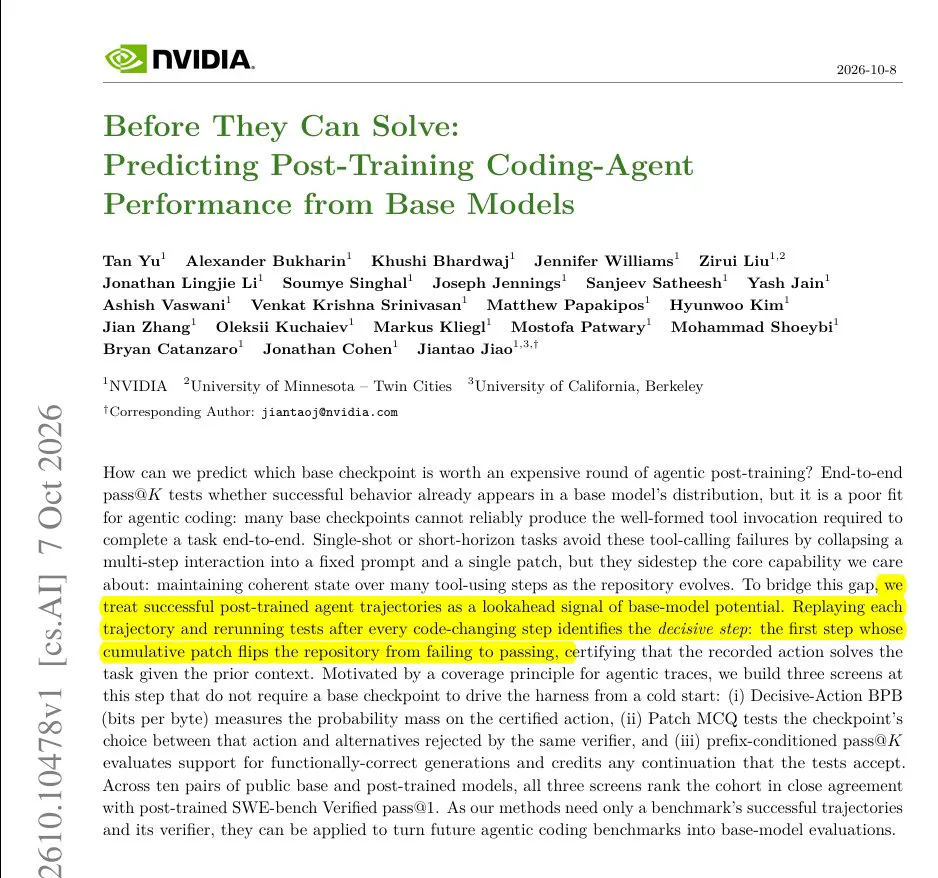
Nvidia 提出基座模型代理能力新评估法:仅测首个通过测试的编辑步骤,Spearman 相关系数达 0.964
出处作者 / 发布主体:Rohan Paul (@rohanpaul_ai)原标题:New Nvidia paper shows scoring base models on every step of an agent run works worse than scoring th...
78AI 研判分
核心综述
Nvidia 最新论文指出,在智能体运行中逐步评分基座模型效果不佳,而仅在“首次使测试通过的编辑”这一决定性步骤进行评分能更准确预测后训练表现。该方法通过重放成功轨迹并定位关键编辑点,实现了与 SWE-bench Verified 分数高达 0.964 的排名一致性,为低成本筛选适合后训练的基座模型提供了高效验证手段。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-12 15
Nvidia 最新论文表明,在 Agent 运行的每一步对基础模型进行评分,效果不如仅在首次使测试通过的编辑步骤上进行评分。
后训练(Post-training)成本高昂,因此选择合适的基础模型至关重要。然而,现有的 Agent 基准测试中基础模型的得分几乎为零,且简单的编码测试也难以预测后续的 Agent 技能表现。
他们复现了一个强大 Agent 的成功运行轨迹,并在每次编辑后重新运行测试,以找出首个使测试通过的编辑。在这个决定性步骤上,他们测试基础模型是否倾向于该编辑、能否从失败的编辑中选出它,以及能否自行写出一个能通过测试的编辑。
根据各基础模型写出该特定编辑的可能性进行排名,所得结果与这些模型经过后训练后的 SWE-bench Verified 分数高度一致,相关性系数达到 0.964。
在为 Agent 任务选择用于后训练的基础模型时,请先执行此项检查。该方法仅需基准测试中的成功 Agent 运行轨迹及其对应的测试用例。