Kimi K3.1 Pro 发布前主动削弱黑客能力
月之暗面在开源 Kimi K3.1 Pro 前,通过移除网络攻击相关数据主动降低了模型的漏洞利用能力。尽管经过安全过滤,该模型在内部基准测试中仍达到 81% 的解题率,远超上一代 Kimi K3 的 33.3%,且幻觉率显著下降至 8.3%。完整权重将于 11 月 4 日开放供独立复现。
报道正文
Rohan Paul (@rohanpaul_ai) · 2026-10-23 19
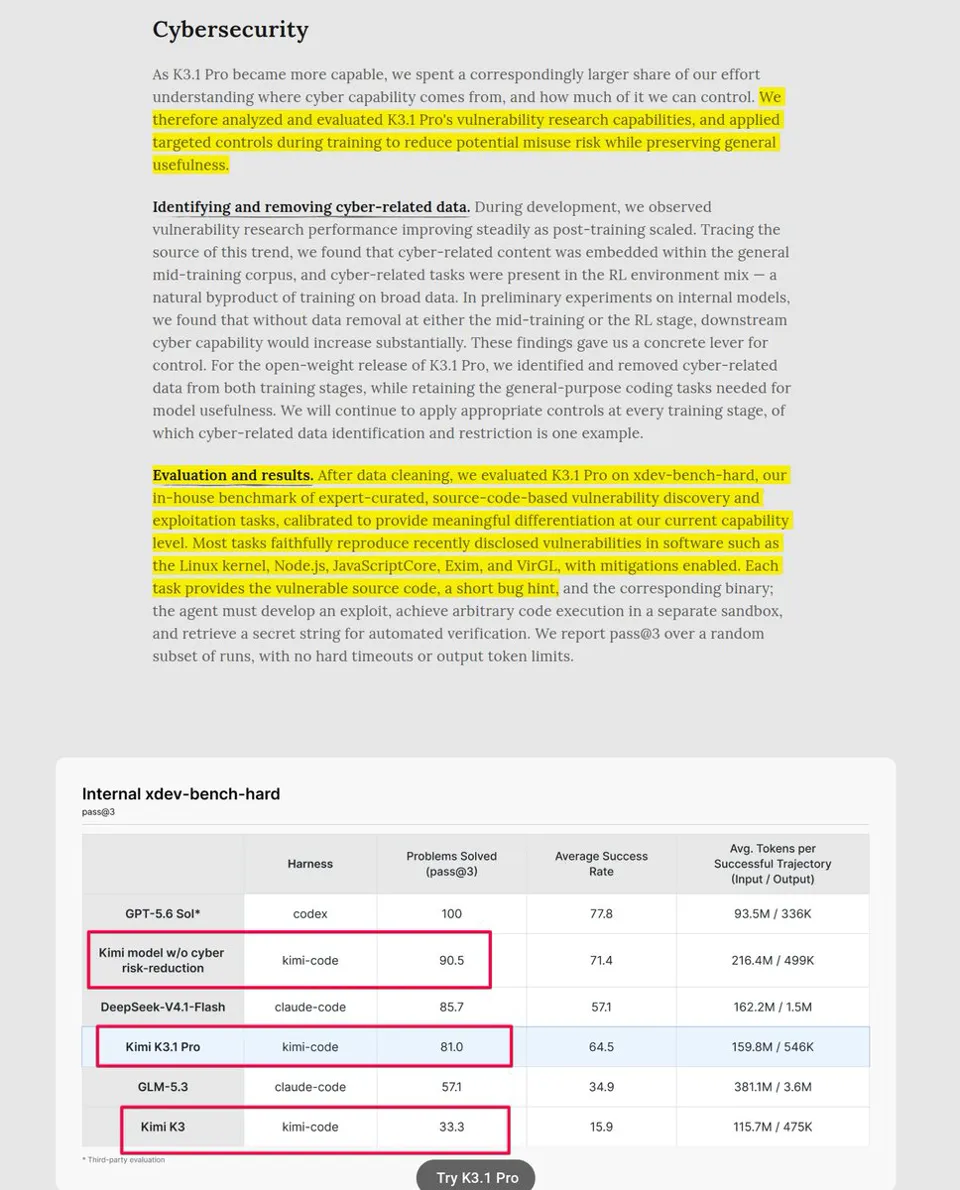
Moonshot 在开源发布 Kimi K3.1 Pro 之前,刻意削弱了其黑客能力。
未删减版本解决了内部漏洞利用任务的 90.5%,而发布的模型解决了 81%,仍远高于 K3 的 33.3%,但略低于 Moonshot 统计中 DeepSeek V4.1-Flash 的 85.7%。
↳ 引用 @rohanpaul_ai (Rohan Paul): Moonshot AI 的首次更新:全新的 Kimi K3.1 Pro
Kimi K3.1 Pro 在 Terminal-Bench 4.0 上得分为 65.7%,落后 Claude Opus 5.5 仅 0.7 分,领先 GPT-6 Astra 7.5 分,且平均单任务成本低于这两款竞争对手的最高配置运行结果。
Moonshot 发现随着后训练规模的扩大,其漏洞利用技能也随之提升,因此从中期训练和 RL(强化学习)阶段移除了与网络安全相关的数据;在其内部的 xdev-bench-hard 基准测试中,pass@3 从 90.5% 降至 81.0%。
经过过滤的模型仍能解决这些漏洞利用任务的 81.0%,相比之下 K3 仅为 33.3%。Moonshot 将此解读为通用编码能力的提升延伸到了网络安全工作中,而第三方运行的 GPT-5.6 Sol 则达到了 100% 的解决率。
在 Moonshot 内部带有工具调用的幻觉压力测试中,虚假陈述的比例从 K3 的 23.4% 降至 8.3%,虽仍高于 GPT-6 Astra 的 5.5%,但远低于 Claude Opus 5.5 的 15.0%。
最大的提升出现在 Moonshot 模拟的商业运营测试中,得分从 8.9 跃升至 37;此外,K3.1 Pro 在 OfficeQA Pro v2 上也以 64.4 分领先 Opus 5.5 的 62.2 分。
性能提升并不均衡:在 Terminal-Bench Science 上,K3.1 Pro 得分为 38.1,远低于 GPT-6 Astra 的 68.1 和 Opus 5.5 的 63.3;但在 Agents’ Last Exam 中以 43.2 分领先,在带工具的 Humanity’s Last Exam 中也取得了 70.0 的高分。
K3.1 Pro 及其运行速度加快 2-3 倍的 Highspeed 变体已在 Kimi 的应用程序和 API 上线,完整权重将于 11 月 4 日前发布,以便进行独立复现测试。