Liquid AI 开源 7400 万参数流式音频编解码器
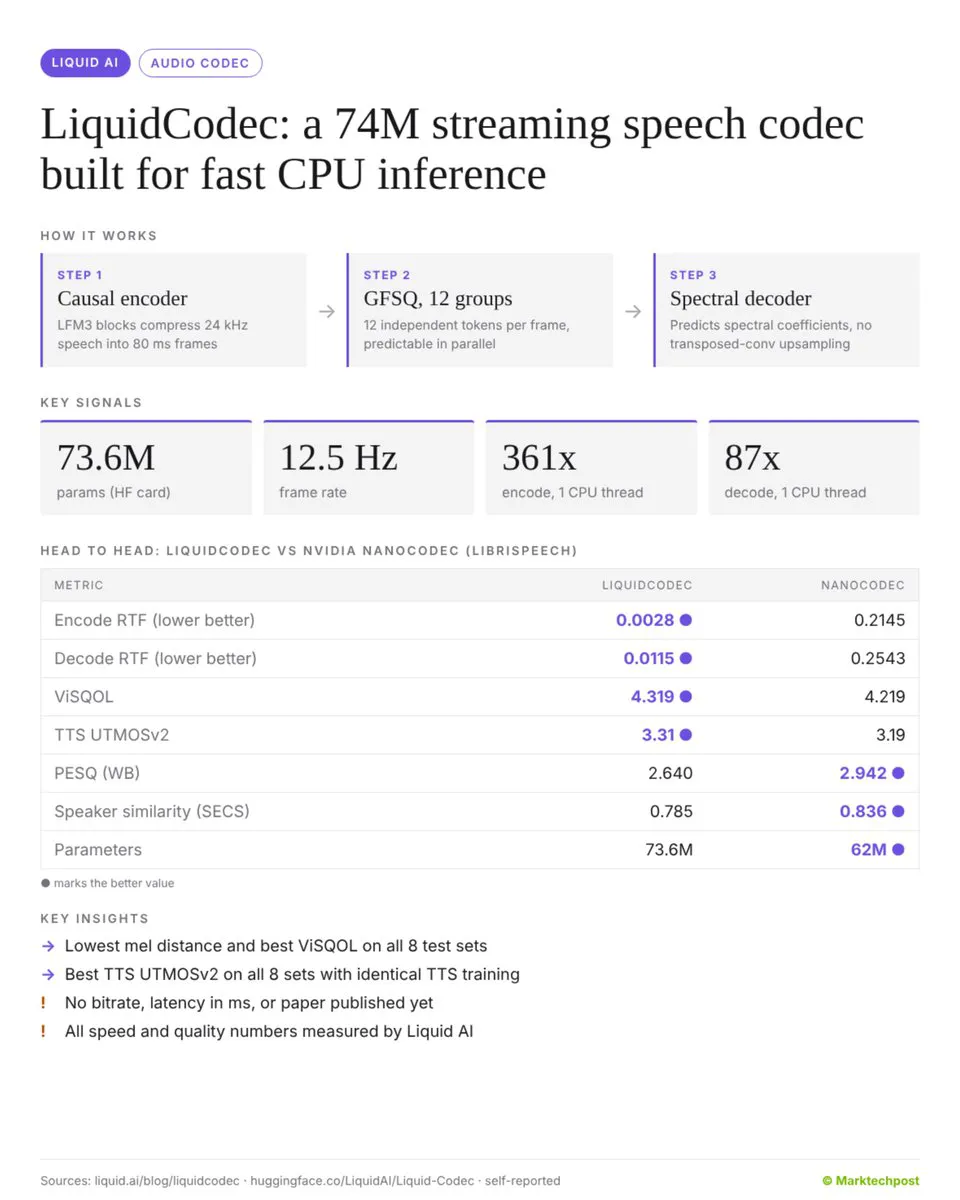
Liquid AI 发布 LiquidCodec,一个约 7400 万参数的流式音频编解码器,将语音转为语言模型可预测的 token 再还原为音频,已用于 LFM3-Audio-2B 与 LFM3-Omni-2B。其核心创新是用分组有限标量量化(GFSQ)替代残差向量量化,每 80 毫秒帧生成 12 个独立 token 可并行预测,解码器直接预测频谱系数并跳过转置卷积上采样。在 Apple M4 Max 单 CPU 线程 FP32 下编码约 361 倍、解码约 87 倍实时,编码 RTF 0.0028 远优于 Kyutai Mimi 的 0.0361,并在全部 8 个测试集上取得最佳 ViSQOL 与 TTS UTMOSv2;但 PESQ 在 7/8 测试集上仍落后 NVIDIA NanoCodec,且未公布比特率与毫秒级延迟。权重已在 Hugging Face 开放,并提供 llama.cpp 的 GGUF 量化版本。
报道正文
▲ Marktechpost AI · 2026-11-12 22
▲ Liquid AI 刚刚发布了 LiquidCodec,这是一个约 7400 万参数的流式音频编解码器,可将语音转换为语言模型能够预测的 token,再还原回音频。它为 LFM3-Audio-2B 和 LFM3-Omni-2B 提供支持。
其核心思路是采用分组有限标量量化(GFSQ),而非残差向量量化。每个 80 毫秒的帧被转换为 12 个独立的 token,因此全部 12 个 token 可以并行预测。解码器直接预测频谱系数,跳过了转置卷积上采样。
在 Apple M4 Max 的单 CPU 线程上(FP32),其编码速度约为实时的 361 倍,解码速度约为实时的 87 倍。编码 RTF 为 0.0028,而 Kyutai 的 Mimi 为 0.0361。它在全部 8 个测试集上都取得了最佳的 ViSQOL 和 TTS UTMOSv2 成绩。不过这仍是一种权衡:NVIDIA 的 NanoCodec 在 8 个测试集中的 7 个上仍取得更高的 PESQ(WB)分数(LibriSpeech 上为 2.942 对 2.640),而且 Liquid AI 尚未公布比特率或以毫秒计的延迟。
权重已发布在 Hugging Face 上,并提供适用于 llama.cpp 的 Q4_0、Q4_K_M 和 Q8_0 GGUF 构建版本。Q4_0 将解码器缩小了 3.5 倍……
完整分析: