Rohan Paul (@rohanpaul_ai) · 2026/10/21 04:06:23
Meta 论文揭示主动助手核心瓶颈:时机判断而非内容生成
出处作者 / 发布主体:Rohan Paul (@rohanpaul_ai)原标题:New Meta paper shows that deciding on its own when to interrupt, not just what to say, is where proa...
78AI 研判分
核心综述
Meta 最新研究指出,主动式 AI 助手(如智能眼镜)的主要失败原因并非无法生成正确内容,而是难以自主决定何时介入。通过构建包含长期记忆与干扰项的 ProPerMem 基准测试,研究发现即使前沿模型在拥有明确证据时表现优异,但在自主判断触发时机时准确率骤降。该工作强调了“精准时机”与“克制触发”对提升主动代理实用性的关键作用。
报道全文原始报道全文
Rohan Paul (@rohanpaul_ai) · 2026-10-20 20
Meta 最新论文表明,主动式助手失败的关键在于自主决定“何时打断”,而不仅仅是“说什么”。
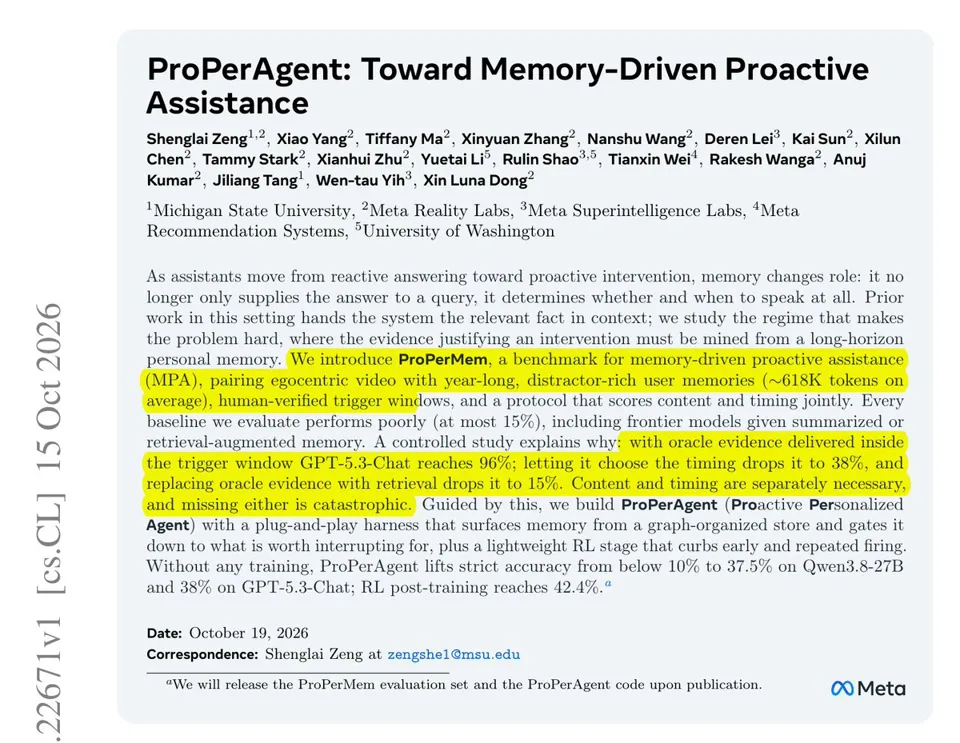
像 AI 眼镜这样的主动式助手不会收到明确查询。它们必须通过从长达一年的个人记忆中寻找支撑事实(而非被动接收信息),自行决定何时发言以及说什么。
他们构建了 ProPerMem:将第一人称视频与包含大量干扰项、平均长度为 618K token 的年度记忆配对,并设有经人工验证的触发窗口。只有当助手在窗口内的恰当时机发言且内容有据可依时,该片段才被视为有效。
所有基线模型得分最高仅为 15%,即使是具备检索增强记忆的前沿模型也是如此。如果在窗口内提供“上帝视角”证据,GPT-5.3-Chat 可达 96%;但若让其自主选择时机,准确率降至 38%;若使用检索机制,则进一步降至 15%。
对于主动式助手而言,需同时确保内容与时机准确,并谨慎触发,这将使准确率从低于 10% 提升至 42.4%。